テキストから動画AI:プロンプトひとつでクリップに、必要なときは同じキャラクターで - RefVid
起きることを書くだけで数分で動画に · 最初の動画は無料、透かしなし
最初の動画は無料・カード不要
はい、RefVidは言葉だけで動画を作れます。ショットに誰がいて、どこで起きて、カメラがどう動くかを書けば、モデルがその説明からすべてを描きます。Kling 4、Kling 3.0 Omniをはじめスタジオのほとんどのモデルで使え、カード登録なしで無料から始められ、透かしも入りません。プロンプトはクリップのたびに被写体を新しく作り直すので、人物や商品を再登場させたいときは写真を1〜5枚追加しましょう。同じプロンプトのまま、その被写体が保たれます。
写真なし、プロンプト3つ
テキストから動画を作るAIの仕組み
- テキストから動画を作るモデルは、プロンプトを読み取り、そこからすべてのフレームを生成します。人物も、場所も、光も、カメラの動きもです。画像を動かしているわけではありません。だからこそアイデアからクリップまでの最短ルートであり、同時にクリップごとに被写体が変わってしまう理由でもあります。
- 言葉が表すのは「タイプ」であって、特定の人物ではありません。「20代後半、銅色がかった赤のボブヘアでそばかすのある女性」に当てはまる顔は何千とあり、モデルは実行のたびにそのうちの一つを選びます。単発のショットや雰囲気づくり、Bロールなら問題ありません。しかしシリーズや広告、同じ顔が繰り返し登場するストーリーでは問題になります。
RefVidの動画生成AIを無料で:言葉だけで始める
- エレメントを選ばずにスタジオを開き、プロンプトを書いて「生成」を押します。モデル、長さ、画面比率(16:9、9:16、1:1)、音声の有無は自分で選べます。クリップはたいてい2〜10分で完成して動画一覧に届き、透かしなしでそのままダウンロードできます。
- 長さはモデルによって異なります。デフォルトのKling 4では3〜30秒、Kling 3.0 Omniでは最大15秒です。ショット全体をプロンプトで伝える必要があるため、参照写真を前提に書くプロンプトより長くなります。
Kling text to videoとほかのモデル
- Kling 4とKling 3.0 Omniはどちらもテキストから動画を作るモードを備えており、「テキストのみ」を選ぶとRefVidはこのモードを使います。Kling 4は常に音声付きで最長30秒、Kling 3.0 Omniはより安価で、無音のクリップも作れます。
- Seedance 2.5、Wan 3.0、Gemini Omni Flash、PixVerse C1、Happy Horse 1.1も言葉だけでクリップを作れます。例外はVidu Q4で、RefVidでは被写体ありでしか使えません。同じプロンプトを2つのモデルで試せば、そのシーンにどちらが合うかすぐにわかります。
言葉だけで作る動画のプロンプト例
- 言葉だけで動画を作るときの良いプロンプトは、被写体を具体的に描写し、動作を一つに絞り、カメラの位置と動きを示します。光とレンズは最後です。こだわらない要素は省きましょう。細部を一つ足すたびに、モデルはそれを数秒の中に収めなければなりません。
- キャラクターの例:「20代後半の女性。銅色がかった赤のボブヘアにまっすぐな前髪、薄いそばかす、オリーブグリーンのユーティリティジャケット姿で、ゴールデンアワーの風の強いビーチに立っている。海を眺めてから、ちらりとカメラを見る。ミディアムショットからクローズアップへのゆっくりしたプッシュイン、暖かい逆光。」
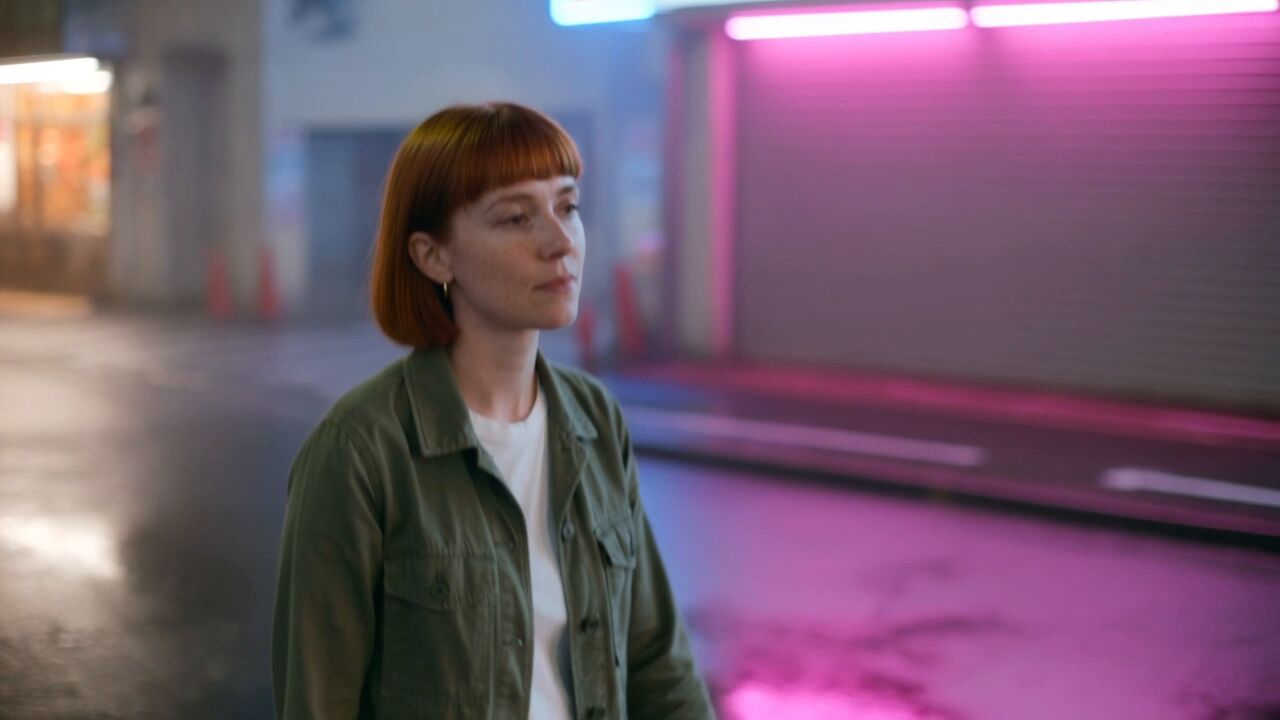
- トラッキングカメラの例で、このページ冒頭のクリップの元になったプロンプトです:「…小雨の降る夜、ネオンに照らされた東京の路地を歩く。濡れたアスファルトにピンクと青のネオンが映り込む。彼女が歩くのに合わせ、カメラは肩の高さで横に並び、滑らかなラテラルドリーで追う。シネマティック、浅い被写界深度。」
同じキャラクターを再登場させたいとき
写真を追加しましょう。RefVidはまさにそのために作られています。人物や商品を1〜5枚の写真から一度保存すれば、どんなプロンプトでもその顔、服装、ロゴ、ラベルが保たれます。プロンプトはシーンを描写するだけでよく、被写体は写真から取られるので、どんな場所でも、写真にない角度からでも描かれます。
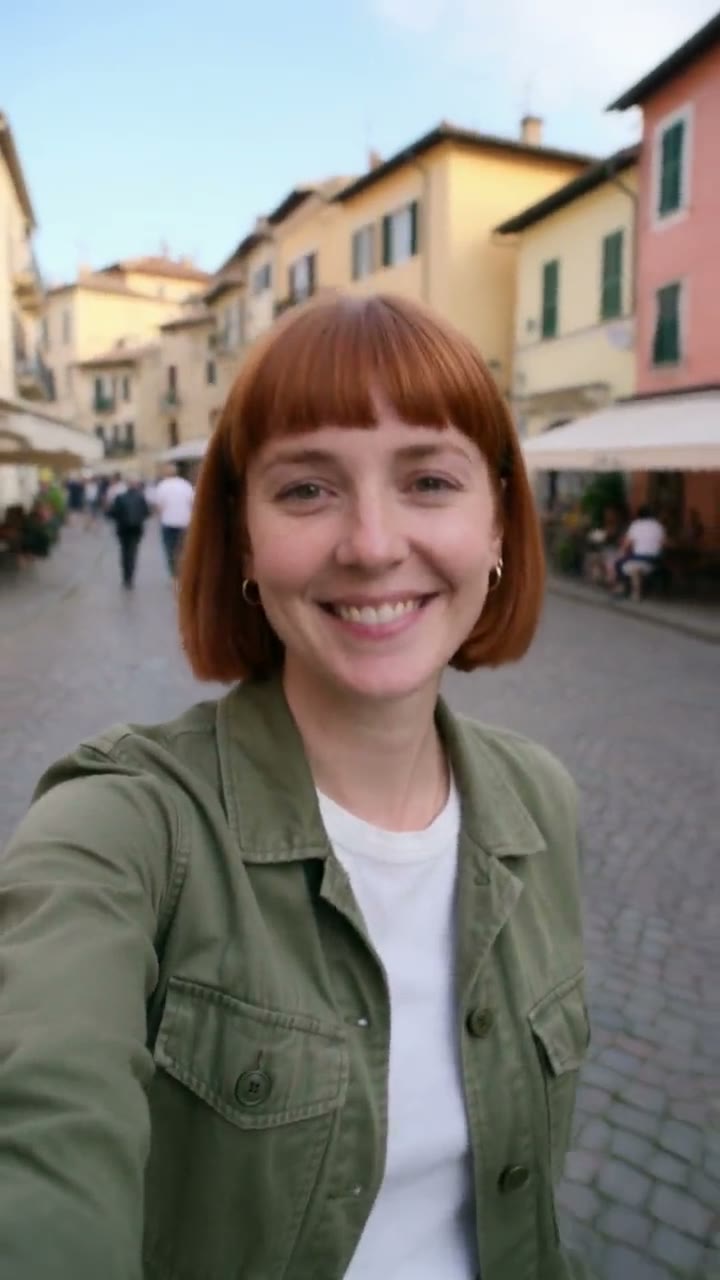
下は、ページ上部と同じ3つのシーンを同じモデルでもう一度作ったものです。今度は言葉での描写の代わりに彼女の写真4枚を使っています。上部ではクリップごとに別の女性になりますが、下では同一人物です。
参照写真4枚
無料で始められて、透かしなし
- 言葉だけで作る動画も被写体ありの動画と同じクレジットで作れ、新規アカウントは無料で始められます。新規アカウントには5秒のKling 3.0 Omni動画が1本無料で付き、カード登録は不要です。無料クレジットは無音のクリップ用で、音声付きには有料クレジットが必要です。
- どの動画も、モデルが作ったままのクリーンなファイルを透かしなしでダウンロードできます。無料でも有料プランでも同じです。クリップを一か所にまとめて保存できるよう、Googleまたはメールで無料アカウントを作成していただく必要があります。
使う前にクリップを確認する
- 投稿する前に、どのクリップもフルサイズで見てください。手、動いているときの顔、画面内の文字は、今でもモデルがもっとも間違えやすい部分です。ある生成がおかしく次はうまくいったなら、それは偶然です。プロンプトを書き直す前に、同じプロンプトでもう一度生成してみましょう。生成した人物を実在の人物として見せてはいけません。
ほかの使い方ガイド
よくある質問
テキストから動画AIを無料で、透かしなしで使えるサービスはありますか?
あります。RefVidはカード登録なしで無料から始められ、無料でも有料でも動画に透かしが入ることはありません。無料クレジットではKling 3.0 Omniで短い無音クリップを作れます。長いクリップや音声付きには有料クレジットを使います。
プロンプトから動画を作るには登録が必要ですか?
はい、Googleまたはメールでの無料アカウントが必要です。カード登録は不要です。クリップとプロンプトはそこに保存されるので、あとからダウンロードしたり、プロンプトを使い回したりできます。
Kling text to videoはどのモデルを選べばいいですか?
品質を最優先し、最長30秒のクリップや音声が欲しいならKling 4です(音声は常に付きます)。最長15秒のクリップを安く作りたいならKling 3.0 Omniで、音声の有無も選べます。どちらも同じプロンプトで生成できます。
プロンプトに書いた人物は、次のクリップでも同じ見た目になりますか?
たいていはなりません。一つの描写に当てはまる顔は数多くあり、モデルは毎回そのうちの一つを選びます。人物や商品をクリップ間で同じに保つには、1〜5枚の写真から保存し、「テキストのみ」の代わりにそれを選んでください。
プロンプトから作るクリップは何秒まで作れますか?
Kling 4では3〜30秒、Kling 3.0 Omniでは最大15秒です。長いストーリーは、5〜10秒のショットを複数つなげたほうがうまくいきます。
執筆:Louis Chi