マルチリファレンス動画生成ツールの比較
マルチリファレンス動画生成ツールは、登場させたい人物・商品・場所を写した複数の画像(場合によっては動画や音声のクリップ)を読み込み、それらを保ったまま新しいシーンを生成します。2026年10月時点で、このモードに対応する主なモデルは、Kling 3.0 Omni、Kling 4.0、Google Veo 3.1、ByteDance Seedance 2.5、MiniMax H3です。モデルごとに上限は大きく異なり、それを基盤にしたツールも様々です。本ページでは、各モデルが受け付ける内容と、ツール選びで確認すべき点を整理します。
参照画像をアップロードMia:写真4枚
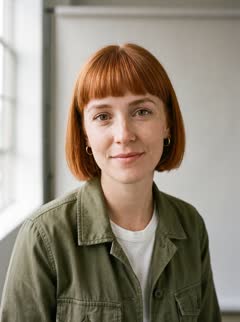
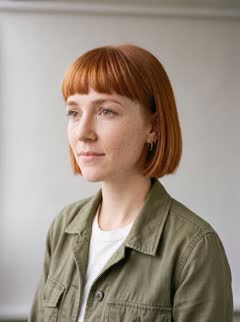
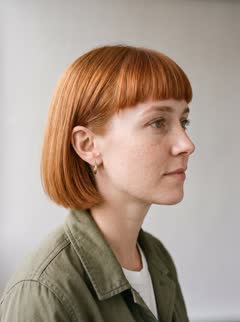
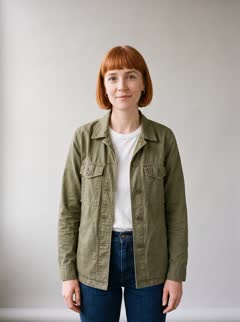
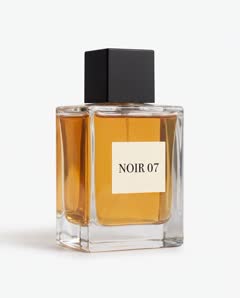
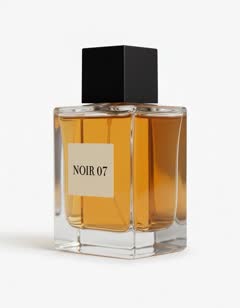
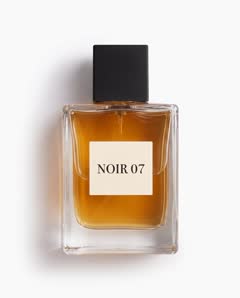
NOIR 07:写真3枚
マルチリファレンスと画像からの動画生成の違い
画像からの動画生成は、1枚の画像を最初のフレームとして動画を作ります。そのフレームは正確に再現されますが、それ以降はモデルが画像に写っていない部分を補うため、安定性は下がります。
マルチリファレンス生成は、最初のフレームを固定しません。すべての画像をまとめて被写体の説明として読み取り、そこから新しいカットを構成します。そのため実用面では次の3つの効果があります。写真に写っていない角度から被写体が現れること、複数の被写体がそれぞれ自分の参照画像を使って1つのカットに登場できること、同じ参照画像をすべてのシーンで再利用でき、シリーズ全体の統一感を保てることです。
一方で、最初のフレームを厳密に指定することはできません。参照画像と開始フレームを組み合わせられるモデルもありますが、対応していないモデルもあります。
参照写真3枚
各モデルの入力仕様(2026年10月時点)
Kling 3.0 Omni:Klingのガイドによると、参照画像または要素を最大7つ、もしくは3〜10秒の参照動画1本と画像・要素を最大4つ受け付けます。クリップは最長15秒で、720pまたは1080pに対応します。要素には声を紐づけることもできます。KlingのAPIとfal.aiで利用できます。
Kling 4.0:Klingのガイドによると、参照入力は合計最大15個で、画像は最大10枚、動画は最大5本(合計30秒)、要素は最大7つ、クリップは3〜30秒です。2026年10月15日にKlingのアプリで公開されました。APIは近日公開予定とされています。
Veo 3.1:Googleのドキュメントによると、1人の人物・キャラクター・商品について参照画像を最大3枚受け付けます。参照クリップは8秒で、16:9または9:16に対応します。Googleはこの機能を「Ingredients to Video」と呼んでいます。Veo 3.1 Liteは参照に対応していません。
Seedance 2.5とMiniMax H3:どちらも複数の画像参照に対応しており、提供元によっては動画や音声の参照も受け付けます。公開されている上限は提供元によって大きく異なり、Seedance 2.5は約9〜30枚、MiniMax H3は5〜9枚です。利用する提供元の正確な上限を確認してください。
参照は多いほど良いわけではない
上限が大きいと、1つのカットに複数の被写体を入れる場合に役立ちます。ただし、1人のキャラクターだけであれば、枚数を増やしても効果はすぐに頭打ちになります。画像を1枚追加するごとに、衣装・照明・背景の違いが混ざる可能性も増えます。
目安としては、被写体1つにつき3〜5枚を、角度が偏らないように選ぶのがよいでしょう。1カットに入れる被写体も、シーンに必要な数だけにとどめます。
プロジェクトに合うモデルの選び方
繰り返し登場するキャラクターで、短いSNS向けクリップを作る場合:現時点で最も実用的なのはKling 3.0 Omniです。公開APIがあり、クリップは最長15秒、繰り返し登場する被写体向けの要素機能もあります。
1つのカットにキャラクター・商品・場所を入れる場合:上限が大きく、1回のリクエストで複数の被写体を扱えるモデルが向いています。上限に余裕のある提供元のSeedance 2.5や、APIが公開された後のKling 4.0が候補になります。
広告などで構図を厳密に指定して始めたい場合:参照と開始フレームを組み合わせられるモデルを選びます。fal.aiのKling Omni系エンドポイントでは、要素と並んで開始・終了画像の入力欄が用意されています。
良い画像が3枚だけの場合:Veo 3.1は、まさに3枚を前提に設計されています。
マルチリファレンス動画生成ツールで確認すべき点
被写体の再利用:キャラクターの参照画像は一度アップロードすれば、以降はそのキャラクターを選ぶだけで使えること。プロンプトのたびにファイルを添付し直す必要がないことが理想です。
各画像の役割が明確であること:どの画像がメインの見た目として扱われ、実際に何枚がモデルに送られるのかが分かること。
被写体ごとの履歴:1人のキャラクターのクリップがまとめて見られ、見た目のずれに気づきやすいこと。
正直なモデル表示:どのモデルとバージョンで生成されたクリップかが明示されていること。
分かりやすい料金:生成ボタンを押す前に、クリップ1本の費用が分かること。
RefVidの位置づけ
RefVidは、保存したキャラクターや商品を軸に作られたマルチリファレンス動画生成ツールです。各アセットには1〜5枚の参照画像を登録でき、先頭の画像がメインの見た目になります。動画は1つのアセットにつき1つ使います。現在はKling 3.0 Omniで生成しており、開始前に生成ボタン上で費用が表示され、すべてのクリップはアセットのページに一覧されます。Kling 4.0のAPIが公開された時点で、RefVidもKling 4.0に切り替えます。
よくある質問
- 参照画像を最も多く受け付けるAI動画モデルはどれですか?
- 2026年10月時点で、一部のAPI提供元はSeedance 2.5について最大30枚の画像を掲げています。Kling 4.0は合計15個の参照のうち最大10枚の画像を受け付けますが、APIはまだ公開されていません。
- マルチリファレンスは開始フレームの指定と同じですか?
- いいえ。開始フレームと終了フレームはクリップの特定の瞬間を固定します。参照は被写体を説明するもので、どのフレームも固定しません。モデルによっては1回のリクエストで両方を使えるものもあります。
- 良い結果を得るには参照画像をたくさん用意する必要がありますか?
- いいえ。被写体ごとに、主要な角度を押さえたシャープな画像3〜5枚で十分なことがほとんどです。衣装や照明が異なる余分な画像は、結果を悪くします。
- RefVidの動画1本あたりの料金はいくらですか?
- 1秒あたり31クレジットです。3秒は93、5秒は155、10秒は310、15秒は465クレジットになります。最初の50アカウントには630クレジットが無料で付与され、5秒の動画4本分にあたります。それ以降のアカウントには100クレジット(3秒のクリップ1本分)が付与されます。
- マルチリファレンスのAI動画生成ツールは、どれから始めるのがよいですか?
- 現在公開APIがあるもの、例えばKling 3.0 Omni、Veo 3.1、Seedance 2.5から選ぶのがよいでしょう。上の表で上限を比較できます。
- 参照動画生成AIは、画像からの動画生成と同じですか?
- いいえ。画像からの動画生成は1枚の画像を最初のフレームとして動かします。参照動画生成は、複数の画像から被写体を保ったまま新しいシーンを作ります。