Geradores de vídeo multi-referência comparados
Um gerador de vídeo multi-referência recebe várias imagens, e às vezes clipes de vídeo ou áudio, das pessoas, produtos e lugares que você quer na cena, e gera uma nova cena que mantém todos eles. Até outubro de 2026, os principais modelos com esse modo são Kling 3.0 Omni, Kling 4.0, Google Veo 3.1, ByteDance Seedance 2.5 e MiniMax H3. Os limites de cada um variam muito, assim como as ferramentas construídas sobre eles. Esta página mostra o que cada modelo aceita e o que observar em um gerador.
Envie suas imagens de referênciaMia: 4 fotos
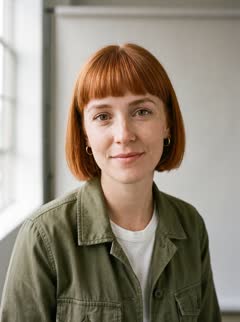
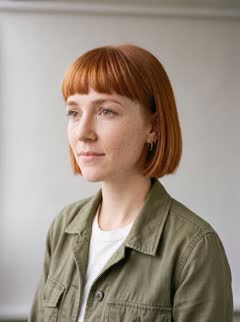
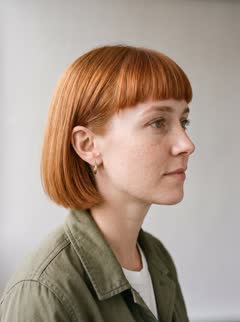
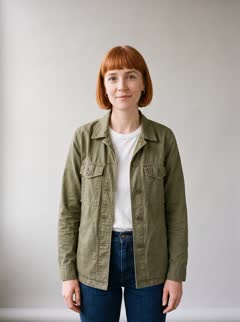
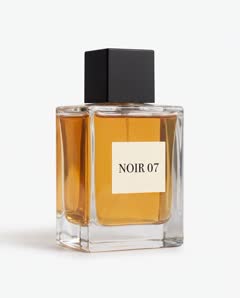
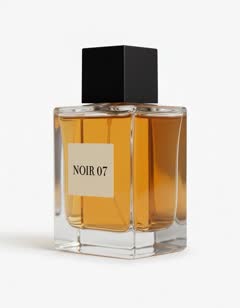
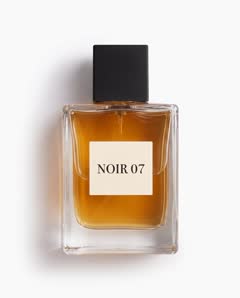
NOIR 07: 3 fotos
Multi-referência vs. imagem-para-vídeo
A imagem-para-vídeo usa uma imagem como primeiro quadro. Ela é precisa nesse quadro e menos confiável depois, porque o modelo preenche tudo o que a imagem não mostra.
A geração multi-referência não fixa um quadro. Ela lê todas as imagens em conjunto como uma descrição dos sujeitos e então compõe um novo plano. Na prática, isso tem três efeitos. O sujeito pode aparecer em ângulos que nenhuma das imagens mostra. Vários sujeitos podem dividir o mesmo plano, cada um com as próprias referências. E as mesmas referências podem ser reutilizadas em todas as cenas, o que mantém uma série consistente.
O custo é o controle sobre o primeiro quadro exato. Alguns modelos permitem combinar referências com um quadro inicial; outros não.
3 fotos de referência
O que cada modelo aceita (até outubro de 2026)
Kling 3.0 Omni: até 7 imagens ou elementos de referência, ou um vídeo de referência de 3 a 10 segundos mais até 4 imagens ou elementos, segundo o guia da Kling. Clipes de até 15 segundos em 720p ou 1080p. Um elemento pode ter uma voz vinculada. Disponível pela API da Kling e pela fal.ai.
Kling 4.0: até 15 entradas de referência no total, incluindo até 10 imagens, até 5 vídeos com 30 segundos somados e até 7 elementos, com clipes de 3 a 30 segundos, segundo o guia da Kling. Foi lançado no app da Kling em 15 de outubro de 2026. O acesso à API está marcado como em breve.
Veo 3.1: até 3 imagens de referência de uma mesma pessoa, personagem ou produto, segundo a documentação do Google. Os clipes de referência têm 8 segundos, em 16:9 ou 9:16. O Google chama isso de Ingredients to Video. O Veo 3.1 Lite não aceita referências.
Seedance 2.5 e MiniMax H3: ambos aceitam múltiplas imagens de referência, e alguns provedores também aceitam referências de vídeo e áudio. Os limites publicados variam muito conforme o provedor, de cerca de 9 a 30 imagens no Seedance 2.5 e de 5 a 9 no MiniMax H3, então confira os limites exatos do provedor que você usa.
Mais referências nem sempre é melhor
Um limite maior ajuda quando um plano tem vários sujeitos. Para um único personagem, o retorno cai rápido. Cada imagem extra é mais uma chance de surgir um figurino diferente, outra luz ou um fundo estranho.
Uma boa regra prática: de três a cinco imagens por sujeito, escolhidas para cobrir os ângulos, e só tantos sujeitos por plano quanto a cena exigir.
Como escolher um modelo para o projeto
Um personagem recorrente, clipes curtos para redes sociais: o Kling 3.0 Omni é hoje a escolha mais prática. Tem API pública, clipes de até 15 segundos e elementos criados para sujeitos recorrentes.
Um personagem, um produto e um local no mesmo plano: um modelo com limite maior e vários sujeitos por pedido, como o Seedance 2.5 num provedor com limites generosos, ou o Kling 4.0 quando a API abrir.
Anúncios que precisam começar numa composição exata: um modelo que permita quadro inicial com referências. Os endpoints Omni da Kling na fal.ai expõem campos de imagem inicial e final junto com os elementos.
Apenas três boas imagens: o Veo 3.1 é feito exatamente para três.
O que observar em um gerador multi-referência
Sujeitos reutilizáveis. Você deve enviar as referências de um personagem uma única vez e escolhê-lo depois, sem reanexar arquivos a cada prompt.
Regras claras sobre a função de cada imagem. A ferramenta deve informar qual imagem é tratada como vista principal e quantas imagens ela realmente envia ao modelo.
Histórico por sujeito. Todos os clipes de um personagem juntos, para você identificar a deriva.
Rótulos honestos de modelo. Uma ferramenta deve dizer qual modelo e versão gerou cada clipe.
Preços claros. Você deve saber o custo de um clipe antes de clicar em gerar.
Onde o RefVid se encaixa
O RefVid é um gerador multi-referência construído em torno de personagens e produtos salvos. Cada ativo guarda de 1 a 5 imagens de referência, sendo a primeira a vista principal, e cada vídeo usa um ativo. A geração roda hoje no Kling 3.0 Omni, o custo aparece no botão antes de você começar, e cada clipe fica listado na página do ativo. O RefVid vai migrar para o Kling 4.0 quando a API dele abrir.
Perguntas frequentes
- Qual modelo de vídeo com IA aceita mais imagens de referência?
- Até outubro de 2026, alguns provedores de API listam até 30 imagens para o Seedance 2.5. O Kling 4.0 aceita até 10 imagens dentro de 15 referências, mas a API ainda não está aberta.
- Multi-referência é o mesmo que usar quadros iniciais?
- Não. Quadros inicial e final fixam momentos exatos do clipe. As referências descrevem sujeitos e não fixam nenhum quadro. Alguns modelos permitem usar os dois em um mesmo pedido.
- Preciso de muitas referências para bons resultados?
- Não. De três a cinco imagens nítidas por sujeito, cobrindo os principais ângulos, costumam bastar. Imagens extras que variam em figurino ou iluminação pioram o resultado.
- Quanto custa cada vídeo no RefVid?
- 31 créditos por segundo: 93 para 3 segundos, 155 para 5, 310 para 10 e 465 para 15. As primeiras 50 contas recebem 630 créditos grátis, o que dá para quatro vídeos de 5 segundos. As contas seguintes recebem 100, um clipe de 3 segundos.
- Qual gerador de vídeo multi-referência com IA devo testar primeiro?
- Um que tenha API pública hoje, como o Kling 3.0 Omni, o Veo 3.1 ou o Seedance 2.5. A tabela acima compara os limites deles.
- Gerador de vídeo com referência por IA é o mesmo que imagem-para-vídeo?
- Não. A imagem-para-vídeo anima uma figura como primeiro quadro; um gerador por referência cria uma nova cena que mantém os sujeitos de várias imagens.