Reference to video: como funciona e como fazer bem
Reference-to-video é uma forma de gerar vídeo com IA em que você envia ao modelo várias imagens de um elemento, como uma pessoa, um produto ou uma mascote, e ele cria uma nova cena mantendo esse elemento. As imagens não servem de primeiro quadro para animar. Elas descrevem quem ou o que precisa aparecer. Esta página explica como o modo funciona, quais modelos o oferecem em outubro de 2026 e os cuidados que separam clipes utilizáveis dos que ficam quase lá.
Envie suas imagens de referência3 fotos de referência
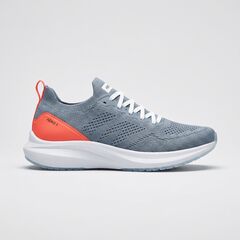
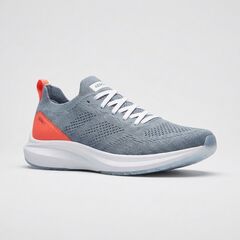
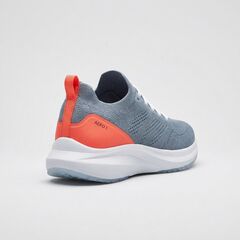
Três cenas, o mesmo tênis
Reference-to-video x text-to-video e image-to-video
No text-to-video, o ponto de partida são apenas palavras. O modelo decide como o elemento é, então dois clipes com o mesmo prompt mostram duas pessoas diferentes.
No image-to-video, a base é uma única imagem animada. O primeiro quadro é igual à sua foto. Tudo o que a imagem não mostra, como o outro lado do rosto, é inventado conforme a câmera se move, e cada nova cena exige uma nova imagem inicial.
Essa abordagem separa o elemento da cena. As referências dizem quem é. O prompt diz onde está, o que acontece e como a câmera se move. O modelo pode colocar o elemento numa cena que nenhuma imagem mostra, a partir de um ângulo que nenhuma delas registra, e ainda manter a identidade. Por isso o modo funciona bem para séries, anúncios e histórias curtas.
Só texto: a mesma descrição em palavras
Quatro fotos de referência
Como o modelo lê as suas referências
A maioria dos modelos de referência permite apontar cada entrada dentro do prompt. Os modelos Omni da Kling agrupam as imagens de um mesmo elemento e o chamam de @Element1. Outros modelos identificam as imagens pela posição. Dar nomes faz diferença quando a cena tem dois elementos: isso indica ao modelo qual imagem é a pessoa e qual é o produto.
O modelo trata tudo o que aparece numa referência como parte do elemento, a menos que você diga o contrário. Uma marca d'água, um fundo muito cheio ou um filtro de cor forte podem vazar para o resultado. Poucas referências limpas valem mais do que muitas com ruído.
Quais modelos oferecem (em outubro de 2026)
O Kling 3.0 Omni aceita até sete imagens de referência, ou um vídeo de referência de 3 a 10 segundos mais até quatro imagens, segundo o próprio guia da Kling. Gera até 15 segundos por requisição, em 720p ou 1080p, e está disponível pela API da Kling e por provedores como o fal.ai.
O Kling 4.0 foi lançado no app da própria Kling em 15 de outubro de 2026. O guia da Kling lista até 15 entradas de referência por requisição, incluindo até 10 imagens, e clipes de 3 a 30 segundos. A API para desenvolvedores ainda aparece como "em breve".
O Google Veo 3.1 chama o modo de Ingredients to Video. A documentação do Google permite até três imagens de referência de uma mesma pessoa, personagem ou produto, e as gerações com referências têm sempre 8 segundos.
O Seedance 2.5, da ByteDance, e o MiniMax H3 também oferecem modos com várias referências. Os limites variam entre os provedores de API, então confira o provedor que você pretende usar.
Escolhendo referências: um checklist curto
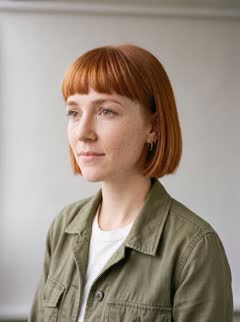
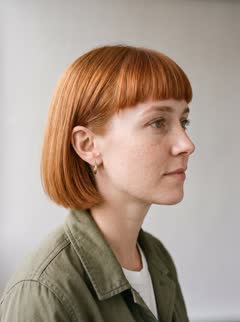
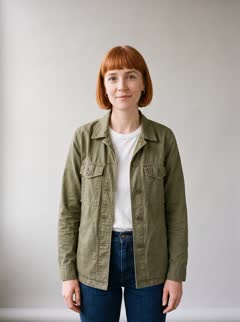
Para uma pessoa: uma vista frontal nítida, uma de três quartos, um perfil e um close de algo marcante, como óculos ou uma tatuagem. Mesma roupa e mesmo penteado em todas as imagens.
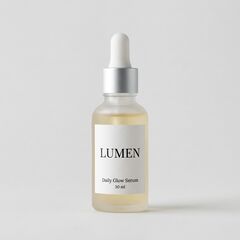
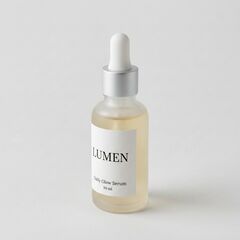
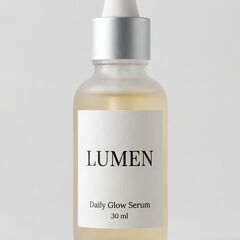
Para um produto: o ângulo principal, a parte de trás ou a lateral, um close nítido da logo ou do rótulo e uma foto que mostre a escala, como o produto na mão.
A luz deve ser suave e uniforme, os fundos lisos e as imagens nítidas em tamanho real. Evite filtros, textos sobrepostos e compressão pesada. Três a cinco boas imagens costumam superar dez misturadas. Se o modelo aceita só três, escolha as vistas que mostram mais identidade por imagem.
Uma pessoa: frontal, três quartos, perfil, corpo inteiro
Um produto: frontal, três quartos, close do rótulo
Escrevendo o prompt em torno das referências
Tire o elemento do prompt e deixe a cena nele. Não cite cor de cabelo nem roupa. Descreva o local, a ação, a câmera e a luz. Por exemplo: "Ela para numa praia ventosa na hora dourada, olha para o mar e depois lança um olhar para a câmera. Aproximação lenta, de plano médio para primeiro plano."
Não contradiga as referências. Se as imagens mostram cabelo castanho e o prompt diz loiro, o modelo precisa escolher e você recebe uma mistura. Se quiser mudar algo, faça novas referências.
Uma ação por plano funciona melhor do que três. Um clipe que precisa encaixar uma caminhada, uma virada, um gesto e uma risada em cinco segundos tende a correr e perder a identidade nos trechos rápidos.
Falhas comuns e como corrigi-las
O rosto muda quando o elemento vira a cabeça. Adicione uma referência de perfil. O modelo está adivinhando um ângulo que nunca viu.
O rótulo do produto é redesenhado. Enquadre a cena para que o rótulo não seja o foco, ou adicione um close mais nítido. Letras miúdas ainda são o ponto mais fraco dos modelos atuais.
O fundo de uma referência aparece na cena. Troque essa imagem por outra com fundo liso.
Um clipe de um lote sai errado enquanto os outros estão bons. Geralmente é azar. Gere de novo com as mesmas entradas antes de mudar qualquer coisa.
Testando no RefVid
O RefVid foi feito em torno desse modo. Você entra na conta, cria um personagem ou produto e envia de 1 a 5 imagens de referência: JPG, PNG ou WebP, com pelo menos 300 px e até 10 MB cada, com a vista principal primeiro. Depois escreve o prompt da cena, escolhe a duração de 3 a 15 segundos e gera. Os clipes rodam no Kling 3.0 Omni e costumam levar de 2 a 10 minutos. O RefVid vai migrar para o Kling 4.0 quando a API dele estiver aberta.
Perguntas frequentes
- Reference-to-video é o mesmo que image-to-video?
- Não. O image-to-video anima uma imagem como primeiro quadro. Um modelo de referência lê várias imagens como descrição do elemento e cria uma nova cena em volta dele, então o elemento pode aparecer em lugares e ângulos que as imagens não mostram.
- Quantas imagens de referência devo usar?
- Três a cinco imagens nítidas que cubram os principais ângulos é um bom padrão. O limite muda conforme o modelo: o Veo 3.1 aceita três, e o Kling 3.0 Omni aceita até sete.
- Funciona para produtos e não só para pessoas?
- Sim. Use o ângulo principal, a parte de trás ou a lateral, um close da logo e uma foto de escala. Planeje os planos para que textos pequenos não sejam o foco.
- Quanto custa um vídeo de referência no RefVid?
- 31 créditos por segundo: 93 créditos para 3 segundos, 155 para 5, 310 para 10 e 465 para 15. As primeiras 50 contas ganham 630 créditos grátis, o suficiente para quatro vídeos de 5 segundos. As contas depois disso ganham 100, um clipe de 3 segundos.