레퍼런스 투 비디오: 작동 원리와 잘 쓰는 방법
레퍼런스 투 비디오는 사람, 제품, 마스코트처럼 대상을 여러 장의 이미지로 알려주면, 그 대상이 유지된 새 장면을 만들어 주는 AI 영상 생성 방식이에요. 이미지는 움직일 첫 프레임이 아니라, 화면에 누가 또는 무엇이 나와야 하는지를 설명하는 자료예요. 이 페이지에서는 이 방식의 원리, 2026년 10월 기준으로 이를 지원하는 모델, 그리고 쓸 만한 클립과 아쉬운 클립을 가르는 습관을 소개해요.
레퍼런스 이미지 업로드하기레퍼런스 사진 3장
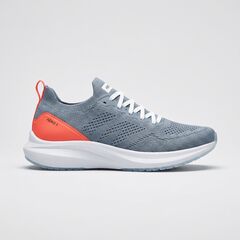
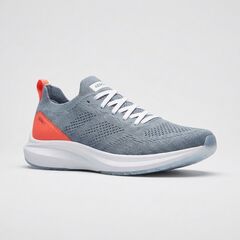
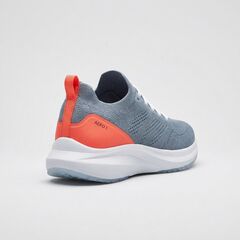
같은 신발이 나오는 장면 3개
레퍼런스 투 비디오 vs. 텍스트 투 비디오, 이미지 투 비디오
텍스트 투 비디오는 말로만 시작해요. 대상의 모습은 모델이 정하기 때문에, 같은 프롬프트라도 클립마다 다른 사람이 나와요.
이미지 투 비디오는 사진 한 장을 움직이게 해요. 첫 프레임은 업로드한 사진과 같지만, 카메라가 움직이면서 사진에 없는 부분(예: 얼굴의 옆면)은 모델이 새로 만들어요. 새 장면마다 시작 이미지도 새로 필요해요.
이 방식은 대상과 장면을 분리해요. 레퍼런스는 '누구인지'를 정하고, 프롬프트는 '어디서, 무엇을 하고, 카메라가 어떻게 움직이는지'를 정해요. 그래서 어떤 사진에도 없던 장소나 각도에서도 같은 정체성을 유지할 수 있어요. 시리즈물, 광고, 짧은 이야기에 특히 잘 맞아요.
텍스트만: 같은 설명을 글로만
레퍼런스 사진 4장
모델이 레퍼런스를 읽는 방식
대부분의 레퍼런스 모델은 프롬프트에서 입력 이미지를 지정할 수 있어요. 클링의 Omni 모델은 한 대상의 이미지를 묶어 엘리먼트로 만들고 @Element1처럼 부를 수 있어요. 다른 모델은 이미지의 순서로 지정하기도 해요. 한 장면에 대상이 두 개일 때는 이름을 붙이는 게 중요해요. 어떤 사진이 사람이고 어떤 사진이 제품인지 모델에게 알려줄 수 있거든요.
지시하지 않으면 모델은 레퍼런스의 모든 요소를 대상의 일부로 봐요. 워터마크, 복잡한 배경, 강한 색 필터가 결과물에 번질 수 있어요. 많은 레퍼런스보다 깨끗한 레퍼런스가 더 나아요.
지원하는 모델 (2026년 10월 기준)
클링 3.0 Omni는 클링 공식 가이드에 따르면 레퍼런스 이미지를 최대 7장 받거나, 3~10초 길이의 레퍼런스 영상 1개와 이미지 최대 4장을 받아요. 요청당 최대 15초를 720p 또는 1080p로 생성하며, 클링 API와 fal.ai 같은 제공업체에서 쓸 수 있어요.
클링 4.0은 2026년 10월 15일 클링 자체 앱에 출시됐어요. 클링 가이드에 따르면 요청당 레퍼런스 입력을 최대 15개(이미지 최대 10장 포함)까지, 3~30초 길이의 클립을 받아요. 개발자 API는 아직 '출시 예정'으로 표시돼 있어요.
구글 Veo 3.1은 이 방식을 'Ingredients to Video'라고 불러요. 구글 문서에 따르면 한 명의 사람, 캐릭터, 또는 제품에 대해 레퍼런스 이미지를 최대 3장까지 쓸 수 있고, 레퍼런스를 쓴 생성 결과는 항상 8초예요.
바이트댄스의 Seedance 2.5와 MiniMax H3도 다중 레퍼런스 모드를 제공해요. 제한은 API 제공업체마다 다르니 사용할 곳에서 미리 확인하세요.
레퍼런스 고르기: 짧은 체크리스트
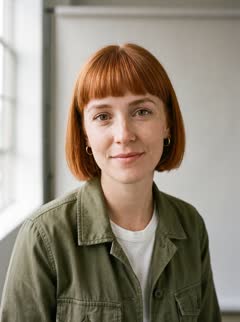
인물이라면: 정면, 3/4 측면, 옆얼굴을 하나씩, 그리고 안경이나 문신처럼 특징적인 부분을 클로즈업한 사진이 좋아요. 모든 사진에서 옷과 헤어스타일을 똑같이 맞춰 주세요.
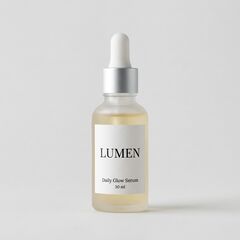
제품이라면: 대표 각도, 뒷면이나 옆면, 로고나 라벨을 선명하게 찍은 클로즈업, 그리고 손에 든 모습처럼 크기가 가늠되는 컷 하나를 준비하세요.
조명은 부드럽고 고르게, 배경은 단순하게, 원본 크기에서도 선명한 이미지를 쓰세요. 필터, 텍스트 오버레이, 과도한 압축은 피하세요. 보통은 여러 잡다한 이미지 10장보다 선명한 3~5장이 더 나아요. 모델이 3장까지만 받는다면, 한 장에서 정체성을 가장 많이 보여 주는 각도를 고르세요.
인물: 정면, 3/4 측면, 옆얼굴, 전신
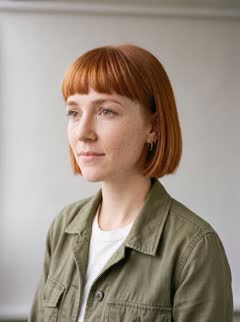
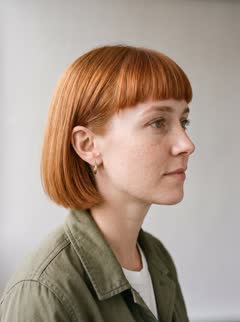
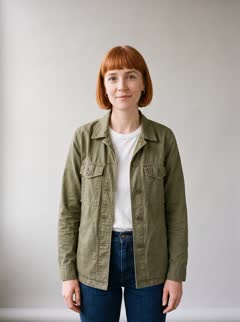
제품: 정면, 3/4 측면, 라벨 클로즈업
레퍼런스에 맞춘 프롬프트 쓰기
프롬프트에서는 대상을 빼고 장면만 쓰세요. 머리색과 옷차림은 쓰지 마세요. 대신 장소, 동작, 카메라, 빛을 설명하세요. 예를 들면 이렇게요: "그녀는 황금빛 노을이 지는 바람 부는 해변에 서서 바다를 바라보다가 카메라를 힐끗 본다. 미디엄 샷에서 클로즈업으로 천천히 밀고 들어간다."
레퍼런스와 모순되게 쓰지 마세요. 사진에 갈색 머리가 나오는데 프롬프트에 금발이라고 쓰면, 모델은 둘 중 하나를 고르게 되고 결과는 섞여요. 바꾸고 싶다면 새 레퍼런스를 만드세요.
한 컷에 동작 하나가 세 개보다 나아요. 걷기, 돌아서기, 물건 집기, 웃기를 5초 안에 모두 넣으면 서두르게 되고, 빠른 장면에서 정체성이 무너지기 쉬워요.
자주 생기는 문제와 해결법
대상이 고개를 돌리면 얼굴이 바뀌어요. 옆얼굴 레퍼런스를 추가하세요. 모델이 한 번도 보지 못한 각도를 추측하고 있는 거예요.
제품 라벨이 다시 그려져요. 라벨이 주인공이 되지 않도록 구도를 잡거나, 더 선명한 클로즈업을 추가하세요. 작은 글씨는 지금의 모델이 가장 약한 부분이에요.
레퍼런스의 배경이 장면에 나타나요. 그 이미지를 단순한 배경의 사진으로 바꾸세요.
한 번에 생성한 여러 클립 중 하나만 어긋나요. 보통은 우연이에요. 같은 입력으로 먼저 다시 생성해 보세요.
RefVid에서 써 보기
RefVid는 이 방식을 중심으로 만들어졌어요. 로그인한 뒤 캐릭터나 제품을 만들고, 대표 각도를 맨 앞에 두고 레퍼런스 이미지를 1~5장 업로드하세요. 형식은 JPG, PNG, WebP이고, 각각 최소 300px, 최대 10MB예요. 그다음 장면 프롬프트를 쓰고, 3~15초 길이를 고른 뒤 생성하세요. 클립은 클링 3.0 Omni로 만들어지며 보통 2~10분이 걸려요. 클링 4.0 API가 열리면 RefVid도 클링 4.0으로 전환할 예정이에요.
자주 묻는 질문
- 레퍼런스 투 비디오는 이미지 투 비디오와 같은 건가요?
- 아니요. 이미지 투 비디오는 사진 한 장을 첫 프레임으로 삼아 움직이게 해요. 레퍼런스 모델은 여러 이미지를 대상에 대한 설명으로 읽고 그 주변에 새 장면을 만들어서, 이미지에 없던 장소와 각도에도 대상이 나올 수 있어요.
- 레퍼런스 이미지는 몇 장을 쓰는 게 좋나요?
- 주요 각도를 담은 선명한 이미지 3~5장이 좋은 기본값이에요. 모델마다 최대 개수가 달라요. Veo 3.1은 3장, 클링 3.0 Omni는 최대 7장을 받아요.
- 사람뿐 아니라 제품에도 쓸 수 있나요?
- 네, 가능해요. 대표 각도, 뒷면이나 옆면, 로고 클로즈업, 크기가 보이는 컷을 쓰세요. 작은 인쇄 글씨가 주인공이 되지 않도록 컷을 계획하세요.
- RefVid에서 레퍼런스 영상은 얼마나 드나요?
- 초당 31크레딧이에요. 3초는 93크레딧, 5초는 155크레딧, 10초는 310크레딧, 15초는 465크레딧이에요. 처음 50개 계정에는 무료 크레딧 630개가 주어져서 5초짜리 영상 4개를 만들 수 있어요. 그 이후 계정은 100크레딧을 받아 3초짜리 클립 1개를 만들 수 있어요.