멀티 레퍼런스 영상 생성기 비교
멀티 레퍼런스 영상 생성기는 장면에 담고 싶은 인물, 제품, 장소를 찍은 이미지 여러 장을 받아요. 경우에 따라 영상이나 오디오 클립도 받고요. 그런 다음 그 피사체를 그대로 살린 새로운 장면을 만들어 줘요. 2026년 10월 현재 이 방식을 지원하는 주요 모델은 Kling 3.0 Omni, Kling 4.0, Google Veo 3.1, ByteDance Seedance 2.5, MiniMax H3예요. 모델마다 한도가 크게 다르고, 이를 기반으로 만든 도구도 차이가 커요. 이 페이지에서는 모델별로 무엇을 받는지, 생성기를 고를 때 무엇을 살펴봐야 하는지 정리했어요.
레퍼런스 이미지 업로드하기Mia: 사진 4장
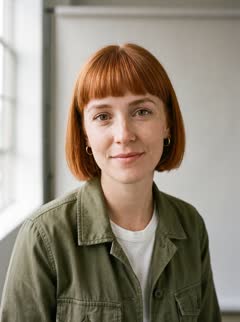
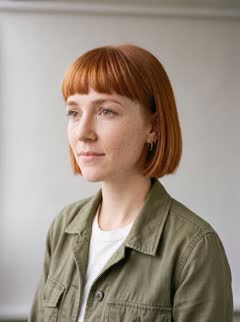
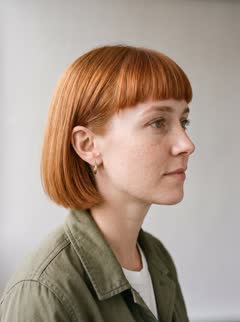
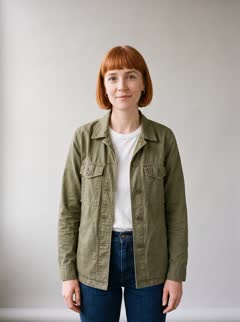
NOIR 07: 사진 3장
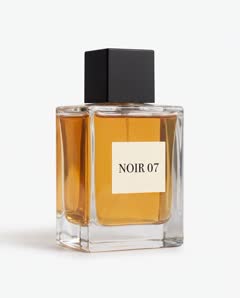
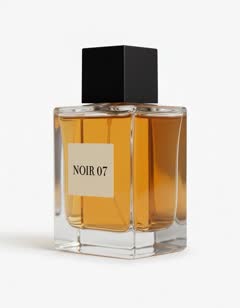
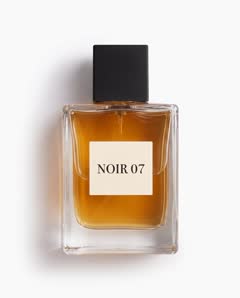
멀티 레퍼런스 vs. 이미지-투-비디오
이미지-투-비디오는 이미지 한 장을 첫 프레임으로 삼아요. 그 프레임은 정확하게 살아나지만, 이미지에 없는 부분은 모델이 채우기 때문에 그 이후 장면은 안정성이 떨어져요.
멀티 레퍼런스 생성은 프레임을 고정하지 않아요. 여러 이미지를 모두 피사체를 설명하는 자료로 읽고 새로운 장면을 구성해요. 실제로 세 가지 효과가 있어요. 어떤 이미지에도 없던 각도에서도 피사체가 등장할 수 있어요. 여러 피사체가 한 장면에 함께 나오고, 각자 자기 레퍼런스를 따라가요. 같은 레퍼런스를 모든 장면에 다시 쓸 수 있어서 시리즈 전체가 일관되게 유지돼요.
대신 정확한 첫 프레임을 조절하기는 어려워요. 일부 모델은 레퍼런스와 시작 프레임을 함께 쓸 수 있지만, 그렇지 않은 모델도 있어요.
레퍼런스 사진 3장
모델별 입력 한도 (2026년 10월 기준)
Kling 3.0 Omni: Kling 가이드에 따르면 참조 이미지 또는 엘리먼트를 최대 7개 받거나, 3~10초 길이의 참조 영상 1개와 이미지 또는 엘리먼트 최대 4개를 받아요. 클립은 720p 또는 1080p로 최대 15초까지 만들 수 있어요. 엘리먼트에는 음성을 묶어 둘 수 있어요. Kling API와 fal.ai에서 쓸 수 있어요.
Kling 4.0: Kling 가이드 기준으로 참조 입력은 총 15개까지 가능해요. 이미지는 최대 10개, 영상은 합산 30초 안에서 최대 5개, 엘리먼트는 최대 7개예요. 영상 클립 길이는 3~30초예요. 2026년 10월 15일 Kling 앱에 출시됐고, API는 출시 예정으로 표시돼 있어요.
Veo 3.1: Google 문서 기준으로 한 사람, 캐릭터 또는 제품에 대해 참조 이미지를 최대 3장 받아요. 참조 클립은 8초이며 16:9 또는 9:16이에요. Google은 이 기능을 Ingredients to Video라고 불러요. Veo 3.1 Lite는 참조를 지원하지 않아요.
Seedance 2.5와 MiniMax H3: 둘 다 여러 장의 이미지 참조를 받고, 일부 제공사는 영상과 오디오 참조도 받아요. 공개된 한도는 제공사마다 크게 달라요. Seedance 2.5는 약 9~30장, MiniMax H3는 5~9장 수준이니 사용하는 제공사의 정확한 한도를 확인하세요.
레퍼런스가 많다고 무조건 좋은 건 아니에요
한도가 크면 한 장면에 피사체가 여럿 있을 때 도움이 돼요. 캐릭터 한 명이라면 효과는 금방 줄어들어요. 이미지가 한 장 늘 때마다 다른 옷, 다른 조명, 엉뚱한 배경이 섞일 가능성도 함께 늘어나요.
실전에서 쓸 만한 기준은 피사체 하나당 3~5장이에요. 각도가 골고루 담기도록 고르고, 장면에 필요한 만큼만 피사체를 넣으세요.
프로젝트에 맞는 모델 고르기
반복해서 등장하는 캐릭터 하나, 짧은 소셜 클립: 지금은 Kling 3.0 Omni가 가장 실용적이에요. 공개 API가 있고, 최대 15초 클립을 만들 수 있으며, 반복 등장하는 피사체를 위한 엘리먼트 기능이 있어요.
캐릭터, 제품, 장소를 한 장면에 담을 때: 한도가 더 높고 한 요청에 여러 피사체를 넣을 수 있는 모델이 맞아요. 여유 있는 한도를 주는 제공사의 Seedance 2.5나, API가 열리면 Kling 4.0을 고려해 보세요.
정확한 구도로 시작해야 하는 광고: 레퍼런스와 시작 프레임을 함께 쓸 수 있는 모델을 고르세요. fal.ai의 Kling Omni 엔드포인트는 엘리먼트 옆에 시작 및 끝 이미지 필드를 제공해요.
좋은 이미지가 딱 세 장뿐일 때: Veo 3.1이 정확히 세 장을 기준으로 설계돼 있어요.
멀티 레퍼런스 생성기에서 확인할 점
재사용 가능한 피사체: 캐릭터의 레퍼런스는 한 번만 올리고 나중에 캐릭터를 선택할 수 있어야 해요. 프롬프트마다 파일을 다시 첨부해야 한다면 불편해요.
이미지마다 역할을 분명히 알려주는지: 어떤 이미지를 메인 뷰로 쓰는지, 모델에 실제로 몇 장을 보내는지 도구가 알려줘야 해요.
피사체별 기록: 한 캐릭터의 모든 클립을 한곳에 모아 두면 외형이 얼마나 변했는지 한눈에 볼 수 있어요.
정직한 모델 표기: 각 클립을 어떤 모델과 버전으로 만들었는지 도구가 알려줘야 해요.
명확한 가격: 생성 버튼을 누르기 전에 클립 한 편의 비용을 알 수 있어야 해요.
RefVid는 이런 분께 맞아요
RefVid는 저장한 캐릭터와 제품을 중심으로 만든 멀티 레퍼런스 생성기예요. 에셋 하나에는 레퍼런스 이미지를 1~5장 담을 수 있고, 첫 번째 이미지가 메인 뷰가 돼요. 영상 하나는 에셋 하나를 사용해요. 지금은 Kling 3.0 Omni로 생성하고, 시작 전에 버튼에서 비용을 확인할 수 있어요. 만든 클립은 모두 에셋 페이지에 모여요. Kling 4.0 API가 열리면 RefVid도 Kling 4.0으로 전환할 예정이에요.
자주 묻는 질문
- 레퍼런스 이미지를 가장 많이 받는 AI 영상 모델은 무엇인가요?
- 2026년 10월 기준으로 일부 API 제공사는 Seedance 2.5에서 이미지 최대 30장을 받는다고 밝혔어요. Kling 4.0은 레퍼런스 15개 안에서 이미지 최대 10장을 받지만, API는 아직 열리지 않았어요.
- 멀티 레퍼런스는 시작 프레임을 쓰는 것과 같은가요?
- 아니에요. 시작 및 끝 프레임은 클립의 특정 순간을 고정해요. 레퍼런스는 피사체를 설명할 뿐 어떤 프레임도 고정하지 않아요. 일부 모델은 한 요청에서 둘을 함께 쓸 수 있어요.
- 좋은 결과를 얻으려면 레퍼런스가 많이 필요한가요?
- 아니에요. 피사체당 주요 각도를 담은 선명한 이미지 3~5장이면 보통 충분해요. 옷이나 조명이 다른 추가 이미지는 오히려 결과를 나쁘게 만들어요.
- RefVid는 영상 한 편에 얼마인가요?
- 초당 31 크레딧이에요. 3초는 93, 5초는 155, 10초는 310, 15초는 465 크레딧이에요. 처음 50개 계정에는 무료 크레딧 630이 주어져서 5초짜리 영상 4편을 만들 수 있어요. 이후 계정에는 100 크레딧이 주어지고, 3초짜리 클립 한 편을 만들 수 있어요.
- 멀티 레퍼런스 AI 영상 생성기는 어디서부터 시작하면 좋을까요?
- 지금 공개 API가 있는 모델, 예를 들어 Kling 3.0 Omni, Veo 3.1, Seedance 2.5 중에서 고르세요. 위의 표에서 각 모델의 한도를 비교할 수 있어요.
- 레퍼런스 영상 생성 AI는 이미지-투-비디오와 같은가요?
- 아니에요. 이미지-투-비디오는 사진 한 장을 첫 프레임으로 삼아 움직이게 해요. 레퍼런스 생성기는 여러 이미지의 피사체를 유지한 새로운 장면을 만들어요.