멀티 레퍼런스 영상 AI - RefVid
내 사진으로 몇 분 만에 영상 만들기 · 첫 영상 무료, 워터마크 없음





첫 영상 무료, 카드 불필요
멀티 레퍼런스 영상 AI는 여러 참조 이미지로 클립 하나를 만들어요. 캐릭터, 제품, 배경을 각각 자기 사진에서 가져와 모두 같은 샷에 담아요. 인물이나 제품은 각각 사진 1~10장으로 한 번 저장하고, 위 상자에 최대 3개까지 넣은 뒤 장소나 스타일 이미지를 최대 7장 더해요. 무슨 일이 일어나는지 쓰고 생성을 누르면 돼요. Kling 3.0 Omni로 만드는 첫 5초 클립은 무료이고 워터마크도 없어요.
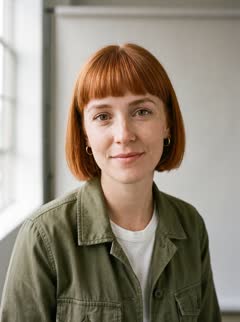
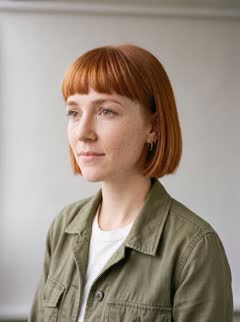
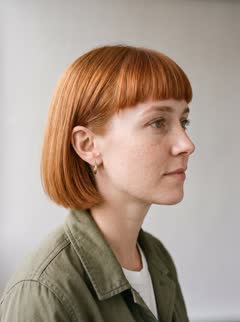
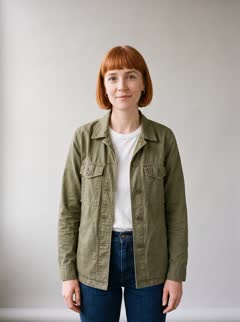
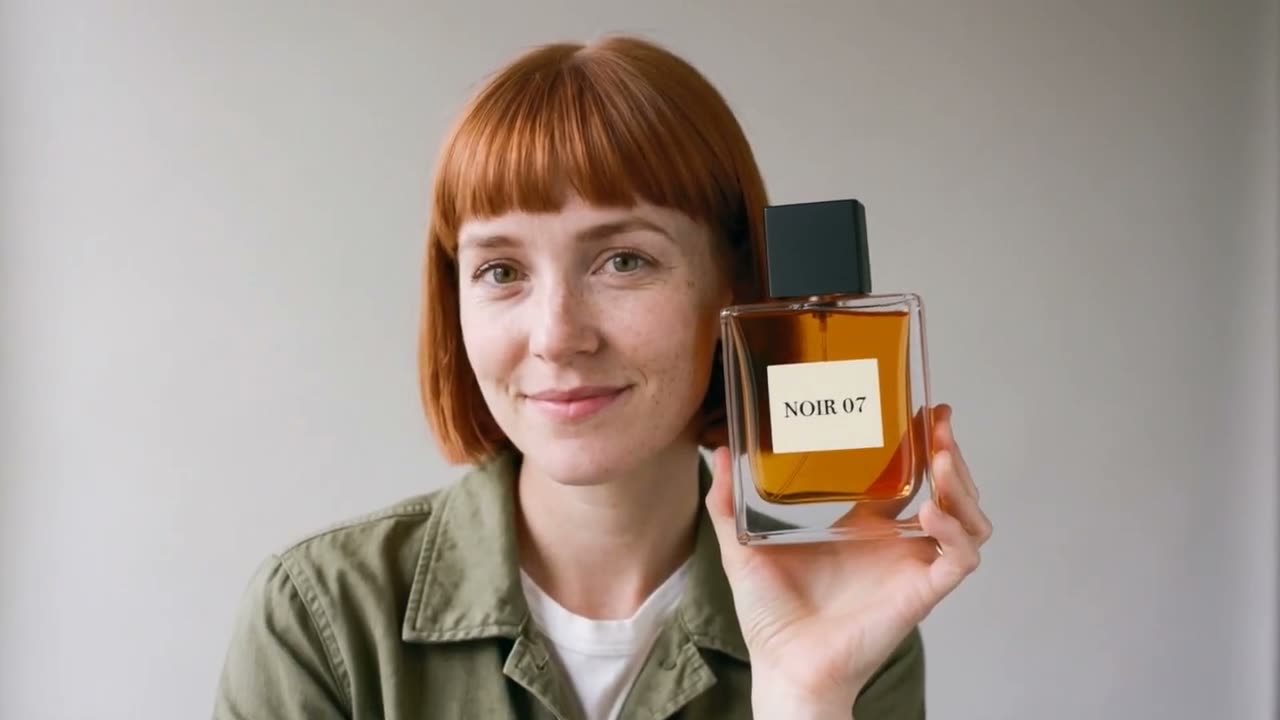
Mia: 사진 4장
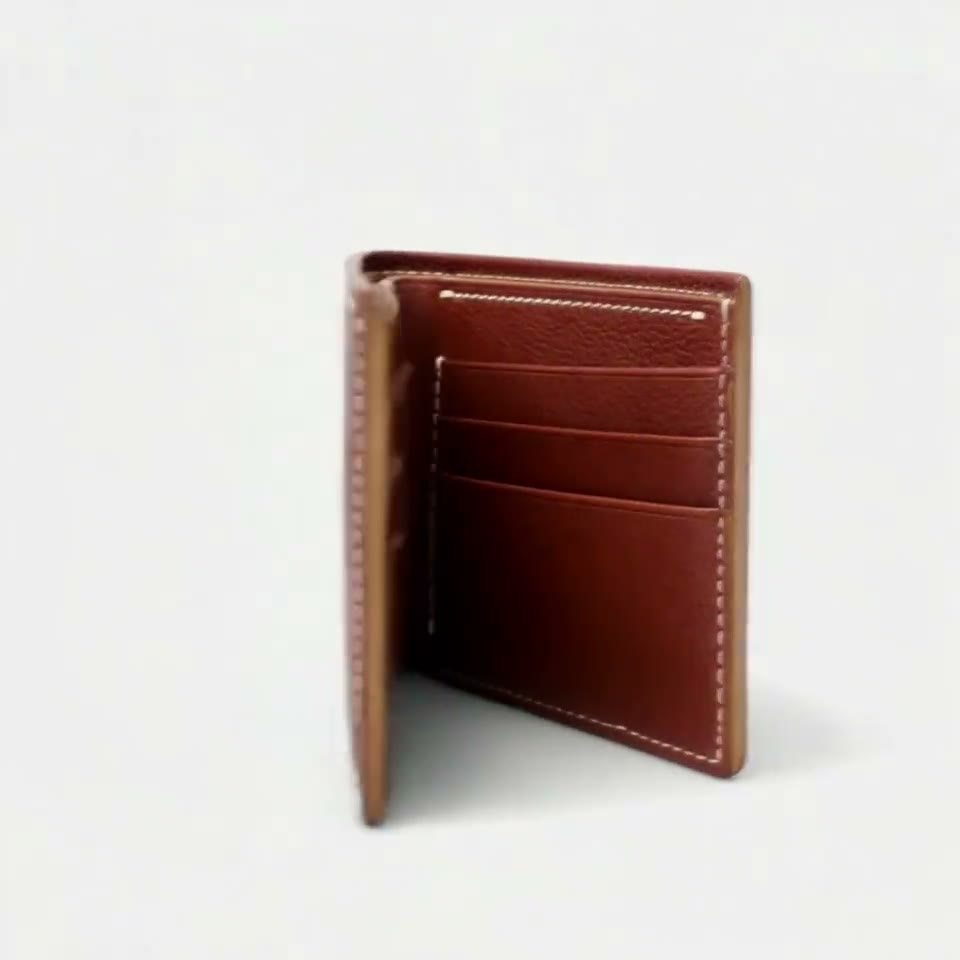
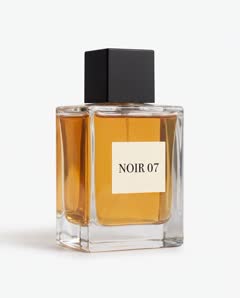
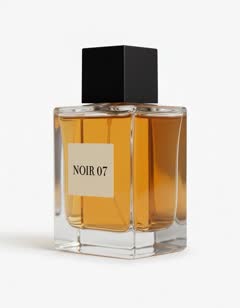
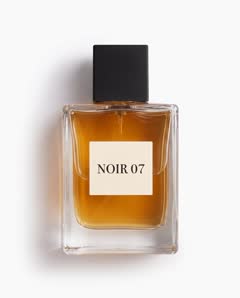
NOIR 07: 사진 3장
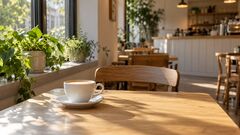
배경: 카페 사진 1장
멀티 레퍼런스 영상 AI로 할 수 있는 것
- 멀티 레퍼런스 모델은 사람, 제품, 장소처럼 여러 대상의 참조 이미지를 한 번에 받아, 그 모두를 유지한 새 장면 하나를 만들어요. 피사체마다 자기 사진이 있어서, 인물이 내 제품을 들어도 둘 다 원래 모습 그대로예요.
- 사진 한 장을 첫 프레임으로 움직이는 이미지 투 비디오와도, 정확한 순간을 고정하는 시작·끝 프레임과도 달라요. 참조는 누가, 무엇이 나와야 하는지를 알려 주고, 무슨 일이 일어나는지는 프롬프트가 정해요.
3단계로 만드는 방법
- 1. 인물, 제품, 반려동물 등 피사체마다 사진 1~10장으로 저장해요. 위 상자에 저장한 피사체를 최대 3개, 장소나 분위기, 스타일 이미지를 최대 7장 넣어요.
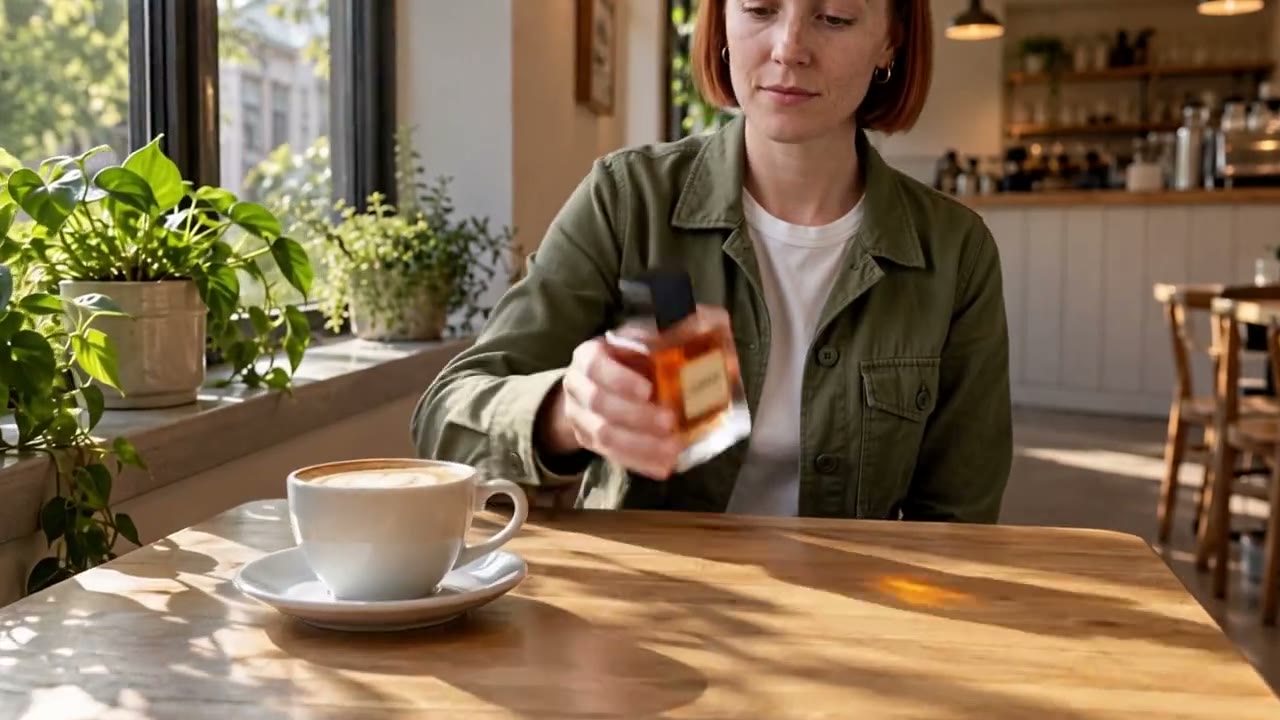
- 2. 장면을 쓰고 각 참조를 이름으로 불러요. 예를 들어 @Mia가 카페 테이블에서 @NOIR07을 집어 들고 라벨을 카메라 쪽으로 돌린다처럼요. 어떤 사진이 어떤 피사체인지는 RefVid가 모델에 알려 주니, 장면만 쓰면 돼요.
- 3. 생성을 눌러요. 로그인하지 않았다면 먼저 로그인하고, 바로 클립 생성이 시작돼요. 보통 2~10분 걸리고, 완성되면 이메일로 알려 드려요.
여러 이미지로 영상 만드는 AI: 피사체 하나, 사진 여러 장
- 같은 피사체를 찍은 여러 장의 사진도 멀티 레퍼런스예요. 제품 하나의 앞면, 옆면, 뒷면이나 얼굴 하나의 세 각도처럼요. 모델이 이 사진들을 함께 하나의 피사체로 읽기 때문에, 본 적 없는 면을 지어내지 않고도 제품이나 인물을 돌릴 수 있어요.
- 보통 피사체마다 선명한 사진 3~5장이면 충분해요. 옷차림이 두 가지이거나 조명이 두 종류처럼 서로 어긋나는 사진은 결과를 오히려 나쁘게 만들어요.
지원하는 모델
- RefVid가 돌리는 모델은 모두 참조 모델이고, fal.ai를 통해 모두 9개예요. 기본 모델인 Kling 4는 사진을 최대 10장 받고, 소리를 포함해 3~30초 클립을 만들어요. Kling 3.0 Omni는 15초 이하 클립이라면 초당 비용이 더 저렴해요. Wan 3.0과 Seedance 2.5도 30초까지 만들어요. Seedance 2.5는 실제 사람처럼 보이는 사진을 거부하니 제품, 반려동물, 일러스트 캐릭터에 잘 맞아요.
- 첫 클립은 무료예요. Kling 3.0 Omni에서 5초, 카드 등록이 필요 없어요. 그다음부터는 단건 영상 $2.99부터, 일회성 크레딧 팩 $9.90부터, 월 요금제 $10부터예요. 크레딧은 만료되지 않아요.
AI 영상 모델 더 알아보기
레퍼런스 투 비디오 →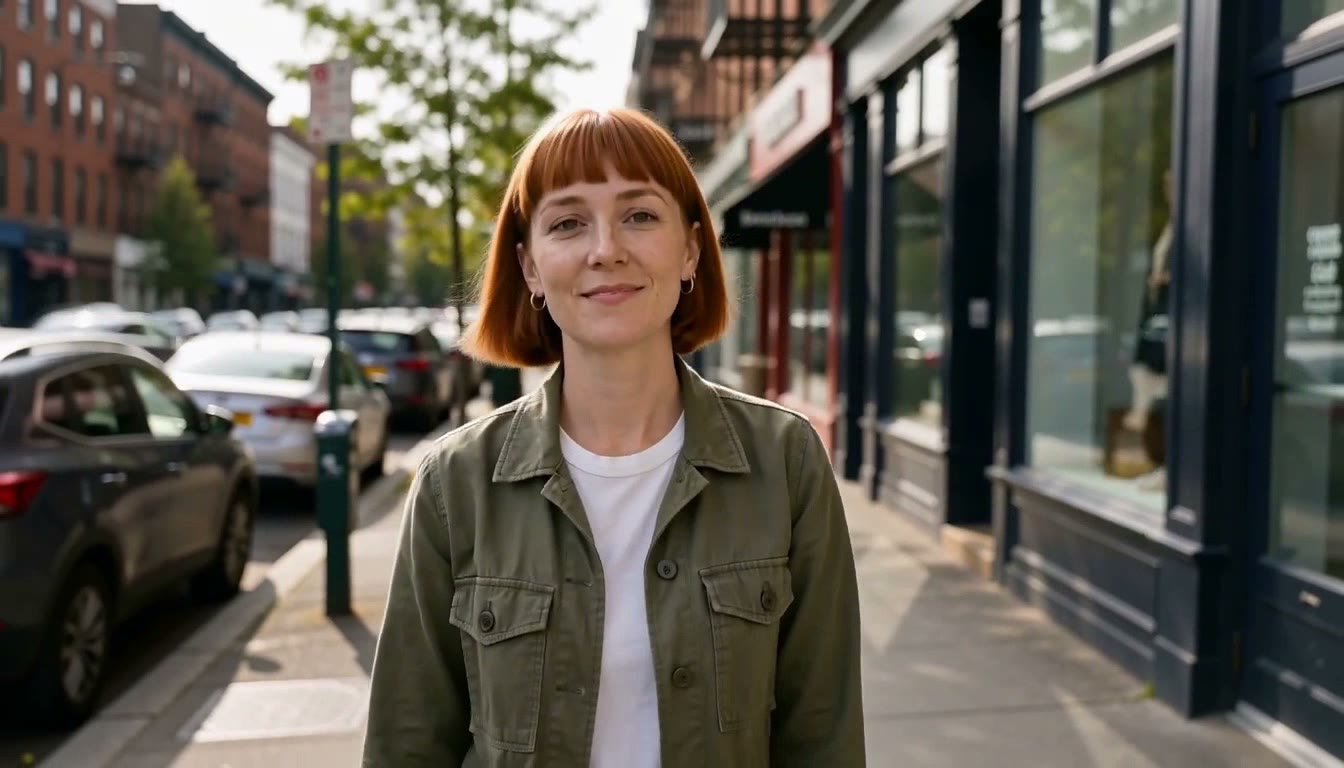
자주 묻는 질문
무료로 쓸 수 있는 멀티 레퍼런스 영상 AI가 있나요?
RefVid에서는 첫 클립이 무료예요. 내가 저장한 피사체로 Kling 3.0 Omni에서 5초, 카드 등록도 워터마크도 없어요. 그다음부터는 단건 영상 $2.99부터, 크레딧 팩 $9.90부터, 요금제는 월 $10부터예요.
클립 하나에 참조를 몇 개까지 쓸 수 있나요?
RefVid에서는 클립 하나에 저장한 피사체를 최대 3개(각각 사진 최대 10장), 여기에 장소나 스타일 이미지를 최대 7장 쓸 수 있어요. 모델 자체의 한도도 함께 적용돼요. Kling 4는 한 번의 요청에 이미지를 최대 10장 받아요.
인물과 제품을 같은 영상에 넣을 수 있나요?
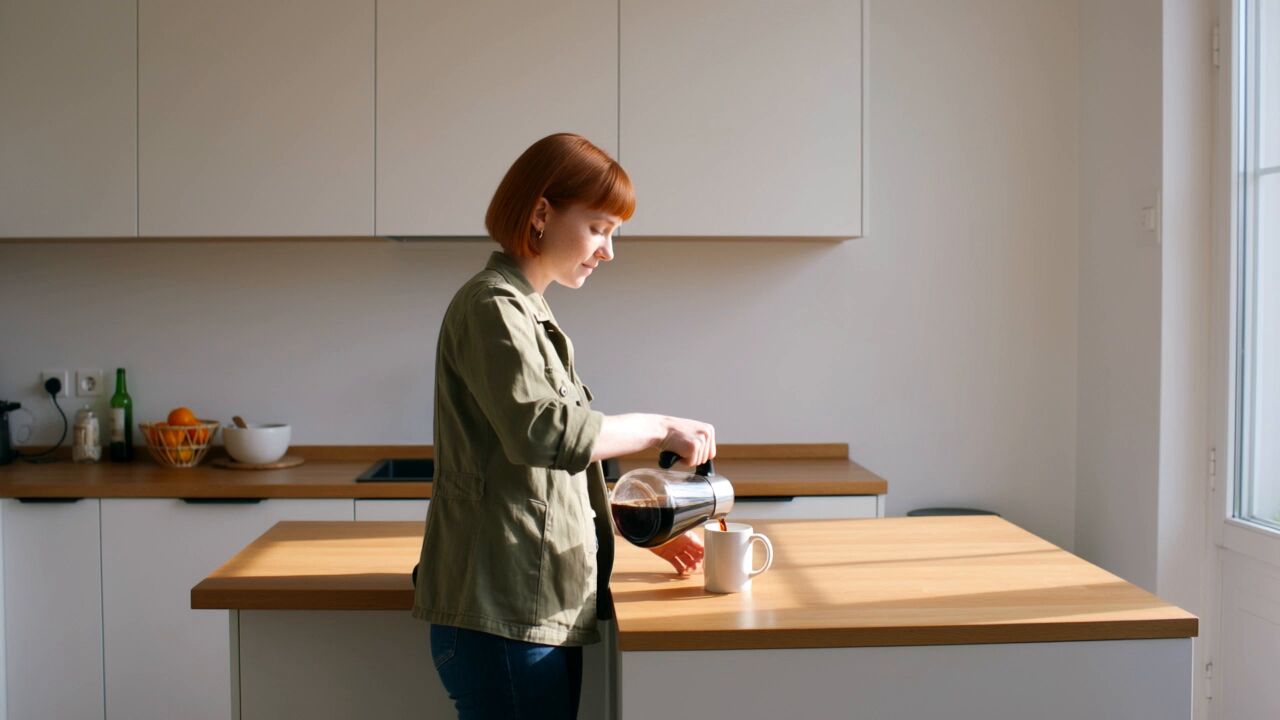
네. 각각 따로 피사체로 저장하고, 둘 다 상자에 넣은 뒤 프롬프트에 둘의 이름을 쓰면 돼요. 이 페이지 맨 위 클립처럼요. 카페에서 Mia가 NOIR 07을 들고 있어요.
여러 이미지로 영상 만드는 AI는 슬라이드쇼와 같은가요?
아니요. 슬라이드쇼는 사진을 차례로 보여 줄 뿐이에요. 멀티 레퍼런스 모델은 사진을 피사체에 대한 설명으로 읽고, 새로운 각도와 움직임, 사진에 없던 장면이 담긴 새 영상을 만들어요.
어떤 모델을 고르면 되나요?
인물이나 여러 피사체가 섞인 장면이라면 Kling 4로 시작하세요. 사진 최대 10장, 3~30초, 소리 포함이에요. 제품만 있다면 Seedance 2.5와 Wan 3.0도 30초까지 클립을 만들어요. 저장한 피사체는 모든 모델에서 쓸 수 있으니, 같은 사진을 두 모델에서 시험해 볼 수 있어요.