텍스트를 영상으로 AI: 프롬프트로 만드는 클립, 필요할 땐 같은 캐릭터로 - RefVid
일어날 장면을 적으면 몇 분 만에 영상으로 · 첫 영상 무료, 워터마크 없음
첫 영상 무료, 카드 불필요
네, RefVid는 글만으로 영상을 만들어요. 장면에 누가 나오는지, 어디서 벌어지는지, 카메라가 어떻게 움직이는지 적으면 모델이 그 설명만으로 모든 걸 그려요. Kling 4, Kling 3.0 Omni를 비롯해 스튜디오의 대부분 모델에서 쓸 수 있고, 카드 없이 무료로 시작하며 워터마크도 붙지 않아요. 프롬프트는 클립마다 피사체를 새로 만들어 내기 때문에, 사람이나 제품이 다시 나와야 한다면 사진 1~5장을 추가하세요. 같은 프롬프트로도 그 피사체가 그대로 유지돼요.
사진 없이 프롬프트 3개
텍스트를 영상으로 바꾸는 AI의 원리
- 텍스트-투-비디오 모델은 프롬프트를 읽고 그것만으로 모든 프레임을 생성해요. 사람, 장소, 빛, 카메라 움직임까지요. 사진을 움직이는 게 아니에요. 그래서 아이디어에서 클립까지 가장 빠른 길이지만, 클립마다 피사체가 바뀌는 이유이기도 해요.
- 글은 한 사람이 아니라 하나의 유형을 묘사해요. "20대 후반, 구릿빛 붉은 단발에 주근깨가 있는 여성"에 맞는 얼굴은 수천 개이고, 모델은 실행할 때마다 그중 하나를 골라요. 단일 샷이나 분위기 컷, B롤이라면 상관없어요. 하지만 시리즈, 광고, 같은 얼굴이 반복해 나오는 이야기라면 문제가 돼요.
RefVid에서 텍스트로 영상 만들기 AI: 글만으로 시작하기
- 요소 없이 스튜디오를 열고 프롬프트를 쓴 뒤 '생성'을 누르세요. 모델, 길이, 화면 비율(16:9, 9:16, 1:1), 소리 포함 여부는 직접 정해요. 클립은 보통 2~10분이면 완성돼 내 영상에 들어오고, 워터마크 없이 바로 내려받을 수 있어요.
- 길이는 모델마다 달라요. 기본 모델인 Kling 4는 3~30초, Kling 3.0 Omni는 최대 15초예요. 프롬프트가 장면 전체를 담아야 하므로, 참고 사진을 바탕으로 쓰는 프롬프트보다 길어져요.
Kling text to video와 다른 모델들
- Kling 4와 Kling 3.0 Omni 모두 텍스트-투-비디오 모드가 있고, '텍스트만'을 고르면 RefVid가 이 모드를 사용해요. Kling 4는 항상 소리가 함께 나오고 최대 30초까지, Kling 3.0 Omni는 더 저렴하고 무음 클립도 만들 수 있어요.
- Seedance 2.5, Wan 3.0, Gemini Omni Flash, PixVerse C1, Happy Horse 1.1도 글만으로 클립을 만들어요. 예외는 Vidu Q4로, RefVid에서는 피사체가 있어야만 작동해요. 같은 프롬프트를 두 모델에서 돌려 보면 어느 쪽이 그 장면에 맞는지 금방 알 수 있어요.
글만으로 만드는 영상 프롬프트 예시
- 글만으로 만드는 영상의 좋은 프롬프트는 피사체를 구체적으로 묘사하고, 동작은 하나만 주고, 카메라의 위치와 움직임을 알려 줘요. 빛과 렌즈는 마지막이에요. 신경 쓰지 않는 요소는 빼세요. 디테일이 하나 늘 때마다 모델은 그걸 몇 초 안에 담아내야 하니까요.
- 캐릭터 예시: "20대 후반 여성, 구릿빛 붉은 단발에 일자 앞머리, 옅은 주근깨, 올리브그린 유틸리티 재킷 차림으로 골든아워의 바람 부는 해변에 서 있다. 바다를 바라보다가 카메라를 힐끗 본다. 미디엄 샷에서 클로즈업으로 천천히 푸시인, 따뜻한 역광."
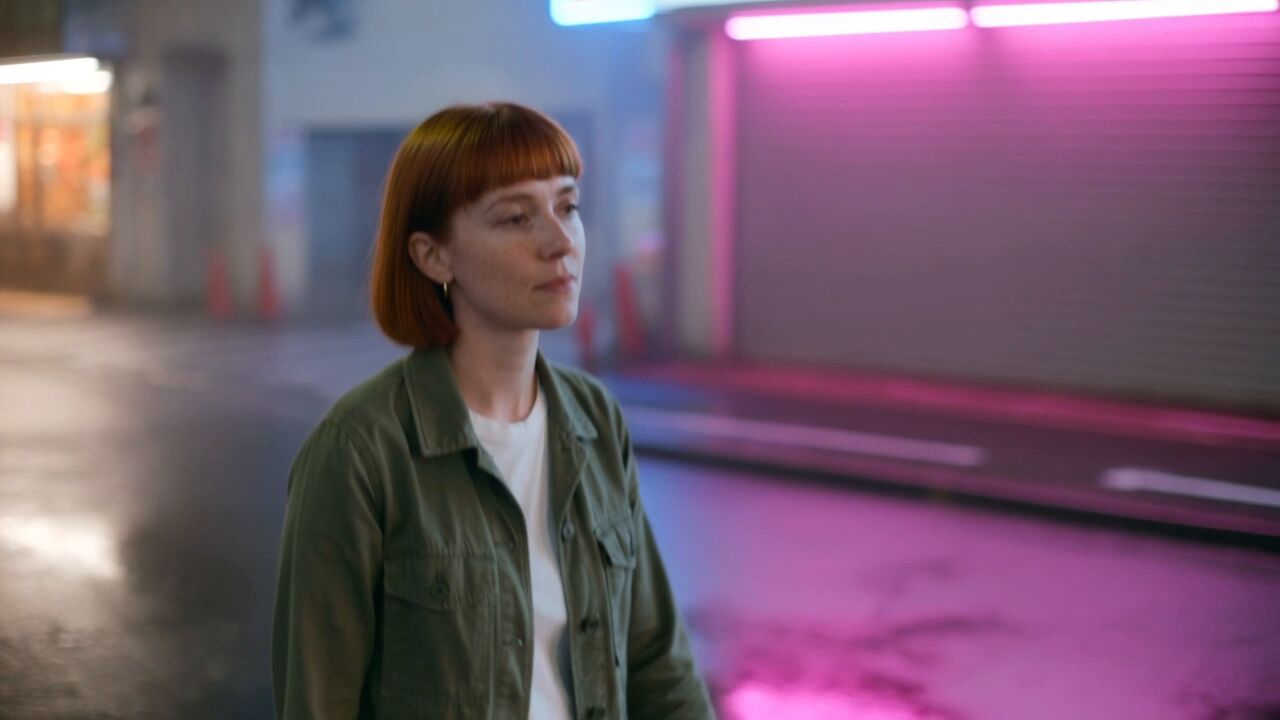
- 트래킹 카메라 예시로, 이 페이지 맨 위 클립에 쓴 프롬프트예요: "…가랑비 내리는 밤, 네온이 비치는 도쿄 골목을 걷는다. 젖은 아스팔트에 분홍빛과 푸른빛 네온이 반사된다. 그녀가 걷는 동안 카메라는 어깨 높이에서 나란히, 부드러운 측면 돌리로 따라간다. 시네마틱, 얕은 피사계 심도."
같은 캐릭터가 다시 나와야 할 때
사진을 추가하세요. RefVid는 바로 이걸 위해 만들어졌어요. 사람이나 제품을 사진 1~5장으로 한 번 저장해 두면, 어떤 프롬프트를 쓰든 그 얼굴, 옷차림, 로고, 라벨이 유지돼요. 프롬프트는 장면만 묘사하면 되고 피사체는 사진에서 가져오기 때문에, 어떤 장소에서든, 사진에 없는 각도에서도 그려져요.
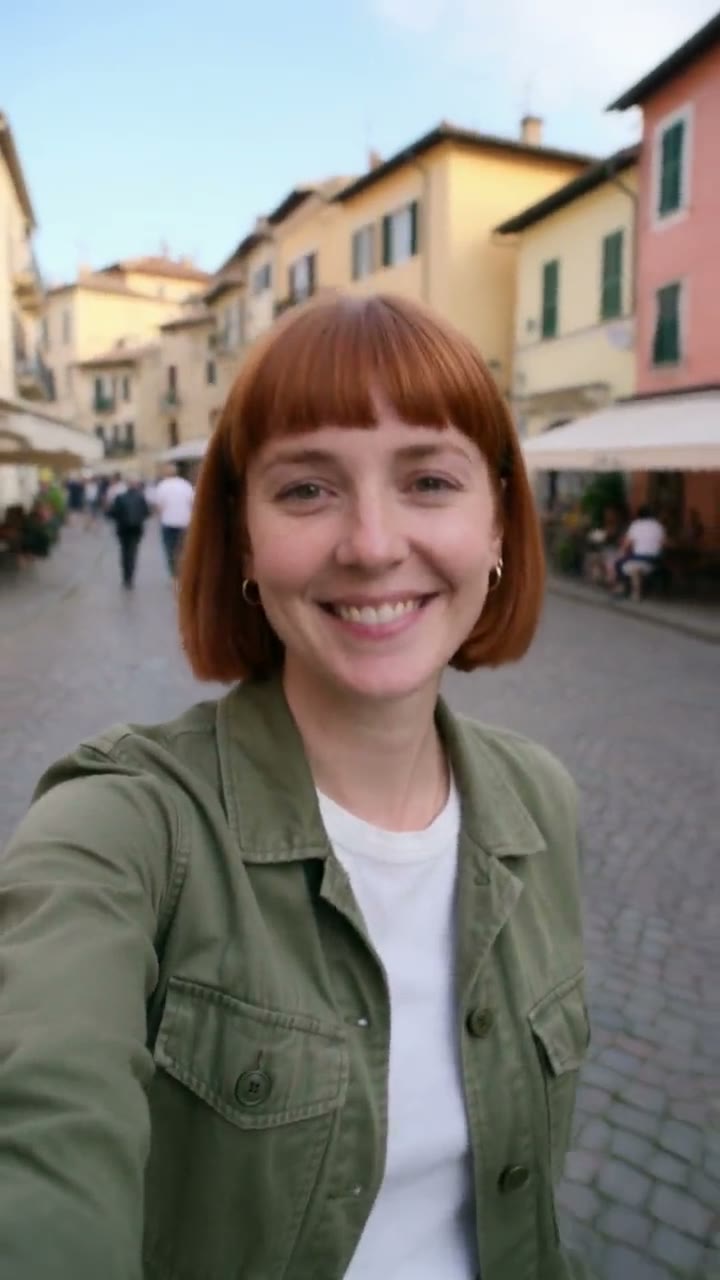
아래는 페이지 맨 위의 세 장면을 같은 모델로 다시 만든 결과예요. 이번에는 글 묘사 대신 그녀의 사진 4장을 썼어요. 맨 위에서는 클립마다 다른 여성이 나오지만, 아래에서는 한 사람이에요.
참고 사진 4장
무료로 시작, 워터마크 없음
- 글만으로 만든 영상도 피사체가 있는 영상과 드는 크레딧이 같고, 새 계정은 무료로 시작해요. 새 계정은 Kling 3.0 Omni 5초 영상 1개를 카드 없이 무료로 받아요. 무료 크레딧은 무음 클립용이고, 소리를 넣으려면 유료 크레딧이 필요해요.
- 모든 영상은 모델이 만든 깨끗한 파일 그대로, 워터마크 없이 내려받을 수 있어요. 무료로 시작할 때도, 유료 요금제에서도 마찬가지예요. 클립을 한곳에 저장할 수 있도록 Google이나 이메일로 무료 계정을 만들어야 해요.
쓰기 전에 클립을 확인하세요
- 올리기 전에 모든 클립을 원래 크기로 확인하세요. 손, 움직이는 얼굴, 화면 속 글자는 모델이 여전히 가장 자주 틀리는 부분이에요. 한 번은 이상하고 다음 번은 괜찮다면 그건 우연이에요. 프롬프트를 고치기 전에 같은 프롬프트로 다시 생성해 보세요. 생성된 인물을 실제 인물처럼 내세우지 마세요.
사용법 가이드 더 보기
자주 묻는 질문
텍스트를 영상으로 AI, 무료로 워터마크 없이 쓸 수 있나요?
네. RefVid는 카드 없이 무료로 시작하고, 무료든 유료든 영상에 워터마크가 붙지 않아요. 무료 크레딧으로는 Kling 3.0 Omni에서 짧은 무음 클립을 만들 수 있고, 더 긴 클립과 소리는 유료 크레딧을 써요.
프롬프트로 영상을 만들려면 가입해야 하나요?
네, Google이나 이메일로 무료 계정을 만들면 되고 카드는 필요 없어요. 클립과 프롬프트가 계정에 저장되어 나중에 내려받거나 프롬프트를 다시 쓸 수 있어요.
Kling text to video는 어떤 모델을 골라야 하나요?
최고 품질, 최대 30초 클립, 소리를 원하면 Kling 4예요. 소리는 항상 들어가요. 최대 15초 클립을 더 저렴하게 만들려면 Kling 3.0 Omni를 고르세요. 소리는 넣어도 빼도 돼요. 두 모델 모두 같은 프롬프트로 만들 수 있어요.
프롬프트에 쓴 인물이 다음 클립에서도 똑같이 나오나요?
대개는 아니에요. 하나의 묘사에 맞는 얼굴은 많고, 모델은 매번 그중 하나를 골라요. 사람이나 제품을 클립마다 똑같이 유지하려면 사진 1~5장으로 저장하고 '텍스트만' 대신 그걸 고르세요.
프롬프트로 만드는 클립은 얼마나 길게 만들 수 있나요?
Kling 4는 3~30초, Kling 3.0 Omni는 최대 15초예요. 긴 이야기는 5~10초짜리 샷 여러 개로 나누는 게 더 잘 돼요.
글: Louis Chi