IA de vídeo com múltiplas referências - RefVid
Transforme suas próprias fotos em vídeos em minutos · Seu primeiro vídeo é grátis, sem marca d'água





Primeiro vídeo grátis, sem cartão
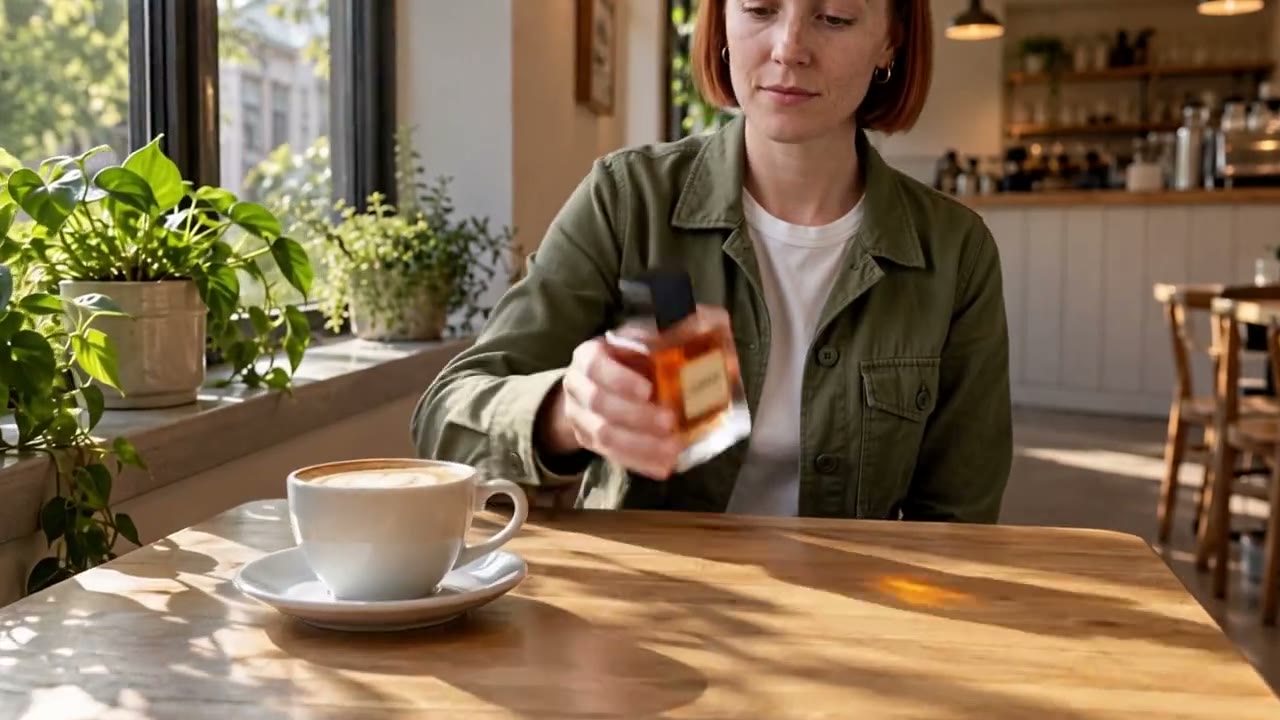
Uma IA de vídeo com múltiplas referências cria um único clipe a partir de várias imagens de referência: um personagem, um produto e um fundo, cada um com as próprias fotos, todos na mesma tomada.
Salve cada pessoa ou produto uma vez com 1 a 10 fotos, adicione até 3 deles na caixa acima com até 7 imagens de lugares ou estilos, escreva o que acontece e clique em Gerar. Seu primeiro clipe de 5 segundos no Kling 3.0 Omni é grátis, sem marca d'água.
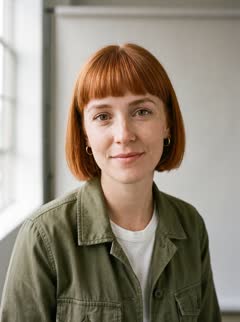
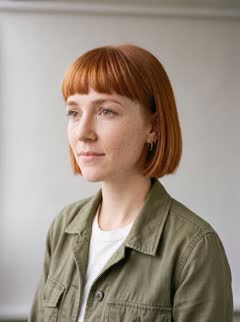
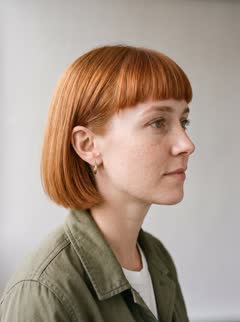
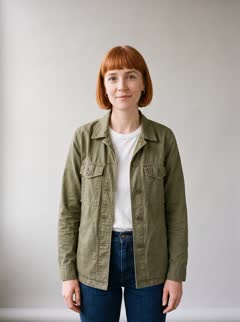
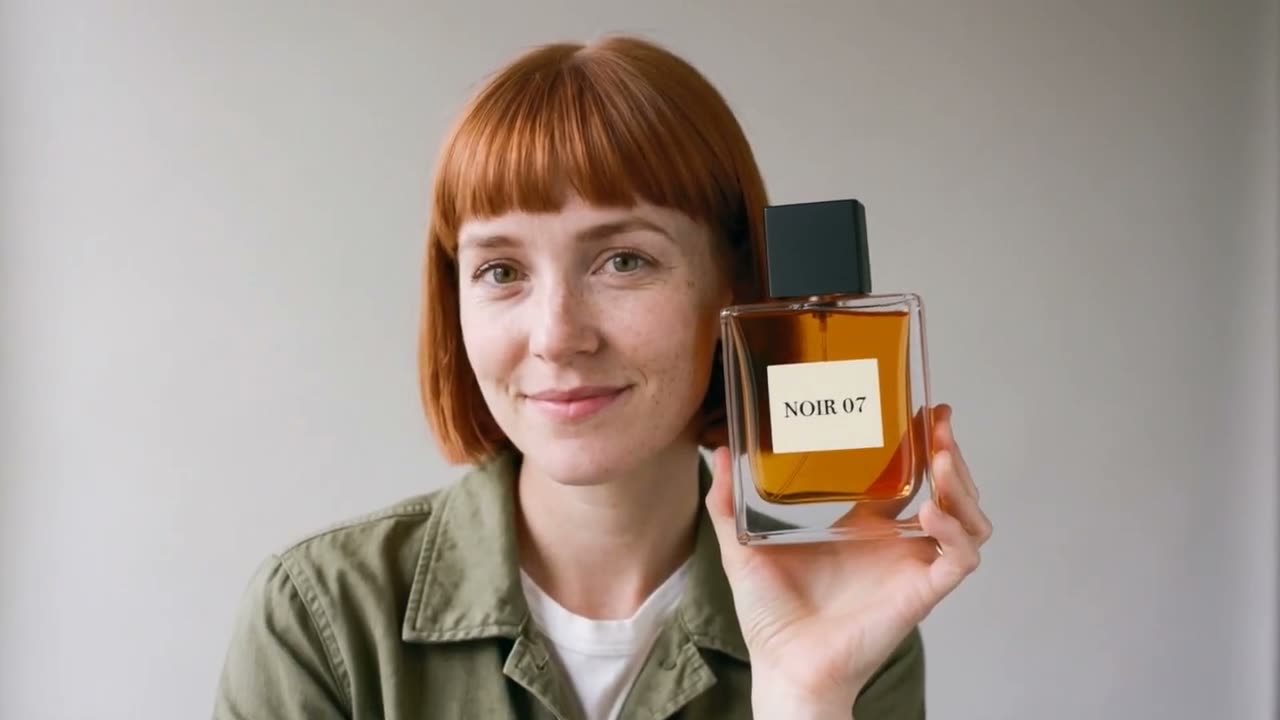
Mia: 4 fotos
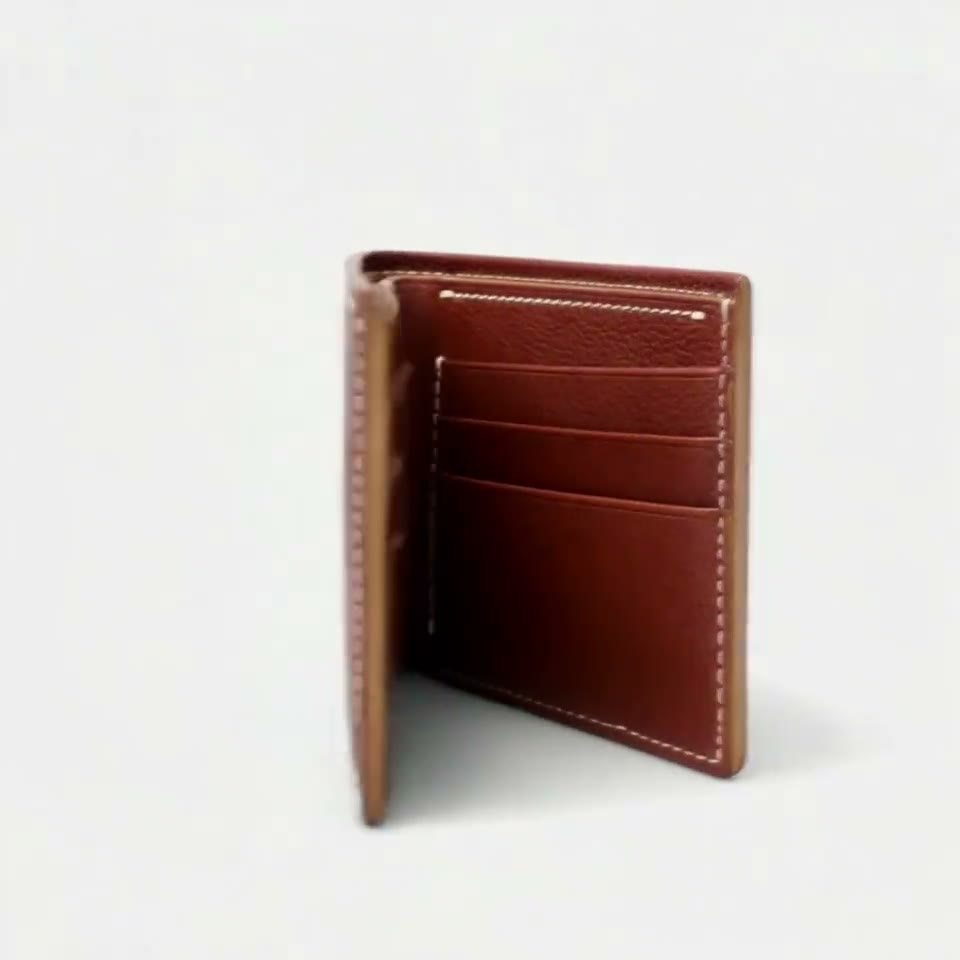
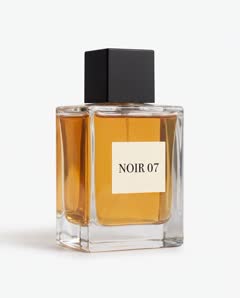
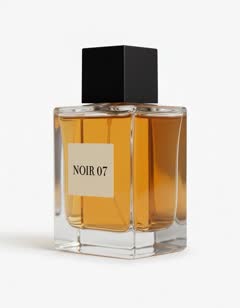
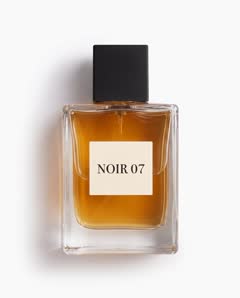
NOIR 07: 3 fotos
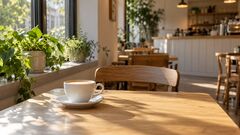
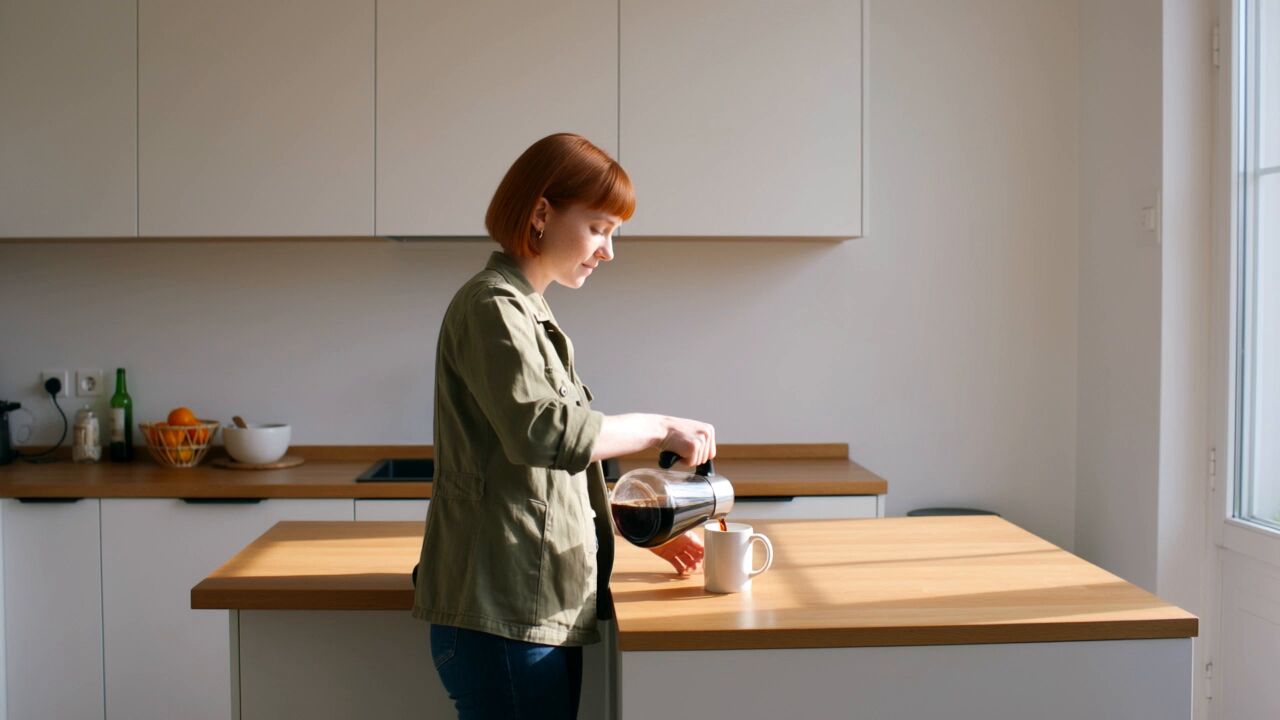
Fundo: 1 foto de um café
O que a IA de vídeo com múltiplas referências faz
- Um modelo de múltiplas referências recebe de uma vez imagens de referência de várias coisas, as pessoas, os produtos e o lugar, e gera uma cena nova que mantém todos eles. Cada sujeito fica com as próprias fotos, então uma pessoa pode segurar o seu produto e os dois continuam iguais.
- Não é o mesmo que imagem para vídeo, que anima uma única imagem como primeiro quadro, nem que quadros inicial e final, que fixam momentos exatos. As referências descrevem quem e o que precisa aparecer; o prompt decide o que acontece.
Crie um vídeo com múltiplas referências em 3 passos
- 1. Salve cada sujeito com 1 a 10 fotos: a pessoa, o produto, o pet. Na caixa acima, adicione até 3 sujeitos salvos e até 7 imagens de um lugar, um visual ou um estilo.
- 2. Escreva a cena e chame cada referência pelo nome, por exemplo: @Mia pega @NOIR07 da mesa do café e vira o rótulo para a câmera. O RefVid diz ao modelo quais fotos pertencem a cada sujeito, então você só escreve a cena.
- 3. Clique em Gerar. Se você não estiver conectado, entra primeiro e o clipe começa logo em seguida. Um clipe costuma levar de 2 a 10 minutos, e avisamos você por e-mail quando estiver pronto.
Várias imagens para vídeo com IA: um sujeito, muitas fotos
- Várias fotos do mesmo sujeito também contam como múltiplas referências: a frente, a lateral e a parte de trás de um produto, ou três ângulos de um rosto. O modelo lê as fotos juntas como um só sujeito, então consegue girar o produto ou a pessoa sem inventar o lado que nunca viu.
- De três a cinco fotos nítidas por sujeito costumam bastar. Fotos que não batem entre si, como duas roupas ou duas iluminações diferentes, pioram o resultado em vez de melhorar.
Em quais modelos funciona
- Todo modelo que o RefVid roda é um modelo de referência, 9 no total, pela fal.ai. O Kling 4, o padrão, aceita até 10 fotos e faz clipes de 3 a 30 segundos com som. O Kling 3.0 Omni custa menos por segundo em clipes de até 15 segundos. Wan 3.0 e Seedance 2.5 também chegam a 30 segundos; o Seedance 2.5 recusa fotos de pessoas com aparência real, então combina com produtos, pets e personagens ilustrados.
- Seu primeiro clipe é grátis: 5 segundos no Kling 3.0 Omni, sem cartão. Depois, um vídeo avulso custa a partir de US$ 2,99, um pacote de créditos único a partir de US$ 9,90 e um plano mensal a partir de US$ 10; os créditos nunca expiram.
Mais sobre modelos de vídeo com IA
Reference to video →
Perguntas frequentes
Existe IA de vídeo com múltiplas referências grátis?
No RefVid, seu primeiro clipe é grátis: 5 segundos no Kling 3.0 Omni, sem cartão e sem marca d'água, a partir dos seus próprios sujeitos salvos. Depois, um vídeo avulso custa a partir de US$ 2,99, um pacote de créditos a partir de US$ 9,90 e um plano a partir de US$ 10 por mês.
Quantas referências um clipe pode usar?
No RefVid, um clipe aceita até 3 sujeitos salvos, cada um com até 10 fotos, mais até 7 imagens de lugares ou estilos. O limite do próprio modelo também vale: o Kling 4 aceita até 10 imagens por pedido.
Posso colocar uma pessoa e um produto no mesmo vídeo?
Sim. Salve cada um como um sujeito próprio, adicione os dois na caixa e cite os dois no prompt, como no clipe do topo desta página, em que Mia segura o NOIR 07 em um café.
Várias imagens para vídeo com IA é o mesmo que uma apresentação de slides?
Não. Uma apresentação de slides mostra suas fotos uma depois da outra. Um modelo de múltiplas referências lê as fotos como descrição do sujeito e gera imagens novas: ângulos novos, movimento e uma cena que as fotos nunca mostraram.
Qual modelo de múltiplas referências devo escolher?
Comece pelo Kling 4 para pessoas e cenas mistas: até 10 fotos, de 3 a 30 segundos, com som incluído. Para um produto sozinho, Seedance 2.5 e Wan 3.0 também fazem clipes de até 30 segundos. Seus sujeitos salvos funcionam em todos os modelos, então dá para testar as mesmas fotos em dois.