マルチリファレンス動画AI - RefVid
自分の写真から数分で動画に · 最初の動画は無料、透かしなし





最初の動画は無料・カード不要
マルチリファレンス動画AIは、複数の参照画像から1本のクリップを作ります。キャラクター、商品、背景をそれぞれ専用の写真から読み込み、すべてを同じショットに収めます。人物や商品はそれぞれ1〜10枚の写真から一度保存し、上のボックスに最大3つまで追加して、場所やスタイルの画像も最大7枚まで加えます。あとは起きることを書いて「生成」を押すだけです。Kling 3.0 Omniによる最初の5秒のクリップは無料で、透かしも入りません。
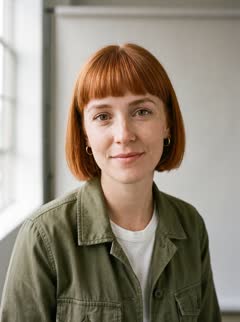
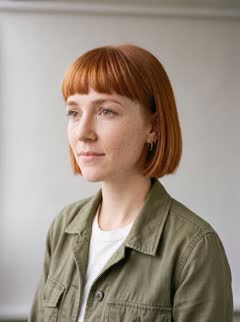
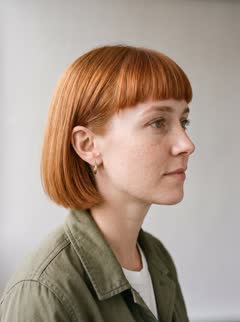
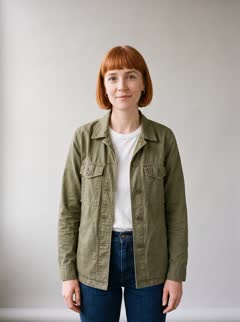
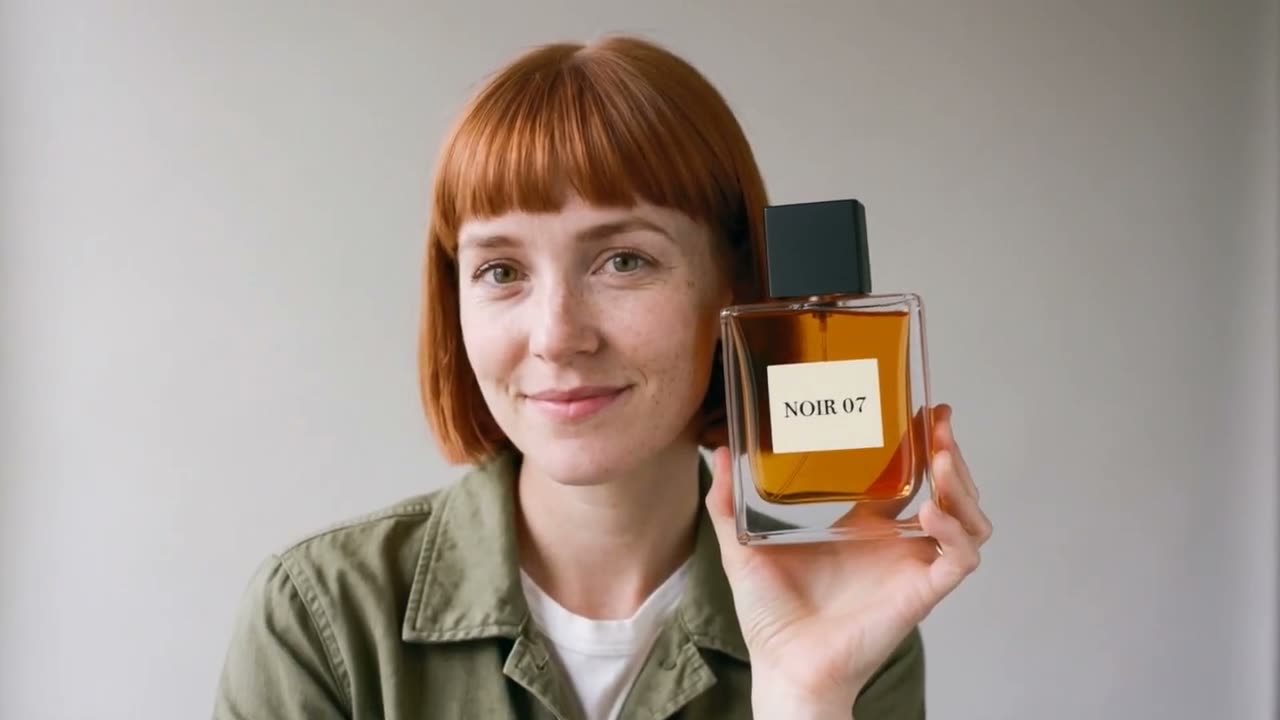
Mia:写真4枚
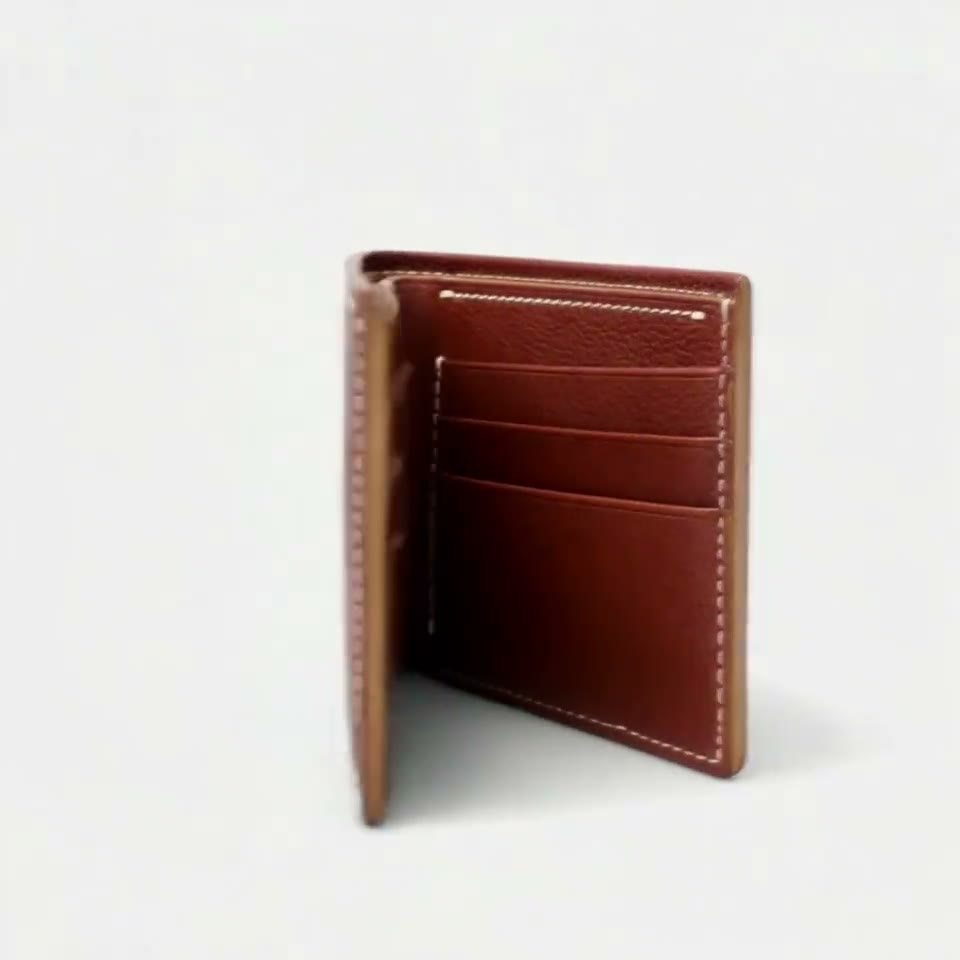
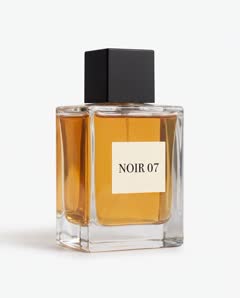
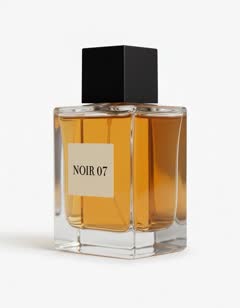
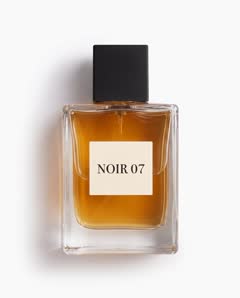
NOIR 07:写真3枚
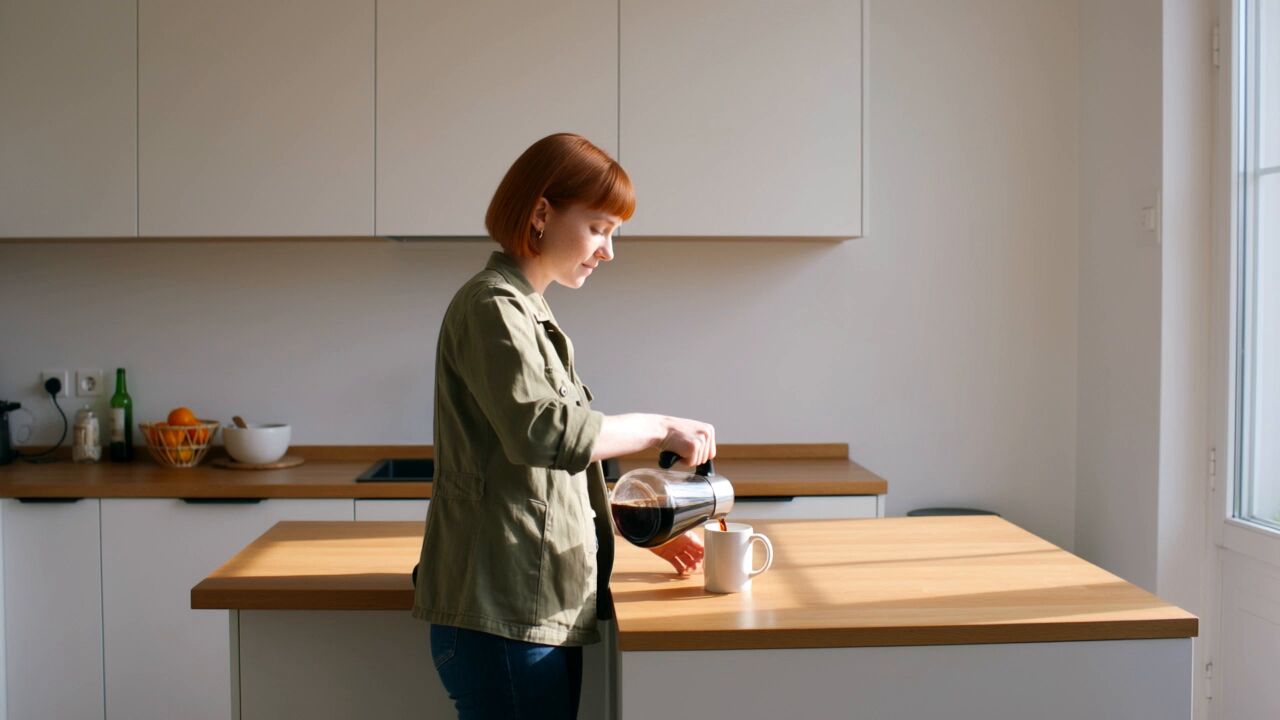
背景:カフェの写真1枚
マルチリファレンス動画AIでできること
- マルチリファレンスに対応したモデルは、人物、商品、場所など複数の対象の参照画像を一度に受け取り、そのすべてを保ったまま新しいシーンを1つ生成します。被写体ごとに専用の写真があるので、人物があなたの商品を手に持っても、どちらも元の姿のままです。
- 1枚の画像を最初のフレームとして動かす画像から動画(image to video)とも、特定の瞬間を固定する開始・終了フレームとも違います。参照画像は登場させる人や物を伝え、何が起きるかはプロンプトが決めます。
3ステップで作る方法
- 1. 人物、商品、ペットなど、被写体ごとに1〜10枚の写真から保存します。上のボックスに保存済みの被写体を最大3つ、場所や雰囲気、スタイルの画像を最大7枚まで追加します。
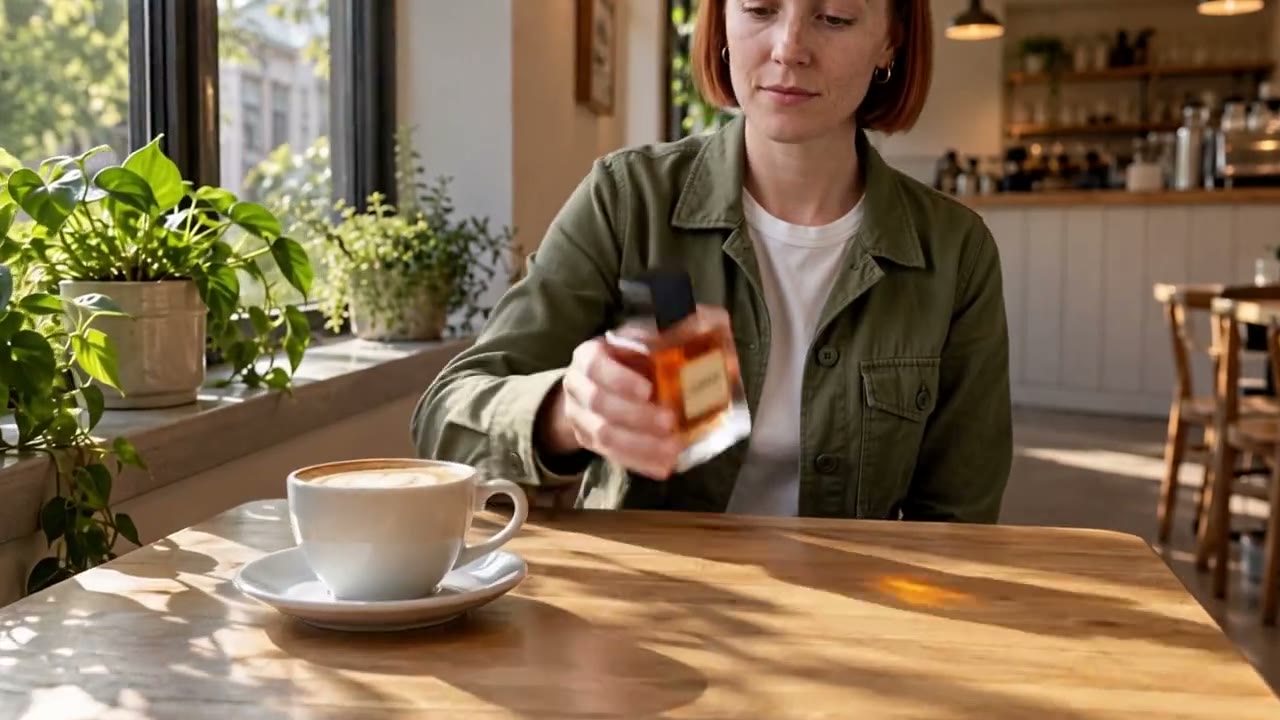
- 2. シーンを書き、それぞれの参照を名前で呼びます。たとえば「@Miaがカフェのテーブルから@NOIR07を手に取り、ラベルをカメラに向ける」のように書きます。どの写真がどの被写体のものかはRefVidがモデルに伝えるので、書くのはシーンだけです。
- 3. 「生成」を押します。サインインしていない場合は先にサインインすると、そのままクリップの生成が始まります。生成には通常2〜10分かかり、完成したらメールでお知らせします。
複数画像から動画を作るAI:1つの被写体に複数の写真
- 同じ被写体を写した複数の写真もマルチリファレンスです。1つの商品の正面・側面・背面や、1人の顔の3つの角度などです。モデルはそれらをまとめて1つの被写体として読み取るので、見たことのない側面を想像で補わずに、商品や人物の向きを変えられます。
- たいていは被写体ごとにシャープな写真が3〜5枚あれば十分です。服装が2通りある、照明が2種類あるなど、食い違う写真はかえって結果を悪くします。
対応しているモデル
- RefVidが動かすモデルはすべて参照対応のモデルで、fal.ai経由で全部で9あります。標準のKling 4は最大10枚の写真を受け付け、音声付きで3〜30秒のクリップを作ります。Kling 3.0 Omniは15秒までのクリップなら1秒あたりの料金が安くなります。Wan 3.0とSeedance 2.5も30秒まで対応しています。Seedance 2.5は実在の人物に見える写真を受け付けないため、商品、ペット、イラストのキャラクターに向いています。
- 最初のクリップは無料です。Kling 3.0 Omniで5秒、カード登録は不要です。その後は、単品の動画が$2.99から、買い切りのクレジットパックが$9.90から、月額プランが$10からです。クレジットに有効期限はありません。
AI動画モデルについてもっと読む
Reference to Video →
よくある質問
無料で使えるマルチリファレンス動画AIはありますか?
RefVidでは最初のクリップが無料です。ご自身の保存済みの被写体から、Kling 3.0 Omniで5秒、カード登録も透かしもありません。その後は、単品の動画が$2.99から、クレジットパックが$9.90から、プランが月額$10からです。
1本のクリップでいくつの参照を使えますか?
RefVidでは1本のクリップに保存済みの被写体を最大3つ(それぞれ最大10枚の写真)、さらに場所やスタイルの画像を最大7枚使えます。これに加えてモデル側の上限もあり、Kling 4は1回のリクエストで最大10枚の画像を受け付けます。
人物と商品を同じ動画に入れられますか?
はい。それぞれを別の被写体として保存し、両方をボックスに追加して、プロンプトで両方の名前を書きます。このページ上部の、カフェでMiaがNOIR 07を持っているクリップがその例です。
複数画像から動画を作るAIはスライドショーと同じですか?
いいえ。スライドショーは写真を順番に表示するだけです。マルチリファレンス対応のモデルは写真を被写体の説明として読み取り、新しいアングルや動き、写真にはないシーンを含む新しい映像を生成します。
どのモデルを選べばいいですか?
人物や複数の被写体が混ざるシーンなら、まずKling 4がおすすめです。写真は最大10枚、長さは3〜30秒、音声付きです。商品だけなら、Seedance 2.5とWan 3.0も30秒までのクリップを作れます。保存した被写体はどのモデルでも使えるので、同じ写真を2つのモデルで試せます。