参照動画:仕組みと上手な使い方
参照動画(Reference-to-video)は、人物・商品・マスコットなど被写体の画像を複数枚与え、その被写体が登場する新しいシーンを生成するAI動画の手法です。画像は動かすための最初のフレームではなく、どんな人物や物が映るべきかを示す情報として使われます。このページでは、この方式の仕組み、2026年10月時点で対応しているモデル、そして使える動画と惜しい動画を分けるポイントを説明します。
参照画像をアップロード参照写真3枚
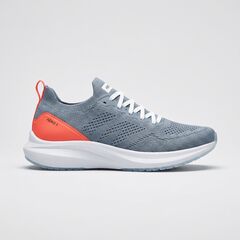
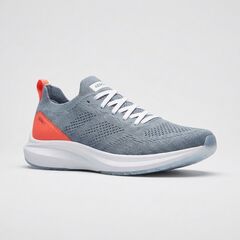
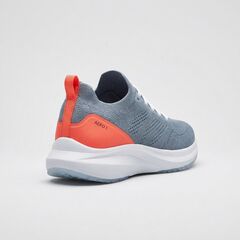
3つのシーン、同じシューズ
参照動画とテキスト動画・画像動画の違い
テキストからの動画生成は、言葉だけを出発点にします。被写体の見た目はモデルが決めるため、同じプロンプトでも毎回別人の動画になることがあります。
画像からの動画生成は、1枚の画像を起点にして動かす方式です。最初のフレームは元画像と一致します。ただし、顔の横側など画像に写っていない部分はカメラが動くにつれて補われ、新しいシーンを作るたびに開始画像が必要になります。
参照動画は被写体とシーンを分けて扱います。参照画像で「誰か」を指定し、プロンプトで「どこで、何が起き、カメラがどう動くか」を指定します。モデルは、どの画像にも写っていない場所や角度に被写体を置きながら、同一人物・同一商品であることを保てます。そのため、シリーズもの、広告、短編ストーリーに向いています。
言葉のみ:同じ説明文で生成
参照写真4枚で生成
モデルが参照画像を読み取る仕組み
多くの参照対応モデルでは、プロンプト内で各入力画像を指定できます。KlingのOmniモデルは、同一被写体の画像を1つのエレメントにまとめ、@Element1のように呼び出します。ほかのモデルは画像の順番で指定する場合もあります。1つのショットに被写体が2つある場合は、名前で指定することが重要です。どの画像が人物で、どれが商品かをモデルに伝えられます。
モデルは、特に指定しない限り参照画像に写っているものすべてを被写体の一部として扱います。ウォーターマーク、雑然とした背景、強い色フィルターが出力に混入することがあります。参照画像は多ければよいわけではなく、きれいな画像を使うことが大切です。
対応モデル(2026年10月時点)
Kling 3.0 Omniは、Kling公式ガイドによると、参照画像を最大7枚、または3〜10秒の参照動画1本と画像最大4枚を受け付けます。1リクエストあたり最長15秒を720pまたは1080pで生成し、KlingのAPIやfal.aiなどのプロバイダーで利用できます。
Kling 4.0は2026年10月15日にKlingの自社アプリで公開されました。Klingのガイドでは、1リクエストあたり最大15件の参照入力(画像は最大10枚)と、3〜30秒のクリップに対応するとされています。開発者向けAPIは現在「近日公開」の表示です。
Google Veo 3.1はこの方式を「Ingredients to Video」と呼んでいます。Googleのドキュメントでは、1人の人物・キャラクター・商品に対する参照画像を最大3枚まで受け付け、参照を使った生成は常に8秒です。
ByteDanceのSeedance 2.5とMiniMax H3も複数参照モードを提供しています。上限はAPIプロバイダーごとに異なるため、利用するサービスで確認してください。
参照画像の選び方:簡単なチェックリスト
人物の場合:正面、斜め45度、横顔、そして眼鏡やタトゥーなど特徴的な部分のクローズアップを1枚ずつ用意します。どの画像でも服装と髪型は同じにします。
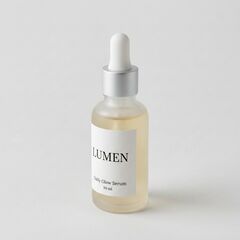
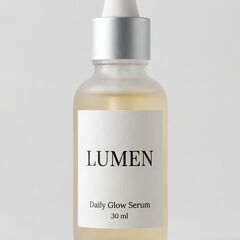
商品の場合:主要なアングル、背面または側面、ロゴやラベルの鮮明なクローズアップ、そして手に持つなど大きさがわかるカットを用意します。
照明はやわらかく均一に、背景はシンプルに、画像は原寸で鮮明なものを使います。フィルター、文字の重ね書き、強い圧縮は避けましょう。通常は、強い画像3〜5枚のほうが雑多な画像10枚より効果的です。モデルの上限が3枚なら、1枚で最も多くの特徴が伝わるアングルを選んでください。
人物:正面、斜め45度、横顔、全身
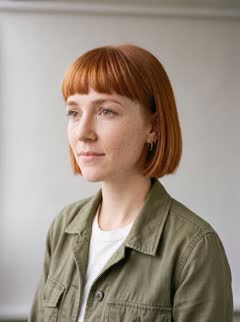
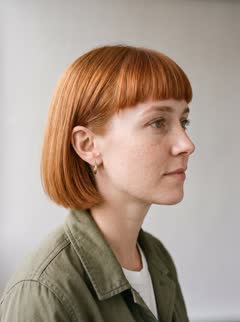
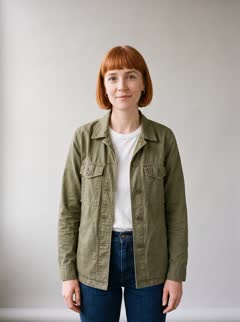
商品:正面、斜め45度、ラベルのクローズアップ
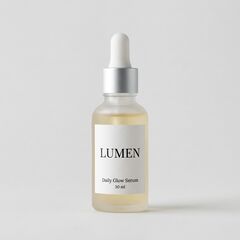
参照画像に合わせたプロンプトの書き方
プロンプトには被写体ではなくシーンを書きます。髪の色や服装は書かず、場所、動作、カメラ、光を説明します。例:「夕暮れの風の強いビーチに彼女が立ち、海を見つめ、それからカメラをちらりと見る。中景から近景へゆっくりプッシュイン。」
参照画像と矛盾する指示は避けましょう。画像が茶色の髪を示しているのに、プロンプトで金髪と書くと、モデルはどちらかを選ばざるを得ず、中途半端な結果になります。外見を変えたい場合は、新しい参照画像を用意してください。
1カットに動作は1つにしたほうがうまくいきます。歩く、振り向く、拾う、笑うを5秒に詰め込むと動きが速くなり、速い部分で人物の同一性が崩れやすくなります。
よくある失敗と対処法
被写体が顔をそむけると顔が変わってしまう。横顔の参照画像を追加してください。モデルは、一度も見せられていない角度を推測している状態です。
商品のラベルが描き直されてしまう。ラベルがショットの中心にならないように構図を変えるか、より鮮明なクローズアップを追加してください。小さな印字は、現在のモデルで最も弱い部分です。
参照画像の背景がシーンに出てしまう。その画像を無地の背景のものに差し替えてください。
一括生成の中で1本だけおかしい場合がある。たいていは偶然です。まず同じ入力で生成し直してください。
RefVidで試す
RefVidはこの方式を中心に作られています。サインインしてキャラクターまたは商品を作成し、主要なアングルを先頭にして参照画像を1〜5枚アップロードします。対応形式はJPG、PNG、WebPで、各画像は300px以上、10MB以下です。その後、シーンのプロンプトを書き、3〜15秒の長さを選んで生成します。動画はKling 3.0 Omniで生成され、通常2〜10分かかります。KlingのAPIが公開されたら、RefVidはKling 4.0に切り替えます。
よくある質問
- 参照動画は画像動画と同じですか?
- いいえ。画像動画は1枚の画像を最初のフレームとして動かします。参照モデルは複数の画像を被写体の説明として読み取り、その被写体を中心に新しいシーンを作るため、画像に写っていない場所や角度にも登場させられます。
- 参照画像は何枚使えばよいですか?
- 主要なアングルをカバーした、鮮明な画像3〜5枚が目安です。上限はモデルによって異なり、Veo 3.1は3枚、Kling 3.0 Omniは最大7枚です。
- 人物だけでなく商品でも使えますか?
- はい。主要なアングル、背面または側面、ロゴのクローズアップ、大きさがわかるカットを使ってください。小さな印字が中心にならない構図を選びましょう。
- RefVidで参照動画を作るといくらかかりますか?
- 1秒あたり31クレジットです。3秒は93クレジット、5秒は155、10秒は310、15秒は465です。最初の50アカウントには630クレジットが無料で付与され、5秒の動画4本分になります。それ以降のアカウントには100クレジットが付与され、3秒の動画1本分です。