マルチリファレンスとは - RefVid
自分の写真から数分で動画に · 最初の動画は無料、透かしなし





最初の動画は無料・カード不要
マルチリファレンスとは、AI動画で、登場させたい人物・商品・場所の参照画像を複数(モデルによっては動画や音声のクリップも)まとめてモデルに渡し、そのすべてを保った新しいシーンを生成させる方法です。画像は画面に映る人や物を伝え、プロンプトは何が起きるかを伝えます。上のボックスで実際に試せます。人物と商品の写真を追加し、シーンを書いて「生成」を押してください。Kling 3.0 Omniによる最初の5秒のクリップは無料です。
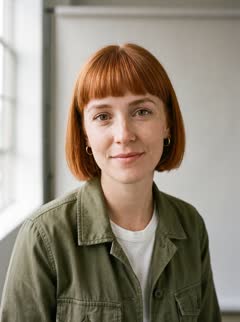
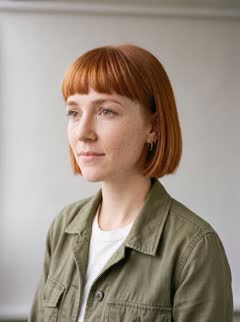
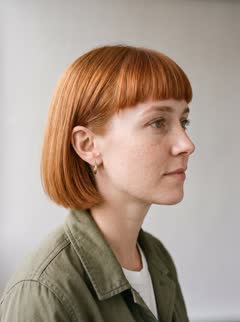
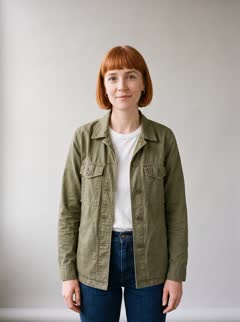
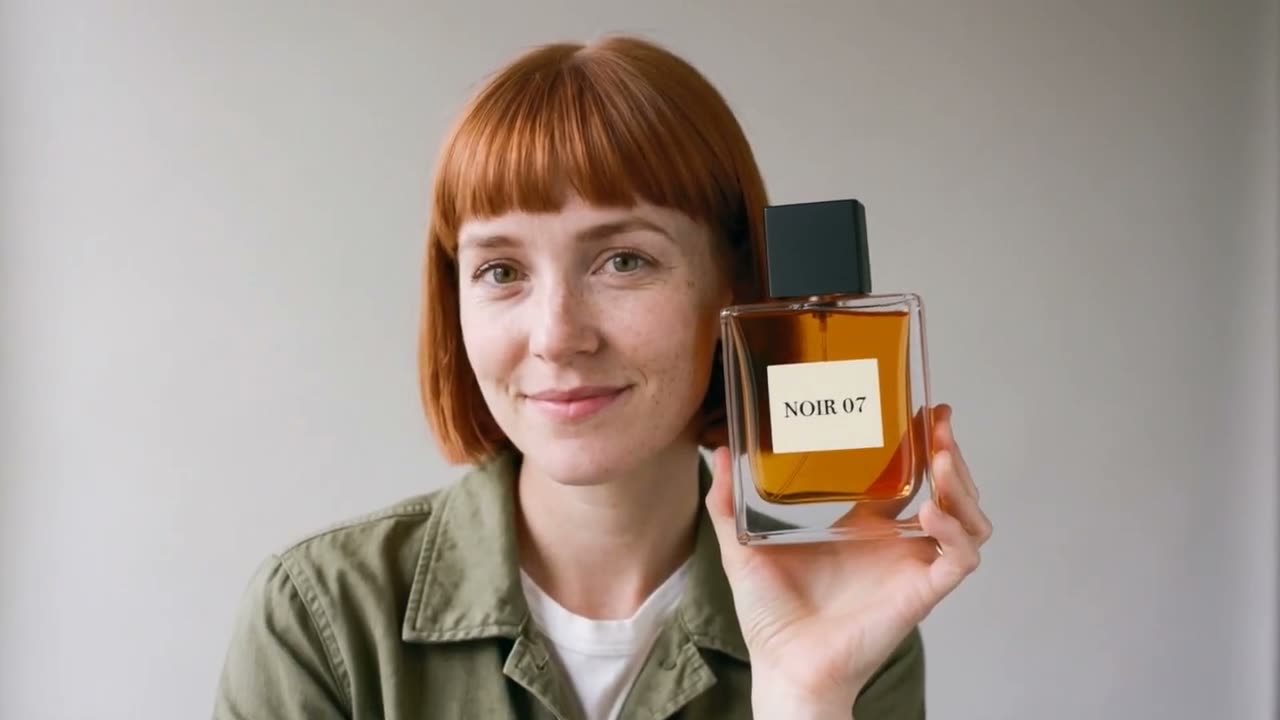
Mia:写真4枚
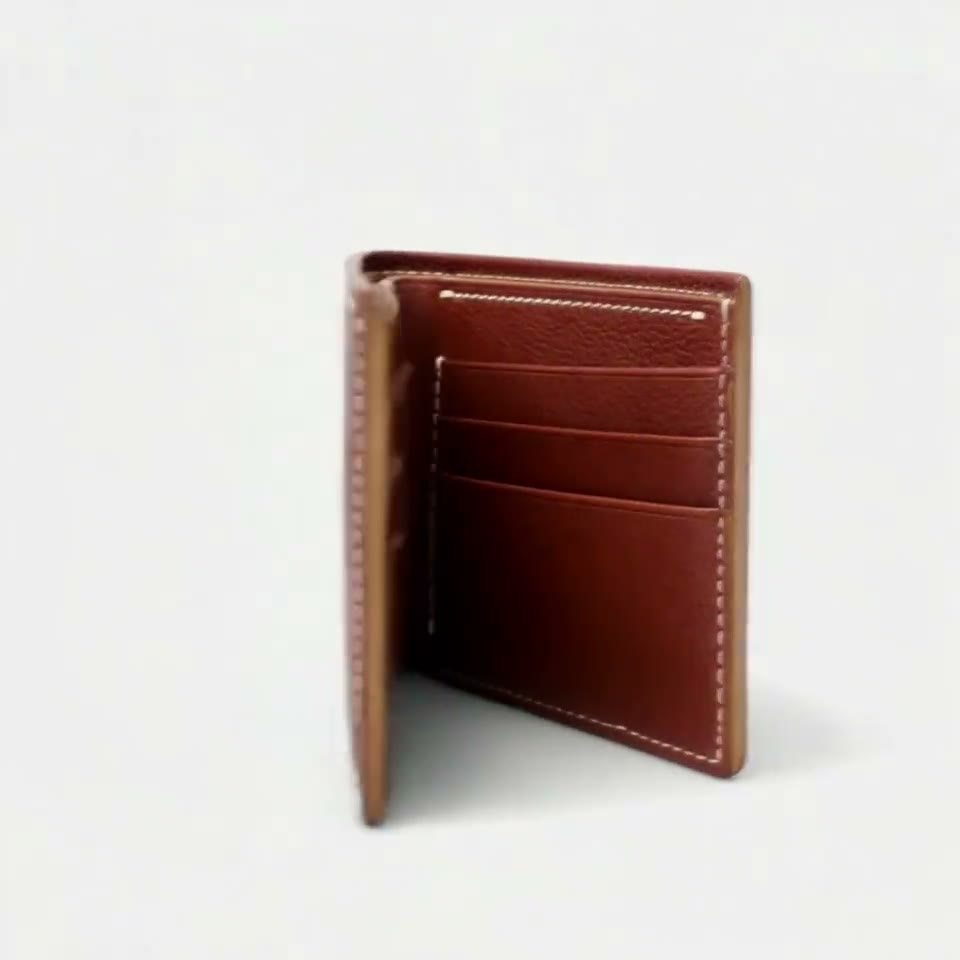
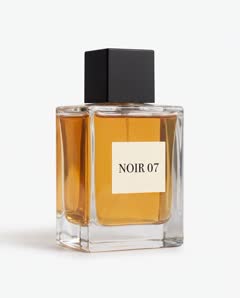
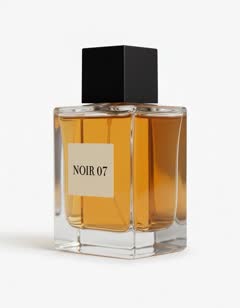
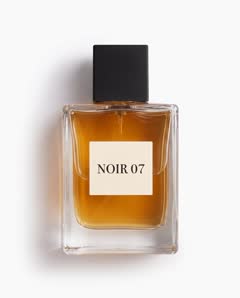
NOIR 07:写真3枚
マルチリファレンスの意味を2文で
- 一言でいえば、AIの画像・動画モデルに複数の参照ファイルを一度に渡すプロンプトの方法で、それぞれのファイルには結果に必ず登場させたいものが写っています。モデルはそれらを動かすフレームではなく被写体の説明として扱い、その周りに新しいシーンを組み立てます。
- シングルリファレンスでは、1つの被写体を写した画像を1枚使います。複数参照ではさらに、同じ顔の別アングル、2人目の人物、商品、背景、スタイル、そしてモデルによっては動きのクリップや声も加えられます。
画像から動画や開始フレームとの違い
- 画像から動画(image to video)は1枚の画像を動かし、その画像が最初のフレームになります。開始・終了フレームは、クリップの特定の瞬間を固定します。複数参照の方式はどちらも固定せず、残すべき人や物をモデルに伝えるだけなので、被写体を新しいアングルや写真にない場所に登場させられます。
- だからこそ、複数の参照を使えばキャラクターや商品を何本ものクリップで同じに保てます。どのクリップも同じ参照のセットから始まるからです。
対応している動画モデル
- Kling 4は最大10枚の参照画像を受け付け、KlingのOmni Referenceはそれらをエレメントにまとめて、どの写真が同じキャラクターかをモデルに伝えます。MiniMax H3は最大で画像9枚、動画クリップ3本、音声クリップ3本を受け付けます。Alibaba Cloudによると、Wan 3.0は最大で画像10枚、動画5本、音声クリップ5本です。ByteDanceとfal.aiによると、Seedance 2.5は最大30枚の画像を受け付けます。
- RefVidはこれらを含む参照対応のモデル、全部で9をfal.ai経由で動かし、保存した写真をそれぞれのモデルが求める形式で送ります。
3ステップで試す
- 1. 人物、商品、ペットなど、被写体ごとに1〜10枚の写真から保存します。上のボックスにそのうち最大3つと、場所やスタイルの画像を最大7枚追加します。
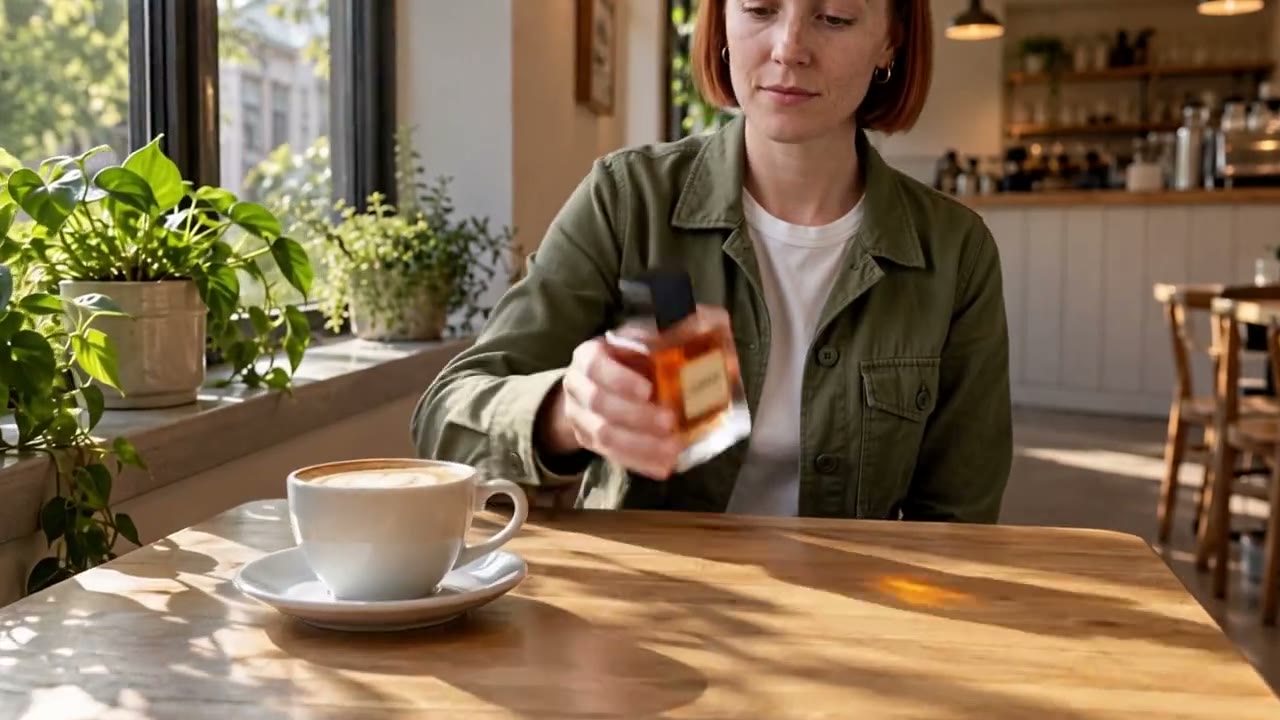
- 2. シーンを書き、それぞれの被写体を名前で呼びます。例:「@Miaがカフェのテーブルから@NOIR07を手に取り、ラベルをカメラに向ける」
- 3. 「生成」を押します。Kling 3.0 Omniによる最初の5秒のクリップは無料です。その後は、単品の動画が$2.99から、クレジットパックが$9.90から、プランが月額$10からです。
AI動画モデルについてもっと読む
Reference to Video →
よくある質問
AI動画のマルチリファレンスとは何ですか?
登場させたい人物・商品・場所の参照画像を複数(モデルによっては動画や音声のクリップも)動画モデルに渡すことです。モデルはそれらを被写体の説明として読み取り、その周りに新しいシーンを生成します。
複数参照はリファレンスシートと同じですか?
いいえ。リファレンスシートは、1人のキャラクターを複数の方向から描いた1枚の画像です。複数参照のリクエストでは、商品や場所の写真と並ぶ参照の1つとして使えます。
参照画像は何枚使えばいいですか?
被写体ごとに、主なアングルをカバーするシャープな画像を3〜5枚です。服装や照明が違う画像を足すと、かえって結果が悪くなります。
無料で試せますか?
はい。RefVidではKling 3.0 Omniによる最初の5秒のクリップが無料で、カード登録も透かしもありません。その後は、単品の動画が$2.99から、クレジットパックが$9.90から、プランが月額$10からです。
商品にも使えますか?
はい。商品をメインのアングル、背面、ロゴのアップから保存し、単独で、または人物と一緒にシーンに入れます。小さな印刷文字は、今のモデルがいちばん苦手な部分です。