Generadores de vídeo multirreferencia comparados
Un generador de vídeo multirreferencia toma varias imágenes, y a veces clips de vídeo o audio, de las personas, productos y lugares que quieres en una escena, y genera una escena nueva que los conserva. A octubre de 2026, los principales modelos con este modo son Kling 3.0 Omni, Kling 4.0, Google Veo 3.1, ByteDance Seedance 2.5 y MiniMax H3. Sus límites varían mucho, y también las herramientas construidas sobre ellos. Esta página explica qué acepta cada modelo y qué debes buscar en un generador.
Sube tus imágenes de referenciaMia: 4 fotos
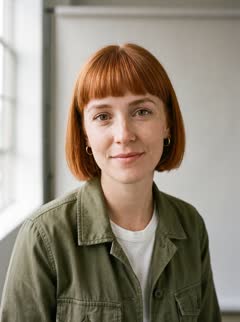
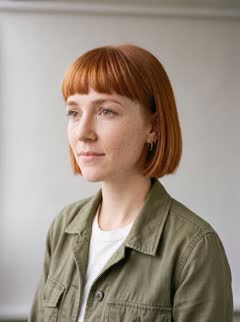
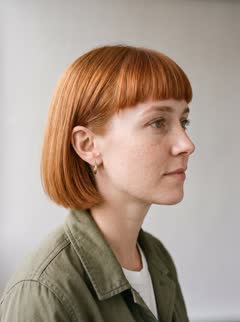
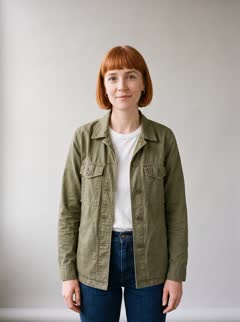
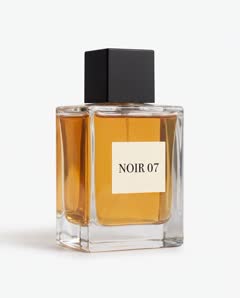
NOIR 07: 3 fotos
Multirreferencia frente a image-to-video
El image-to-video toma una imagen y la convierte en el primer fotograma. Es preciso en ese fotograma y menos fiable después, porque el modelo inventa todo lo que la imagen no muestra.
La generación multirreferencia no fija ningún fotograma. Lee todas las imágenes en conjunto como descripción de los sujetos y después compone una toma nueva. Eso tiene tres efectos prácticos. El sujeto puede aparecer desde ángulos que ninguna imagen muestra. Varios sujetos pueden compartir una toma, cada uno a partir de sus propias referencias. Y las mismas referencias se reutilizan en cada escena, algo que permite mantener la coherencia en una serie.
El precio de esto es el control sobre el primer fotograma exacto. Algunos modelos permiten combinar referencias con un fotograma inicial; otros no.
3 fotos de referencia
Lo que acepta cada modelo (a octubre de 2026)
Kling 3.0 Omni: hasta 7 imágenes o elementos de referencia, o un vídeo de referencia de 3 a 10 segundos más hasta 4 imágenes o elementos, según la guía de Kling. Clips de hasta 15 segundos a 720p o 1080p. Un elemento puede llevar una voz asociada. Disponible a través de la API de Kling y de fal.ai.
Kling 4.0: hasta 15 entradas de referencia en total, con hasta 10 imágenes, hasta 5 vídeos con 30 segundos combinados y hasta 7 elementos, con clips de 3 a 30 segundos, según la guía de Kling. Se lanzó en la app de Kling el 15 de octubre de 2026. El acceso por API aparece como próximamente.
Veo 3.1: hasta 3 imágenes de referencia de una persona, personaje o producto, según la documentación de Google. Los clips de referencia duran 8 segundos, en 16:9 o 9:16. Google lo llama Ingredients to Video. Veo 3.1 Lite no admite referencias.
Seedance 2.5 y MiniMax H3: ambos aceptan varias imágenes de referencia, y algunos proveedores admiten también referencias de vídeo y audio. Los topes publicados varían mucho según el proveedor, de unas 9 a 30 imágenes en Seedance 2.5 y de 5 a 9 en MiniMax H3, así que consulta los límites exactos del proveedor que uses.
Más referencias no siempre es mejor
Un tope más alto ayuda cuando una toma tiene varios sujetos. Para un solo personaje, los beneficios caen rápido. Cada imagen extra es otra oportunidad para que aparezca un atuendo distinto, otra luz o un fondo que no toca.
Una regla práctica: entre tres y cinco imágenes por sujeto, elegidas para cubrir distintos ángulos, y solo tantos sujetos por toma como necesite la escena.
Cómo elegir un modelo para un proyecto
Un personaje recurrente, clips cortos para redes: Kling 3.0 Omni es hoy la opción más práctica. Tiene API pública, clips de hasta 15 segundos y elementos pensados para sujetos recurrentes.
Un personaje, un producto y un lugar en una misma toma: un modelo con tope más alto y varios sujetos por petición, como Seedance 2.5 en un proveedor con límites generosos, o Kling 4.0 cuando abra su API.
Anuncios que deben empezar con una composición exacta: un modelo que permita un fotograma inicial junto a las referencias. Los endpoints Omni de Kling en fal.ai exponen campos de imagen inicial y final junto a los elementos.
Solo tres buenas imágenes: Veo 3.1 está diseñado justo para tres.
Qué buscar en un generador multirreferencia
Sujetos reutilizables. Debes subir las referencias de un personaje una sola vez y elegirlo después, sin volver a adjuntar archivos en cada prompt.
Reglas claras sobre la función de cada imagen. La herramienta debería indicar qué imagen se usa como vista principal y cuántas imágenes envía realmente al modelo.
Historial por sujeto. Todos los clips de un personaje juntos, para detectar la deriva.
Etiquetas de modelo honestas. Una herramienta debe indicar qué modelo y qué versión generó cada clip.
Precios claros. Debes conocer el coste de un clip antes de pulsar Generar.
Dónde encaja RefVid
RefVid es un generador multirreferencia construido en torno a personajes y productos guardados. Cada activo guarda de 1 a 5 imágenes de referencia, siendo la primera la vista principal, y cada vídeo usa un activo. Hoy la generación funciona con Kling 3.0 Omni, el coste aparece en el botón antes de empezar y cada clip se lista en la página del activo. RefVid pasará a Kling 4.0 cuando abra su API.
Preguntas frecuentes
- ¿Qué modelo de vídeo con IA acepta más imágenes de referencia?
- A octubre de 2026, algunos proveedores de API anuncian hasta 30 imágenes para Seedance 2.5. Kling 4.0 admite hasta 10 imágenes dentro de 15 referencias, pero su API todavía no está abierta.
- ¿La multirreferencia es lo mismo que usar fotogramas iniciales?
- No. Los fotogramas inicial y final fijan momentos exactos del clip. Las referencias describen sujetos y no fijan ningún fotograma. Algunos modelos permiten usar ambos en una misma petición.
- ¿Necesito muchas referencias para obtener buenos resultados?
- No. Entre tres y cinco imágenes nítidas por sujeto que cubran los ángulos principales suelen bastar. Las imágenes extra que varían en atuendo o iluminación empeoran el resultado.
- ¿Cuánto cuesta cada vídeo en RefVid?
- 31 créditos por segundo: 93 para 3 segundos, 155 para 5, 310 para 10 y 465 para 15. Las primeras 50 cuentas reciben 630 créditos gratis, que equivalen a cuatro vídeos de 5 segundos. Las cuentas posteriores reciben 100, un clip de 3 segundos.
- ¿Con qué generador de vídeo multirreferencia con IA debería empezar?
- Con uno que tenga API pública hoy, como Kling 3.0 Omni, Veo 3.1 o Seedance 2.5. La tabla de arriba compara sus límites.
- ¿Un generador de vídeo con referencias con IA es lo mismo que image-to-video?
- No. El image-to-video anima una imagen como primer fotograma; un generador de referencias crea una escena nueva que conserva los sujetos de varias imágenes.