Veo 3.1とSeedance 2.5:参照は少なめか多めか
Veo 3.1とSeedance 2.5は、いずれも今すぐAPI経由で呼び出せ、参照画像から音声付きの動画を生成できます。ただしアプローチは正反対です。Veo 3.1は参照画像を3枚まで受け付け、8秒の参照クリップを作ります。Seedance 2.5は画像を最大30枚、さらに動画と音声も受け付け、最長30秒のクリップを作ります。どちらが適しているかは、動きを揃えたい被写体の数、ショットの長さ、そしてその被写体が実在の人物かどうかによって決まります。
2026年10月時点のステータス
Veo 3.1はGoogleの動画モデルです。Gemini APIでは、Googleのdeprecations一覧に記載されたとおり、Veo 3.1プレビューのモデルIDが2026年10月22日(Googleが示す最も早い日付)に提供終了の日を迎えました。同じ一覧では、後継としてGemini Omni Flash(gemini-omni-1.1-flash)が挙げられています。
Veo 3.1はfal.aiなどのプロバイダーからも提供されています。fal.aiのVeo 3.1 reference-to-videoページによれば、このエンドポイントは2026年11月17日に非推奨となるため、開発に組み込む前にプロバイダーを確認してください。
Seedance 2.5はByteDanceのモデルです。2026年8月18日付のfal.aiのSeedance 2.5ガイドによると、fal.aiのAPIでtext-to-video、image-to-video、reference-to-videoの各エンドポイントが利用できます。
参照の入力
2026年10月時点のGoogleのVeoドキュメントによれば、Veo 3.1は参照画像を最大3枚受け付けます。参照機能はVeo 3.1とVeo 3.1 Fastで使えますが、Veo 3.1 Liteでは利用できないと記載されています。3つの枠しかないので、最も情報量の多い角度を選びましょう。通常は正面、3/4、特徴的なディテールのクローズアップ1枚です。
2026年10月時点のfal.aiのガイドによると、fal.ai上のSeedance 2.5は画像を最大30枚、参照動画を10本、音声を10本、合計50ファイルまで受け付けます。動画と音声は各1.8〜30.2秒で、各リストの合計は30.2秒が上限です。
Seedanceのプロンプトでは、各ファイルは@Image1、@Video1、@Audio1のように名前で指定します。どの画像がキャラクター、どれが商品、どれが背景かを明示できます。商品が回転する参照動画や、キャラクターの歩く姿の参照動画は、静止画では得られない動きの情報をモデルに与えます。
実際の違いはこうです。Veo 3.1の3枠は、1ショットにつき被写体1つ向きです。Seedance 2.5なら、同じリクエストにキャラクター、商品、背景を収められます。
参照写真4枚
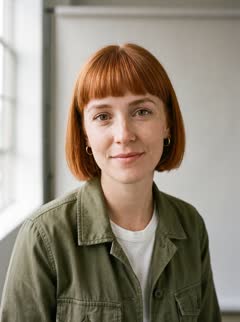
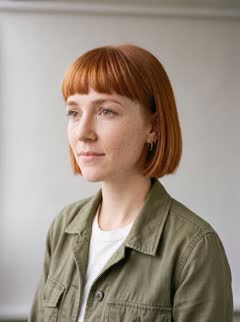
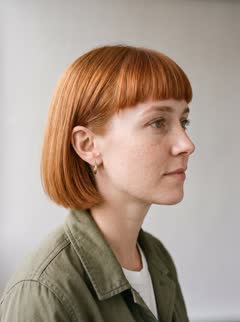
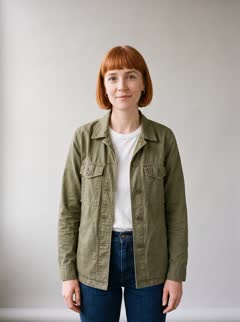
長さ、解像度、音声
2026年10月時点のGoogleのVeoドキュメントによれば、Veo 3.1は4秒、6秒、8秒の動画を生成しますが、参照画像を使う場合は8秒に限られます。出力はデフォルトで720p、8秒の場合に1080pと4Kを選べ、アスペクト比は16:9か9:16です。音声は必ず生成されます。720pに限り、7秒刻みで延長し、合計148秒まで伸ばせます。
2026年10月時点のfal.aiのガイドによれば、Seedance 2.5は1回の生成で4〜30秒、またはモデルが選んだ長さの動画を作ります。出力は480pと720p、アスペクト比は21:9、16:9、4:3、1:1、3:4、9:16、autoの7種類です。音声は映像と同時に生成され、ダブルクォートで囲んだセリフは口の動きに同期して返されます。編集と延長も同じ参照エンドポイントで行えます。
1080pや4Kが必要なら、Veo 3.1が適しています。カットなしで15〜30秒が必要なら、Seedance 2.5が向いています。
16:9
9:16と1:1
顔とコンテンツの規則
Seedance 2.5の参照で実在の顔を扱う場合のByteDance自身のポリシーは見つけられなかったため、この点については断定しません。Seedance 2.0については、プロバイダーのドキュメントに明記されています。2026年10月時点のVenice AIのドキュメントでは、検出可能な人の顔があると同意確認のステップが発生し、識別可能な著名人は同意があっても拒否されると説明されています。
GoogleのVeoドキュメントでは、参照画像はスタイルと内容の参照として扱われ、Googleの安全フィルターの対象になると説明されています。被写体が実在のプレゼンターやクリエイターなら、どちらかに決める前に、両方のモデルで自分の参照画像を試してください。
クリップ1本あたりの料金
2026年10月時点で、fal.aiのVeo 3.1 reference-to-videoは、720pまたは1080pで音声付きなら1秒あたり$0.40、音声なしなら$0.20です。4Kでは音声付きが$0.60、音声なしが$0.40になります。8秒の1080p音声付きクリップは$3.20です。
2026年10月時点で、fal.aiのSeedance 2.5は出力トークン数で課金されます。fal.aiのガイドによると、料金は480pで1秒あたり約$0.22、720pで約$0.47です。音声の有無は関係ありません。8秒の720pクリップは約$3.80、30秒の720pクリップは約$14です。画像と音声の参照には課金されませんが、参照動画には課金されます。
一貫したキャラクターや商品にはどちらを選ぶか
被写体が1つのショット、8秒単位の場面、1080pや4Kでの納品にはVeo 3.1を選びましょう。商品の主役カット、プレゼンターの紹介、短い広告カットに向いています。解像度が重要ならVeo 3.1がより有力です。
固定された要素が複数ある場面、動きの参照、最長30秒の長回しにはSeedance 2.5を選びましょう。被写体が顔の規則を満たし、720pで十分なら、入力と長さの面でより柔軟なモデルです。
同じ参照を両方のモデルに通したわけではないため、これは公開された機能と規則の比較であり、実測した再現度ではありません。
RefVidはどちらのモデルも使っていません。RefVidはKling 3.0 Omniを使い、被写体1人あたり参照写真1〜5枚、1ショットに最大3人、3〜15秒のクリップに対応しています。APIが開放されたらKling 4 Omni Referenceに切り替える予定です。
よくある質問
- VeoとSeedance、参照画像をより多く受け付けるのはどちら?
- Seedance 2.5が圧倒的に多く、fal.aiでは画像最大30枚に加え、動画10本と音声10本まで受け付けます。Veo 3.1は2026年10月時点のGoogleのドキュメントによれば、画像は最大3枚です。
- Veo 3.1とSeedance 2.5、長い動画を作れるのはどちら?
- Seedance 2.5は1回の生成で4〜30秒を作れます。Veo 3.1は参照画像を使うクリップが8秒で、720pなら7秒刻みで延長できます。
- Veo 3.1とSeedance 2.5、解像度が高いのはどちら?
- Veo 3.1です。8秒の場合に1080pと4Kを選べます。2026年10月時点で、fal.aiはSeedance 2.5を480pと720pとして提供しています。
- Gemini APIでVeo 3.1のプレビューはまだ使えますか?
- いいえ。Googleのドキュメントによると、Veo 3.1プレビューのモデルIDは、Googleのdeprecations一覧で示された最も早い日付である2026年10月22日に提供終了の日を迎えました。後継としてGemini Omni Flash(gemini-omni-1.1-flash)が挙げられています。