Veo 3.1 vs Seedance 2.5: poucas referências ou muitas
Hoje dá para acessar o Veo 3.1 e o Seedance 2.5 por API, e os dois geram vídeo com áudio a partir de imagens de referência. Mas a abordagem é oposta. O Veo 3.1 aceita três imagens de referência e gera clipes de referência de 8 segundos. O Seedance 2.5 aceita até 30 imagens, além de vídeo e áudio, e gera clipes de até 30 segundos. A escolha certa depende de quantos sujeitos você precisa manter estáveis, da duração dos seus planos e de esses sujeitos serem pessoas reais.
Status em outubro de 2026
O Veo 3.1 é o modelo de vídeo do Google. Na Gemini API, os IDs de modelo de prévia do Veo 3.1 chegaram à data de desativação listada, 22 de outubro de 2026, segundo a tabela de descontinuações da Gemini API do Google (o Google informa que essa é a data mais cedo possível). A mesma tabela indica o Gemini Omni Flash (gemini-omni-1.1-flash) como substituto.
O Veo 3.1 também é oferecido por provedores como a fal.ai. A página de referência-para-vídeo do Veo 3.1 na fal.ai informa que esse endpoint será descontinuado em 17 de novembro de 2026, então confira seu provedor antes de construir algo sobre ele.
O Seedance 2.5 é um modelo da ByteDance. Segundo o guia do Seedance 2.5 na fal.ai, datado de 18 de agosto de 2026, ele está disponível na API da fal.ai com endpoints de texto-para-vídeo, imagem-para-vídeo e referência-para-vídeo.
Entradas de referência
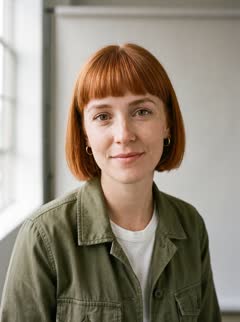
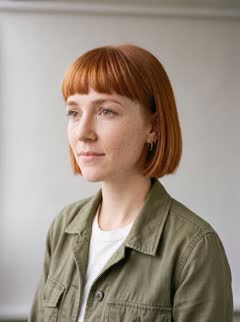
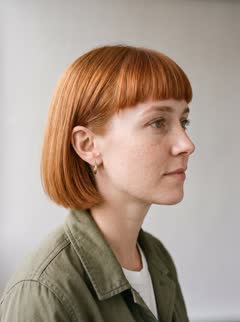
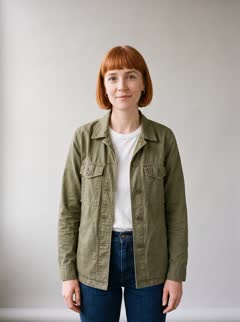
O Veo 3.1 aceita até três imagens de referência, segundo a documentação do Veo do Google em outubro de 2026. As referências funcionam no Veo 3.1 e no Veo 3.1 Fast; a documentação indica que não estão disponíveis no Veo 3.1 Lite. Com três vagas, escolha as vistas mais informativas: normalmente frente, três quartos e um close do detalhe que identifica o sujeito.
O Seedance 2.5 na fal.ai aceita até 30 imagens, 10 vídeos de referência e 10 clipes de áudio, somando 50 arquivos, segundo o guia da fal.ai de outubro de 2026. Cada arquivo de vídeo ou áudio dura de 1,8 a 30,2 segundos, e cada lista tem limite de 30,2 segundos somados.
No prompt do Seedance, cada arquivo recebe o nome @Image1, @Video1 ou @Audio1, o que permite dizer qual imagem é o personagem, qual é o produto e qual é o cenário. Um vídeo de referência de um produto girando, ou do andar de um personagem, dá ao modelo informações de movimento que imagens estáticas não dão.
Na prática: as três vagas do Veo 3.1 servem bem a um sujeito por plano. O Seedance 2.5 tem espaço para um personagem, um produto e um cenário no mesmo pedido.
4 fotos de referência
Duração, resolução e áudio
O Veo 3.1 gera 4, 6 ou 8 segundos, mas clipes com imagens de referência precisam ter 8 segundos, segundo a documentação do Veo do Google em outubro de 2026. A saída é 720p por padrão, com 1080p e 4K em 8 segundos, em 16:9 ou 9:16. O áudio é sempre gerado. Um clipe pode ser estendido em passos de 7 segundos até 148 segundos no total, em 720p.
O Seedance 2.5 gera de 4 a 30 segundos em uma única passada, ou uma duração escolhida pelo modelo, segundo o guia da fal.ai de outubro de 2026. A fal.ai lista saídas em 480p e 720p e sete proporções: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 e auto. O áudio é gerado junto com a imagem, e diálogos escritos entre aspas duplas voltam sincronizados. Edição e extensão passam pelo mesmo endpoint de referência.
Se você precisa de 1080p ou 4K, o Veo 3.1 é a opção. Se precisa de 15 a 30 segundos sem corte, é o Seedance 2.5.
16:9
9:16 e 1:1
Rostos e regras de conteúdo
Não encontramos a política própria da ByteDance sobre rostos reais nas referências do Seedance 2.5, então não fazemos nenhuma afirmação sobre isso. Para o Seedance 2.0, a documentação dos provedores é explícita. A documentação da Venice AI, de outubro de 2026, diz que um rosto humano detectável aciona uma etapa de consentimento, e uma figura pública reconhecível é recusada mesmo com consentimento.
A documentação do Veo do Google descreve as imagens de referência como referências de estilo e de conteúdo, sujeitas aos filtros de segurança do Google. Se o seu sujeito for um apresentador ou criador real, teste os dois modelos com suas referências antes de se comprometer com qualquer um.
Preço por clipe
Na fal.ai, o Veo 3.1 referência-para-vídeo custa US$ 0,40 por segundo com áudio em 720p ou 1080p, e US$ 0,20 sem áudio, em outubro de 2026. Em 4K, são US$ 0,60 com áudio ou US$ 0,40 sem. Um clipe de 8 segundos em 1080p com áudio sai por US$ 3,20.
O Seedance 2.5 na fal.ai é cobrado por tokens de saída, que o guia da fal.ai coloca em cerca de US$ 0,22 por segundo em 480p e US$ 0,47 por segundo em 720p em outubro de 2026, com áudio ligado ou desligado. Um clipe de 8 segundos em 720p custa cerca de US$ 3,80, e um de 30 segundos em 720p, cerca de US$ 14. Imagens e áudios de referência não são cobrados; vídeos de referência são.
Qual escolher para personagens e produtos consistentes
Escolha o Veo 3.1 para planos com um único sujeito, cenas de 8 segundos e entrega em 1080p ou 4K. Planos de destaque de produto, apresentações de apresentadores e cortes curtos de anúncio combinam bem com ele. O Veo 3.1 é a escolha mais forte quando a resolução importa.
Escolha o Seedance 2.5 para cenas com vários elementos fixos, para referências de movimento e para takes longos e contínuos de até 30 segundos. É o modelo mais flexível em entradas e duração, desde que seu sujeito passe nas regras de rosto e 720p seja suficiente.
Não rodamos as mesmas referências nos dois, então esta é uma comparação de capacidades e regras publicadas, não de fidelidade medida.
O RefVid não usa nenhum dos dois modelos. Ele roda o Kling 3.0 Omni, com de 1 a 5 fotos de referência por sujeito, até 3 sujeitos em um plano e clipes de 3 a 15 segundos, e vai migrar para o Kling 4 Omni Reference quando a API dele estiver aberta.
Perguntas frequentes
- Veo vs Seedance: qual aceita mais imagens de referência?
- O Seedance 2.5, com ampla vantagem: até 30 imagens, além de 10 vídeos e 10 clipes de áudio na fal.ai. O Veo 3.1 aceita até três imagens, segundo a documentação do Google em outubro de 2026.
- Qual gera clipes mais longos, o Veo 3.1 ou o Seedance 2.5?
- O Seedance 2.5 gera de 4 a 30 segundos em uma única passada. Clipes do Veo 3.1 com imagens de referência têm 8 segundos e podem ser estendidos em passos de 7 segundos, em 720p.
- Qual tem resolução mais alta, o Veo 3.1 ou o Seedance 2.5?
- O Veo 3.1, com 1080p e 4K em 8 segundos. Em outubro de 2026, a fal.ai lista o Seedance 2.5 em 480p e 720p.
- Ainda consigo usar a prévia do Veo 3.1 na Gemini API?
- Não. A documentação do Google diz que os IDs de modelo de prévia do Veo 3.1 chegaram à data de desativação listada, 22 de outubro de 2026 (a data mais cedo possível na tabela de descontinuações do Google). O Google indica o Gemini Omni Flash (gemini-omni-1.1-flash) como substituto.