Video IA con personaje consistente: la misma cara en cada clip
Generas un primer clip buenísimo. El segundo tiene otra nariz. En el quinto, es otra persona. La deriva del personaje es el motivo más común por el que el vídeo IA sigue siendo un juguete y no una herramienta de producción. Esta guía explica por qué ocurre, qué técnicas lo solucionan de verdad y cómo montar un flujo de trabajo en el que la consistencia sea lo normal y no cuestión de suerte.
Sube las fotos de tu personaje4 fotos de referencia
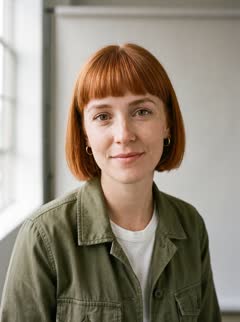
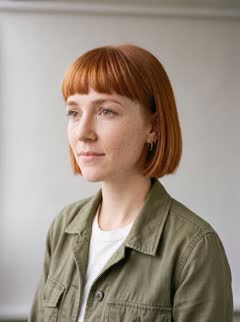
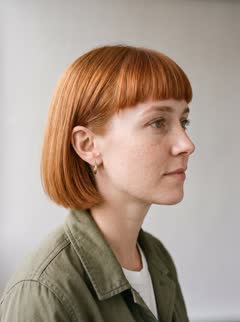
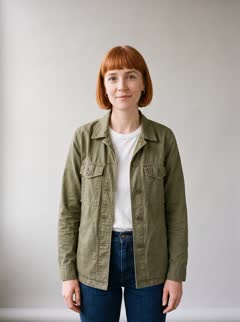
Cada clip, la misma cara
Por qué se desvían los personajes
Un modelo de vídeo no recuerda a tu personaje entre peticiones. Cada generación parte de lo que le das: un prompt y, quizá, una imagen inicial. Un prompt como "una mujer con pelo corto pelirrojo y abrigo verde" describe millones de personas posibles, así que cada clip elige una distinta. Una sola imagen de partida funciona mejor, pero el modelo solo tiene que igualarla en el primer fotograma; cuando la cámara se mueve, rellena lo que la imagen no mostraba, y esas suposiciones cambian en cada intento.
La deriva empeora al cambiar el ángulo de cámara, la iluminación o al alargar los clips, justo lo que hace que una secuencia parezca metraje real.
Solo prompt: la misma descripción de ella en palabras
Cuatro fotos de referencia
Técnica 1: describe menos, muestra más
Las descripciones largas y detalladas del personaje parecen ayudar, pero en realidad sobre todo desplazan la aleatoriedad. Lo que sirve es la información visual. Cada ángulo extra del rostro y cada primer plano de un rasgo distintivo elimina una decisión que el modelo tomaría por su cuenta.
Técnica 2: generación con varias referencias
Los modelos con soporte de referencias —la línea Omni de Kling, el modo referencia a vídeo de Veo 3.1, el modo multirreferencia de Seedance— reciben varias imágenes del sujeto junto con el prompt y las tratan como la descripción de quién debe aparecer. Es la mejora más grande disponible hoy. Los resultados dependen mucho de las referencias: de tres a diez imágenes nítidas, con luz uniforme y que cubran vista frontal, tres cuartos y perfil, superan a un único retrato perfecto.
Cada modelo tiene sus límites y puntos fuertes. Kling 3.0 Omni acepta hasta siete imágenes de referencia, o un clip corto de referencia más hasta cuatro imágenes; el modo de referencia de Veo 3.1 admite hasta tres. Un flujo de trabajo atado a un solo modelo también queda atado a sus límites.
Técnica 3: mantén fijo el conjunto de referencias
El asesino silencioso de la consistencia es cambiar las entradas. Si el clip uno usó cinco fotos y el clip cuatro usó tres distintas, tienes dos personajes ligeramente diferentes. Trata las referencias de un personaje como a un miembro del reparto: decídelas una vez, guárdalas y reutiliza exactamente el mismo conjunto en cada escena. Cambia el vestuario solo creando a propósito una nueva versión del personaje.
Un flujo de trabajo que aguanta
1. Toma o selecciona las referencias: frontal, tres cuartos izquierda y derecha, perfil y un primer plano de cualquier rasgo distintivo (gafas, una cicatriz, un logo en la ropa). Fondo liso, luz suave, sin filtros.
2. Guárdalas como un único personaje con nombre. A partir de ahí, nada del personaje vive en el prompt: el prompt describe la escena, la acción y la cámara.
3. Escribe prompts de escena cortos y concretos: dónde está, qué hace el personaje, cómo se mueve la cámara. "Camina por una calle lluviosa de Tokio de noche, la cámara la sigue por detrás y luego ella se gira hacia el objetivo."
4. Revisa los clips uno al lado del otro. Si uno se desvía, vuelve a generarlo en lugar de intentar arreglarlo cambiando el prompt; la deriva suele ser aleatoria, no sistemática.
5. Conserva cada clip junto a su personaje, para que la siguiente escena parta del mismo punto.
Los productos tienen el mismo problema
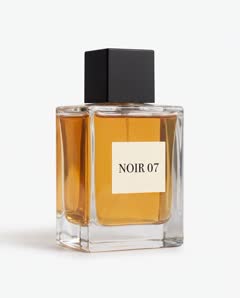
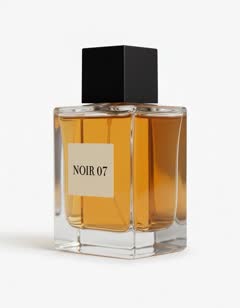
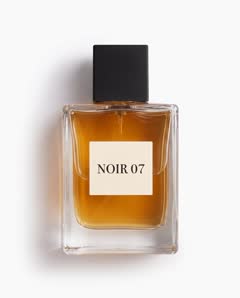
Todo lo anterior se aplica a productos, mascotas y objetos. Un frasco cuya etiqueta cambia entre planos no sirve en un anuncio. Las referencias de producto deben incluir el ángulo principal, la parte trasera y un primer plano nítido del logo. El texto impreso pequeño sigue siendo el punto más débil de todos los modelos actuales, así que planifica planos en los que la letra fina no sea el foco.
3 fotos de referencia
Dónde encaja RefVid
RefVid está construido alrededor de ese flujo de trabajo. Creas un Personaje o un Producto una vez y subes sus referencias; cada generación reutiliza exactamente ese conjunto, empaquetado como lo espera el modelo elegido. Todos los clips de un activo viven juntos en una vista de serie, así que la deriva se detecta con facilidad. Los modelos cambian por debajo —hoy Kling 3.0 Omni, mañana Kling 4— sin que tengas que rehacer tu reparto.
Empieza con una plantilla
Cada una abre el estudio con las tomas, el formato y la duración ya listos. Añade tu propio producto y genera.
Preguntas frecuentes
- ¿Puede un prompt por sí solo mantener un personaje consistente?
- No de forma fiable. Una descripción en texto encaja con muchas personas posibles, así que cada clip elige una distinta. Son las imágenes de referencia las que mantienen un rostro consistente.
- ¿Cuántas imágenes de referencia necesito para un personaje consistente?
- De tres a diez imágenes nítidas que cubran vista frontal, tres cuartos y perfil, con luz uniforme y fondo liso. Mantén el conjunto fijo en cada clip.
- ¿Funciona igual con productos que con personas?
- Sí. Usa el ángulo principal, la parte trasera o lateral y un primer plano del logo. El texto impreso pequeño sigue siendo el punto más débil de los modelos actuales.
- ¿Qué diferencia a un generador de vídeo de personaje consistente?
- Toma varias imágenes de referencia de la misma persona y las conserva para cada clip, en lugar de partir de una descripción en texto cada vez. Esa es la técnica multirreferencia descrita arriba.