Vídeo de IA com personagem consistente: o mesmo rosto em todos os clipes
Você gera um primeiro clipe ótimo. O segundo tem um nariz diferente. No quinto, já é outra pessoa. A deriva do personagem é o motivo mais comum para a IA de vídeo continuar sendo brinquedo e não uma ferramenta de produção. Este guia explica por que isso acontece, quais técnicas realmente resolvem o problema e como montar um fluxo de trabalho em que a consistência seja o padrão, e não sorte.
Envie as fotos do seu personagem4 fotos de referência
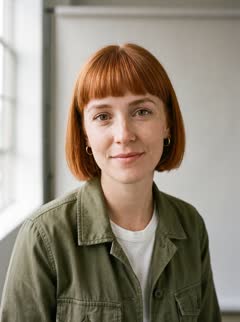
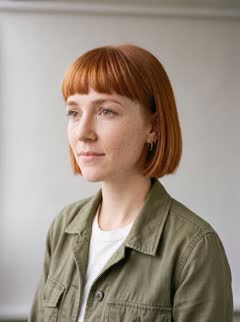
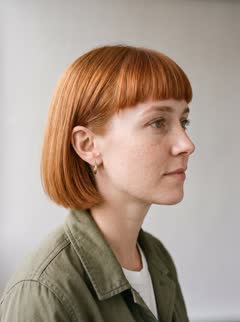
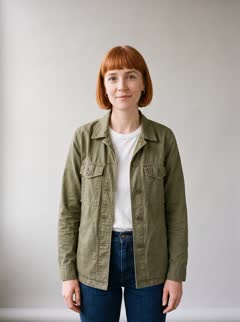
Todos os clipes, o mesmo rosto
Por que os personagens derivam
Um modelo de vídeo não guarda a memória do seu personagem entre um pedido e outro. Cada geração parte do que você entrega: um prompt e, talvez, uma imagem inicial. Um prompt como "uma mulher de cabelo curto ruivo e casaco verde" descreve milhões de pessoas possíveis, então cada clipe escolhe uma diferente. Uma única imagem inicial ajuda mais, mas o modelo só precisa respeitá-la no primeiro quadro; conforme a câmera se move, ele inventa o que a imagem não mostrava, e essas invenções mudam a cada vez.
A deriva piora com mudanças de ângulo, de iluminação e com clipes mais longos — justamente o que faz uma sequência parecer uma filmagem real.
Só prompt: a descrição dela em palavras
Quatro fotos de referência
Técnica 1: descreva menos, mostre mais
Descrições longas e detalhadas parecem ajudar, mas na prática apenas redistribuem a aleatoriedade. O que funciona é informação visual. Cada ângulo extra do rosto e cada close de um traço marcante remove uma decisão que o modelo tomaria sozinho.
Técnica 2: geração com múltiplas referências
Os modelos com suporte a referências — a linha Omni da Kling, o modo reference-to-video do Veo 3.1, o modo multirreferência do Seedance — recebem várias imagens do sujeito junto com o prompt e as tratam como a descrição de quem precisa aparecer. Essa é hoje a maior melhoria disponível. O resultado depende muito das referências: de três a dez imagens nítidas, com luz uniforme, cobrindo vista frontal, três quartos e perfil, superam um único retrato perfeito.
Cada modelo tem seus limites e pontos fortes. O Kling 3.0 Omni aceita até sete imagens de referência, ou um clipe curto de referência mais até quatro imagens; o modo de referência do Veo 3.1 aceita até três imagens. Um fluxo de trabalho preso a um único modelo também fica preso aos limites dele.
Técnica 3: mantenha o conjunto de referências fixo
O grande vilão da consistência é trocar as entradas. Se o primeiro clipe usou cinco fotos e o quarto usou outras três diferentes, você terá dois personagens levemente distintos. Trate as referências de um personagem como um membro do elenco: defina uma vez, guarde e reutilize exatamente o mesmo conjunto em todas as cenas. Mude a roupa apenas criando de propósito uma nova versão do personagem.
Um fluxo de trabalho que se sustenta
1. Fotografe ou selecione as referências: frente, três quartos esquerdo e direito, perfil, um close de qualquer detalhe marcante (óculos, cicatriz, logo na roupa). Fundo liso, luz suave, sem filtros.
2. Salve-as como um único personagem com nome. A partir daí, nada sobre o personagem fica no prompt — o prompt descreve a cena, a ação e a câmera.
3. Escreva prompts de cena curtos e concretos: onde, o que o personagem faz, como a câmera se move. "Ela entra numa rua chuvosa de Tóquio à noite, a câmera segue por trás e, depois, ela se vira para a lente."
4. Revise os clipes lado a lado. Se um deles derivar, gere de novo em vez de tentar corrigir com ajustes no texto do prompt; a deriva costuma ser aleatória, não sistemática.
5. Guarde cada clipe junto do seu personagem, para que a próxima cena comece do mesmo ponto.
Produtos têm o mesmo problema
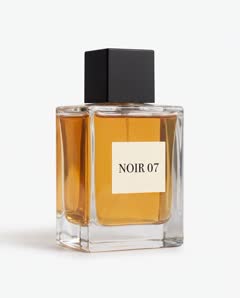
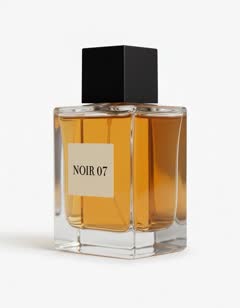
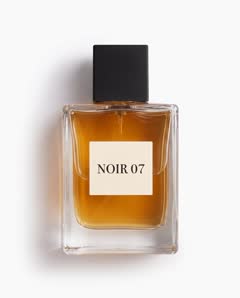
Tudo o que foi dito vale para produtos, mascotes e objetos de cena. Um frasco cujo rótulo muda entre os planos é inutilizável num anúncio. As referências do produto devem incluir o ângulo principal, a parte de trás e um close nítido da logo. Textos pequenos impressos continuam sendo o ponto mais fraco de todos os modelos atuais, então planeje planos em que a letra miúda não seja o foco.
3 fotos de referência
Onde o RefVid entra
O RefVid foi construído em torno desse fluxo. Você cria um Personagem ou Produto uma vez e envia suas referências; cada geração reutiliza exatamente esse conjunto, preparado do jeito que o modelo escolhido espera. Todos os clipes de um ativo ficam juntos numa visão de série, o que facilita identificar a deriva. Os modelos mudam por baixo — hoje o Kling 3.0 Omni, depois o Kling 4 — sem que você precise refazer seu elenco.
Comece com um modelo
Cada um abre o estúdio com as cenas, o formato e a duração já definidos. Adicione seu próprio produto e gere.
Perguntas frequentes
- Só um prompt consegue manter um personagem consistente?
- Não de forma confiável. Uma descrição em texto corresponde a muitas pessoas possíveis, então cada clipe escolhe uma diferente. São as imagens de referência que mantêm o rosto consistente.
- Quantas imagens de referência preciso para um personagem consistente?
- De três a dez imagens nítidas, cobrindo vista frontal, três quartos e perfil, com luz uniforme e fundo liso. Mantenha o conjunto fixo em todos os clipes.
- Isso funciona para produtos também, além de pessoas?
- Sim. Use o ângulo principal, a parte de trás ou lateral e um close da logo. Textos pequenos impressos continuam sendo o ponto mais fraco dos modelos atuais.
- O que diferencia um gerador de vídeo de personagem consistente?
- Ele recebe várias imagens de referência da mesma pessoa e as mantém em todos os clipes, em vez de partir de uma descrição em texto a cada vez. É a técnica de múltiplas referências descrita acima.