Vidéo IA à personnage constant : le même visage dans chaque plan
Votre premier plan est réussi. Le deuxième a un autre nez. Au cinquième, c'est une autre personne. La dérive du personnage est la raison la plus fréquente pour laquelle la vidéo IA reste un jouet plutôt qu'un outil de production. Ce guide explique pourquoi elle se produit, quelles techniques la corrigent vraiment, et comment mettre en place un flux de travail où la cohérence devient la norme, et non une question de chance.
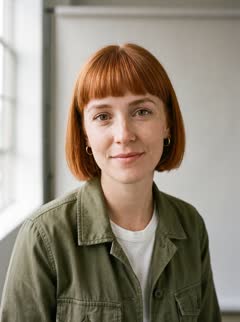
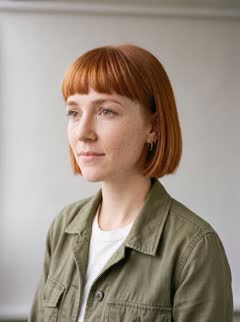
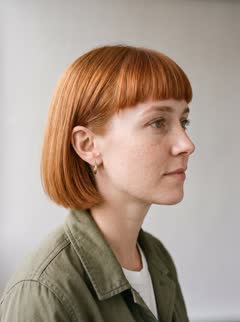
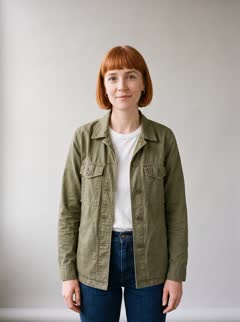
Importez vos photos de personnage4 photos de référence
Chaque plan, le même visage
Pourquoi les personnages dérivent
Un modèle vidéo ne se souvient pas de votre personnage d'une requête à l'autre. Chaque génération part de ce que vous lui fournissez : un prompt, éventuellement une image de départ. Un prompt du type « une femme aux cheveux courts roux et au manteau vert » décrit des millions de personnes possibles, donc chaque plan en choisit une différente. Une seule image de départ est préférable, mais le modèle ne doit la respecter que sur la première image ; quand la caméra bouge, il invente ce que l'image ne montrait pas, et ces inventions changent à chaque fois.
La dérive s'aggrave avec les changements d'angle de caméra, de lumière et la durée des plans, précisément ce qui rend une séquence crédible comme de vraies images.
Prompt seul : la même description d'elle, en mots
Quatre photos de référence
Technique 1 : décrire moins, montrer plus
Les descriptions longues et détaillées du personnage semblent utiles, mais elles déplacent surtout l'aléatoire. Ce qui aide, ce sont les informations visuelles. Chaque angle supplémentaire du visage, chaque gros plan sur un trait distinctif retire une décision que le modèle prendrait sinon seul.
Technique 2 : génération multi-référence
Les modèles capables de références — la gamme Omni de Kling, le mode reference-to-video de Veo 3.1, le mode multi-référence de Seedance — prennent plusieurs images du sujet avec le prompt et les traitent comme la description de la personne qui doit apparaître. C'est aujourd'hui l'amélioration la plus importante disponible. Les résultats dépendent beaucoup des références : trois à dix images nettes, à lumière homogène, couvrant face, trois quarts et profil, valent mieux qu'un seul portrait parfait.
Chaque modèle a ses limites et ses forces. Kling 3.0 Omni accepte jusqu'à sept images de référence, ou un court clip de référence plus quatre images au maximum ; le mode de référence de Veo 3.1 accepte jusqu'à trois images. Un flux de travail lié à un seul modèle vous enferme aussi dans ses limites.
Technique 3 : garder le même jeu de références
Le tueur silencieux de la cohérence, c'est de changer les entrées. Si le premier plan utilise cinq photos et le quatrième trois autres, vous obtenez deux personnages légèrement différents. Traitez les références d'un personnage comme un membre de la distribution : décidez-les une fois, enregistrez-les, et réutilisez exactement le même jeu pour chaque scène. Ne changez la tenue qu'en créant délibérément une nouvelle version du personnage.
Un flux de travail qui tient
1. Prenez ou sélectionnez les références : face, trois quarts gauche et droit, profil, un gros plan sur tout élément distinctif (lunettes, cicatrice, logo sur un vêtement). Fond uni, lumière douce, sans filtre.
2. Enregistrez-les sous un même personnage nommé. Dès lors, rien concernant le personnage ne figure dans le prompt : le prompt décrit la scène, l'action et la caméra.
3. Rédigez des prompts de scène courts et concrets : où, ce que fait le personnage, comment bouge la caméra. « Elle entre dans une rue de Tokyo sous la pluie, la nuit ; la caméra la suit par-derrière, puis elle se retourne vers l'objectif. »
4. Comparez les plans côte à côte. Si l'un dérive, régénérez-le plutôt que de chercher à le corriger en retouchant le prompt ; la dérive est généralement aléatoire et non systématique.
5. Conservez chaque plan avec son personnage, pour que la scène suivante parte du même point.
Les produits ont le même problème
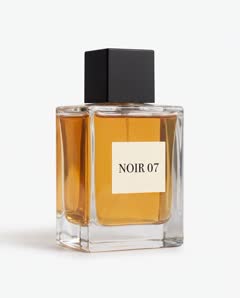
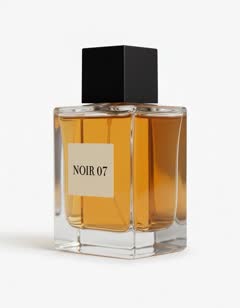
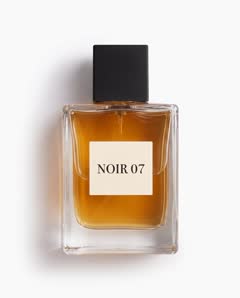
Tout ce qui précède vaut pour les produits, mascottes et accessoires. Un flacon dont l'étiquette change d'un plan à l'autre est inutilisable dans une publicité. Les références produit doivent inclure l'angle principal, le dos et un gros plan net du logo. Le petit texte imprimé reste le point faible de tous les modèles actuels : prévoyez des plans où les mentions en petits caractères ne sont pas au centre de l'image.
3 photos de référence
La place de RefVid
RefVid est conçu autour de ce flux de travail. Vous créez un Personnage ou un Produit une seule fois et importez ses références ; chaque génération réutilise exactement ce jeu, préparé selon le format attendu par le modèle choisi. Tous les plans d'un même élément sont regroupés dans une vue de série, ce qui rend la dérive facile à repérer. Les modèles évoluent en coulisses — aujourd'hui Kling 3.0 Omni, demain Kling 4 — sans que vous ayez à reconstruire votre distribution.
Partir d’un modèle
Chaque modèle ouvre le studio avec les plans, le format et la durée déjà réglés. Ajoutez votre produit et lancez la génération.
Questions fréquentes
- Un prompt seul peut-il garder un personnage constant ?
- Pas de façon fiable. Une description textuelle correspond à de nombreuses personnes possibles, donc chaque plan en choisit une différente. Ce sont les images de référence qui maintiennent un visage constant.
- Combien d'images de référence faut-il pour un personnage constant ?
- Trois à dix images nettes couvrant face, trois quarts et profil, avec une lumière homogène et un fond uni. Gardez le même jeu pour chaque plan.
- Cela fonctionne-t-il aussi pour les produits ?
- Oui. Utilisez l'angle principal, le dos ou le côté, et un gros plan du logo. Le petit texte imprimé reste le point faible des modèles actuels.
- Qu'est-ce qui distingue un générateur vidéo à personnage constant ?
- Il prend plusieurs images de référence de la même personne et les conserve pour chaque plan, au lieu de repartir d'une description textuelle à chaque fois. C'est la technique multi-référence décrite ci-dessus.