Un presentador de IA consistente para explicativos y cursos
Las bibliotecas de formación y los cursos online necesitan el mismo presentador en el módulo 1 y en el módulo 40, a menudo a lo largo de un año de producción. Un presentador de IA consistente puede cubrir los planos que rodean al contenido, como las introducciones, las transiciones y las aperturas de sección, sin tener que rodar un día de estudio por cada actualización. Esta guía explica cómo crear uno, qué planos maneja bien la IA hoy, cuándo es mejor una herramienta de avatar parlante y cómo lograr que una serie larga parezca una sola producción.
Sube las fotos de tu presentadorDecide qué hace realmente el presentador
La mayoría de los vídeos explicativos y formativos son sobre todo contenido de pantalla: diapositivas, interfaces de producto, diagramas. El presentador aparece al principio, entre secciones y al final. Es una buena noticia, porque los planos cortos del presentador son justo donde el vídeo basado en referencias es más fuerte.
Divide las necesidades del presentador en dos tipos. Planos de escena: el presentador entrando en encuadre, señalando una pantalla, de pie en un taller o una oficina, reaccionando. Son planos cortos, visuales y encajan con los modelos de referencia a vídeo.
Segmentos largos con diálogo: el presentador hablando a cámara durante un guion de 60 segundos con sincronización labial precisa. Para eso, las herramientas de avatar parlante dedicadas siguen siendo más fiables.
Elegir y construir el presentador
Real o ficticio. Si el presentador se basa en un empleado o formador real, obtén un consentimiento por escrito que cubra el vídeo generado con IA, los cursos en los que aparecerá y qué pasa cuando deje la empresa. Un presentador ficticio evita esa cuestión y nunca envejece en el material.
Aspecto. Elige una apariencia que encaje con el público y que no se quede anticuada pronto: una prenda sencilla de color liso, sin estampados llamativos, que además se mantiene mejor en la generación, y un peinado que el modelo pueda conservar con facilidad.
Referencias. Usa cinco fotos: una vista frontal a la altura del pecho, una vista de tres cuartos a cada lado, un plano de medio cuerpo con las manos visibles y un plano de cuerpo entero de pie. Los planos del presentador suelen incluir gestos, por eso importan las manos. Haz o genera todas con la misma ropa y la misma luz.
Escenario. Dale al presentador un lugar fijo: una esquina de estudio, un aula, una nave para formación en seguridad. Conserva una foto del espacio y úsala como foto de escena en cada apertura, para que parezca que todo se grabó en el mismo sitio.
4 fotos de referencia
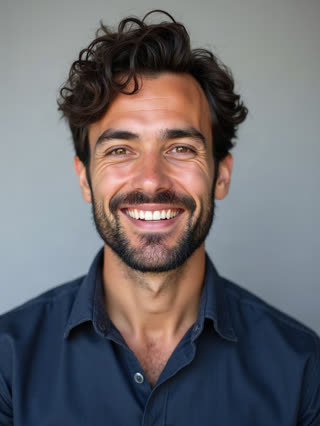
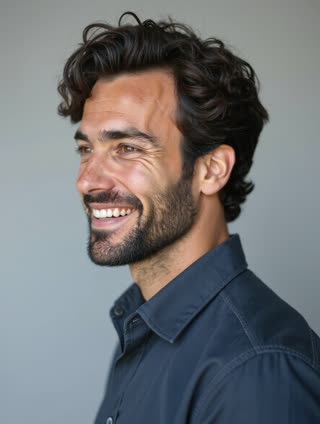
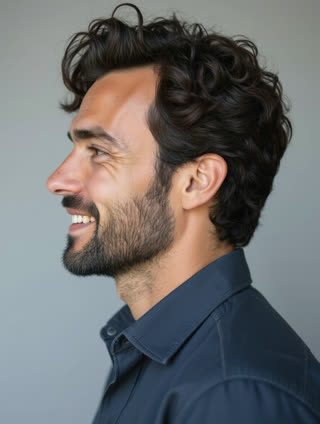
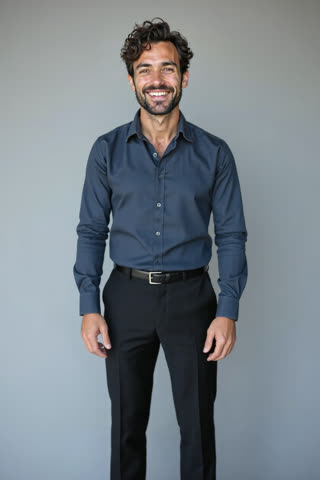
Un conjunto de planos para un curso
Genera una biblioteca reutilizable en lugar de planos nuevos para cada módulo:
1. Introducción del curso: el presentador entra en el plató y se detiene en el centro, 6 segundos.
2. Apertura de módulo, de tres a cuatro variantes: el presentador se gira hacia la cámara, asiente y gesticula hacia un espacio vacío donde aparecerá el título del módulo, 4 segundos cada una.
3. Transición: el presentador se aparta o señala fuera de cuadro para dar paso al contenido de pantalla, 3 segundos.
4. Momentos de énfasis: inclinándose hacia delante, contando con los dedos, una pausa breve con una sonrisa, 3 segundos cada uno.
5. Cierre: el presentador saluda o asiente y la cámara se aleja, 5 segundos.
Unos quince clips cubren un curso de veinte módulos. Los títulos, los subtítulos y la locución se añaden en tu editor, lo que mantiene cada módulo coherente aunque el guion cambie.
Guion y voz
Escribe pensando en los cortes. Limita las frases en cámara a una o dos oraciones y después pasa al contenido de pantalla mientras la locución sigue. El espectador acepta una voz que continúa sobre las diapositivas; en cambio, nota enseguida una boca ligeramente desincronizada en un plano largo.
Usa una sola voz para toda la serie, ya sea un narrador grabado o una voz sintética, y guarda sus ajustes junto a los archivos del curso. Para un saludo inicial breve, el modelo de vídeo puede generar la frase por sí mismo. Para algo más largo, genera el plano sin voz y añade la locución en tu editor, o usa una herramienta de sincronización labial aparte sobre el clip terminado.
Indica que el presentador es generado por IA en los créditos del curso o en la descripción. En la formación laboral, las personas que aprenden no deben quedarse con la idea de que un compañero real lo grabó.
Mantener coherente una serie larga
Congela el conjunto de referencias al empezar la producción. Crea una versión nueva si tienes que cambiar la ropa, y no mezcles versiones dentro de un mismo curso.
Fija también el encuadre: la misma altura de cámara, la misma distancia y la misma relación de aspecto en cada apertura. La coherencia del encuadre transmite coherencia de persona.
Genera las actualizaciones a partir de las referencias originales, no de clips anteriores, y revisa los planos nuevos junto a la introducción del curso antes de publicar.
Dónde encaja RefVid
RefVid guarda al presentador como personaje con 1 a 5 fotos, y se puede añadir una foto del plató como foto de escena, así que un módulo creado seis meses después parte de las mismas referencias. Cada vídeo del presentador aparece en su página dentro del estudio para revisarlo. Los clips duran de 3 a 15 segundos, en 16:9, 9:16 o 1:1, con Kling 3.0 Omni.
Con el sonido activado, el modelo genera el audio junto con la imagen, y una frase escrita entre comillas se dice tal cual; el habla en inglés y en chino suena mejor. RefVid no hace clonación de voz, sincronización labial ni edición. Las locuciones largas, los subtítulos y los segmentos con sincronización labial se hacen en tu editor o con una herramienta de avatar.
Preguntas frecuentes
- ¿Puede un presentador de IA dar una lección completa de 10 minutos?
- No de forma fiable como un único plano continuo con diálogo usando modelos de vídeo basados en referencias. Usa planos cortos del presentador entre el contenido de pantalla, o una herramienta de avatar parlante dedicada para los segmentos largos.
- ¿Puedo basar un presentador de IA en un formador real?
- Sí, con un consentimiento por escrito que cubra el vídeo con IA, los cursos implicados y qué pasa con su imagen cuando deje la empresa.
- ¿Cuántas imágenes de referencia necesita un presentador de IA?
- Cinco: una vista frontal, las dos vistas de tres cuartos, un plano de medio cuerpo con las manos visibles y un plano de cuerpo entero, todas con la misma ropa y la misma luz. RefVid admite de 1 a 5 fotos por personaje.
- ¿RefVid añade locución o sincronización labial?
- No. RefVid puede generar sonido nativo con un clip, y una frase corta entre comillas se dice tal cual, con mejores resultados en inglés y chino. La locución, los subtítulos y la sincronización labial se hacen con otras herramientas.