Um apresentador de IA consistente para vídeos explicativos e cursos
Bibliotecas de treinamento e cursos online precisam do mesmo apresentador no módulo 1 e no módulo 40, muitas vezes ao longo de um ano de produção. Um apresentador de IA consistente pode cuidar dos planos ao redor do conteúdo, como aberturas, transições e inícios de seção, sem precisar de um dia de estúdio para cada atualização. Este guia explica como configurar um, quais planos a IA faz bem hoje, quando um avatar falante é a melhor escolha e como manter uma série longa com cara de uma só produção.
Envie as fotos do seu apresentadorDefina o que o apresentador realmente faz
A maioria dos vídeos explicativos e de treinamento é, sobretudo, conteúdo de tela: slides, interface do produto, diagramas. O apresentador aparece no início, entre as seções e no final. Isso é uma boa notícia, porque planos curtos com o apresentador são exatamente onde o vídeo baseado em referência é mais forte.
Divida as necessidades do apresentador em dois tipos. Planos de cena: o apresentador entrando em quadro, apontando para uma tela, em pé numa oficina ou escritório, reagindo. São planos curtos, visuais e combinam com modelos de referência para vídeo.
Trechos falados longos: o apresentador falando um roteiro de 60 segundos olhando para a câmera, com sincronia labial precisa. Para esses, ferramentas de avatar falante dedicadas ainda são mais confiáveis.
Escolhendo e criando o apresentador
Real ou fictício. Se o apresentador for baseado em um funcionário ou instrutor real, obtenha consentimento por escrito que cubra o vídeo gerado por IA, os cursos em que aparecerá e o que acontece quando ele deixar a empresa. Um apresentador fictício evita essa questão e nunca fica datado no material.
Aparência. Escolha uma aparência adequada ao público e que não envelheça rápido: uma roupa simples, em cor sólida, sem estampas chamativas, que também se sustentam melhor na geração, e um penteado fácil de o modelo manter.
Referências. Use cinco fotos: uma vista frontal na altura do peito, uma vista de três quartos de cada lado, um plano da cintura para cima com as mãos visíveis e um plano de corpo inteiro em pé. Apresentadores costumam fazer gestos, por isso as mãos importam. Fotografe ou gere todas com a mesma roupa e a mesma luz.
Cenário. Dê ao apresentador um lugar: um canto de estúdio, uma sala de aula, um galpão para treinamentos de segurança. Guarde uma foto dele e use-a como foto de cena em todas as aberturas, para que pareçam gravadas no mesmo lugar.
4 fotos de referência
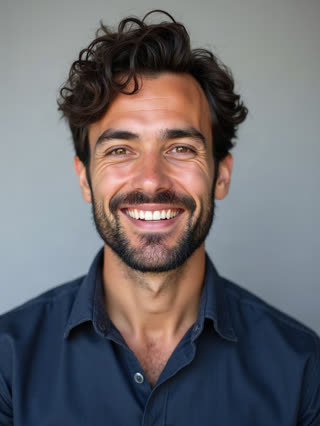
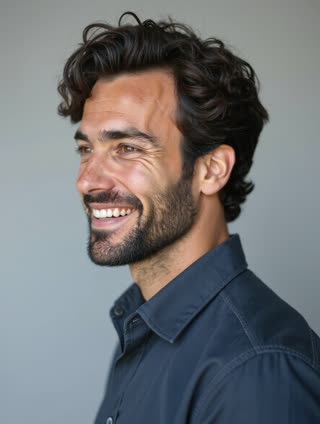
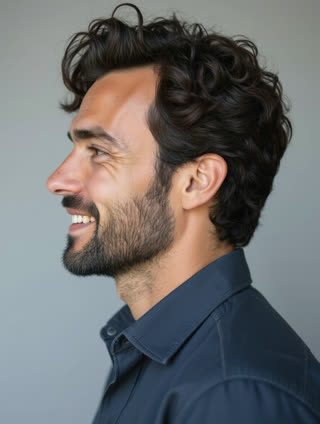
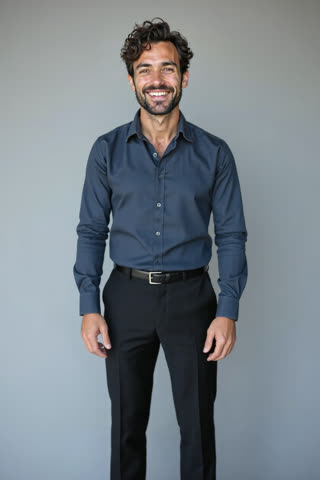
Um conjunto de planos para um curso
Gere uma biblioteca reutilizável em vez de planos novos para cada módulo:
1. Introdução do curso: o apresentador entra no cenário e para no centro, 6 segundos.
2. Abertura de módulo, três ou quatro variações: o apresentador se vira para a câmera, acena com a cabeça, gesticula para um espaço vazio onde aparecerá o título do módulo, 4 segundos cada.
3. Transição: o apresentador dá um passo para o lado ou aponta para fora do quadro para passar ao conteúdo de tela, 3 segundos.
4. Momentos de ênfase: inclinando-se para a frente, contando nos dedos, uma pausa curta com sorriso, 3 segundos cada.
5. Encerramento: o apresentador acena ou balança a cabeça e a câmera se afasta, 5 segundos.
Cerca de quinze clipes cobrem um curso de vinte módulos. Títulos, legendas e a narração são adicionados no seu editor, o que mantém todos os módulos consistentes mesmo quando o roteiro muda.
Roteiro e voz
Escreva pensando nos cortes. Mantenha as falas em câmera em uma ou duas frases e corte para o conteúdo de tela enquanto a narração continua. O público aceita uma voz que segue sobre os slides; percebe, sim, uma boca levemente fora de sincronia num plano longo.
Use uma única voz para toda a série, seja um narrador gravado ou uma voz sintética, e guarde suas configurações junto aos arquivos do curso. Para uma saudação curta de abertura, o modelo de vídeo pode gerar a fala por conta própria. Para algo mais longo, gere o plano sem fala e adicione a narração no seu editor, ou use uma ferramenta separada de sincronia labial no clipe final.
Indique o apresentador como gerado por IA nos créditos ou na descrição do curso. Em treinamentos corporativos, os alunos não devem ficar com a impressão de que um colega real gravou o vídeo.
Mantendo uma série longa consistente
Congele o conjunto de referências quando a produção começar. Crie uma nova versão se precisar mudar a roupa, e não misture versões dentro de um mesmo curso.
Fixe também o enquadramento: a mesma altura de câmera, distância e proporção em todas as aberturas. A consistência do enquadramento transmite a consistência da pessoa.
Gere as atualizações a partir das referências originais, não a partir de clipes anteriores, e revise os novos planos ao lado da introdução do curso antes de publicar.
Onde o RefVid entra
O RefVid mantém o apresentador como um personagem salvo, com 1 a 5 fotos, e uma foto do cenário pode entrar como foto de cena, então um módulo feito seis meses depois começa com as mesmas referências. Cada vídeo do apresentador aparece listado na sua página no estúdio para revisão. Os clipes têm de 3 a 15 segundos, em 16:9, 9:16 ou 1:1, no Kling 3.0 Omni.
Com o som ativado, o modelo gera o áudio junto com a imagem, e uma fala escrita entre aspas é dita exatamente como escrita; falas em inglês e chinês soam melhor. O RefVid não faz clonagem de voz, sincronia labial nem edição. Narrações longas, legendas e trechos com sincronia labial são feitos no seu editor ou em uma ferramenta de avatar.
Perguntas frequentes
- Um apresentador de IA consegue dar uma aula completa de 10 minutos?
- Não de forma confiável, como um único plano falado contínuo com modelos de vídeo baseados em referência. Use planos curtos do apresentador entre os conteúdos de tela, ou uma ferramenta de avatar falante dedicada para trechos longos.
- Posso basear um apresentador de IA em um instrutor real?
- Sim, com consentimento por escrito que cubra o vídeo com IA, os cursos envolvidos e o que acontece com a imagem quando ele deixar a empresa.
- Quantas imagens de referência um apresentador de IA precisa?
- Cinco: uma vista frontal, as duas vistas de três quartos, um plano da cintura para cima com as mãos visíveis e um plano de corpo inteiro, todos com a mesma roupa e luz. O RefVid aceita de 1 a 5 fotos por personagem.
- O RefVid adiciona narração ou sincronia labial?
- Não. O RefVid pode gerar som nativo junto com o clipe, e uma fala curta entre aspas é dita como escrita, com falas em inglês e chinês soando melhor. Narração, legendas e sincronia labial são feitas em outras ferramentas.