Seedream 5.5:キャラクターを作ってから動画へ - RefVid
自分の写真から数分で動画に · 最初の動画は無料、透かしなし





最初の動画は無料・カード不要
Seedream 5.5は、ByteDance Seedが2026年11月9日に公開した新しい画像モデルです。画像の生成と編集ができ、最大100回の編集を重ねても変更を頼んでいない部分はそのまま保ち、透過PNGのレイヤーも出力できます。動画は作れません。Seedreamのキャラクターや商品が同じ姿のままの動画を作るには、Seedreamでその画像を3〜5枚作り、RefVidに一つの被写体として一度だけ保存して、シーンを書きます。あとはKling 4.0が、どのクリップでもその画像をもとに動かします。
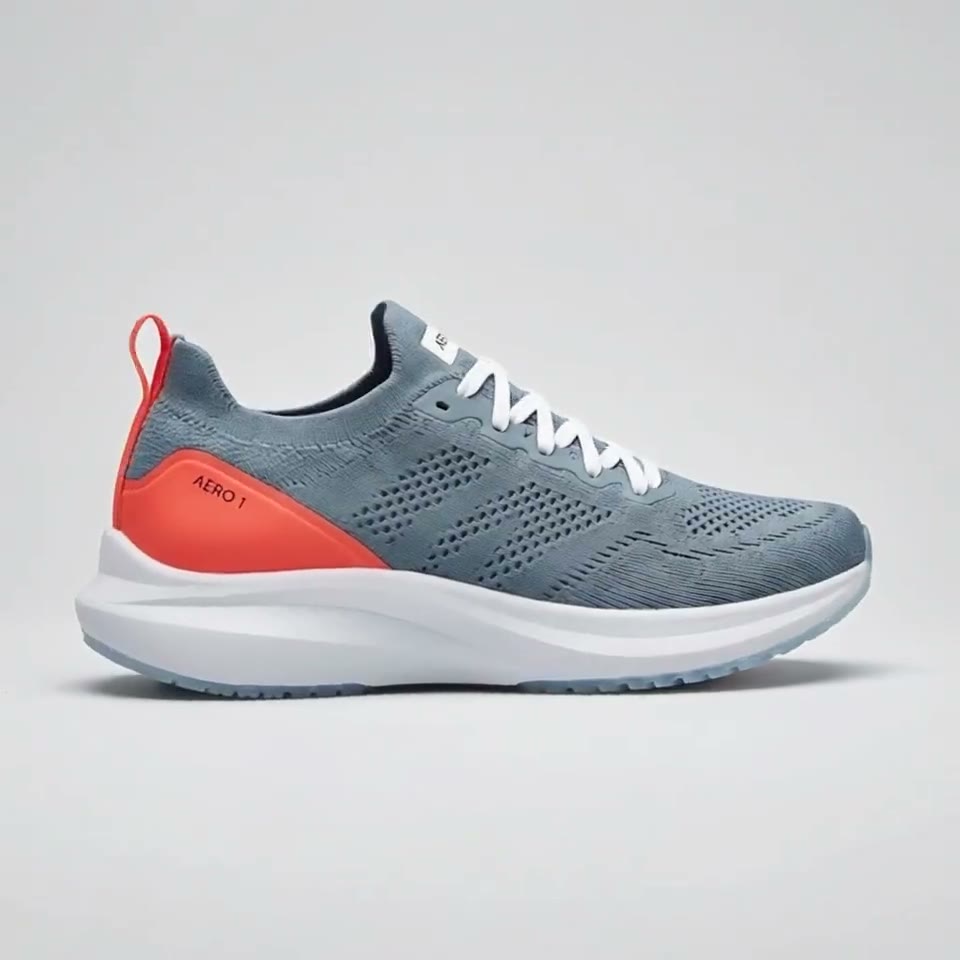
AIで作った参照画像4枚


新しいSeedreamとは?
- Seedreamのバージョン5.5は、動画モデルSeedanceを手がけるByteDance Seedの画像生成・編集モデルです。プロンプト、またはプロンプトと参照画像から画像を作り、その画像を何度でも編集できます。動画は作れません。ByteDanceの動画モデルはSeedance 2.5です。
- ByteDanceが挙げる改善点は4つです。最大100回の編集でも、触れていない部分をピクセル単位で同じに保つこと、透過・半透過の背景(RGBA)にネイティブ対応したこと、光や質感、肌がより自然になったこと、小さく詰まった文字がきれいになったことです。5.5シリーズのPro版も今後登場すると予告されています。
Seedream 5.5 リリース日と試せる場所
- ByteDance Seedは2026年11月9日にバージョン5.5を公開しました。モデルページでは、試せる場所としてByteDanceのチャットアプリDolaとBytePlusのプレイグラウンドの2つを案内しています。2026年11月11日時点で、ByteDanceはこのページに料金を載せておらず、fal.aiもまだSeedream 5.0のモデル(Pro、Lite、Flash)だけを掲載していて、5.5はありません。
- 一部のAPI再販業者は、すでに独自の画像単価でバージョン5.5のエンドポイントを掲載しています。ByteDance自身の料金が公表されておらず比較して確かめられないため、ここでは紹介しません。
Seedream 5.5 vs 5.0 Pro
- ByteDanceは、新バージョンとSeedream 5.0 Proをeコマース、マーケティング、映画・テレビ、ゲーム、オフィス業務、ファッションデザインの6つの用途で比較しました。6つすべてで品質と使いやすさが向上し、映画・テレビとオフィスでの使いやすさは前バージョンの2倍以上、画像から画像のタスクではリアルさのGSBスコアが+55.62%だったと報告しています。
- 画像内の文字については、中国語と英語のテストで重大な誤りが0.4%、軽微な誤りが1.7%まで減ったとしています。これらはByteDanceが発表記事で示した独自の数値で、私たちは測定していません。
| テスト | バージョン5.5と5.0 Proの比較(ByteDance発表) |
|---|---|
| 6つの用途(eコマース、マーケティング、映画・テレビ、ゲーム、オフィス、ファッション) | 6つすべてで品質と使いやすさが向上 |
| 映画・テレビとオフィスでの使いやすさ | 前バージョンの2倍以上 |
| リアルさ(画像から画像) | GSBスコア+55.62% |
| 文字の重大な誤り/軽微な誤り(中国語・英語) | 0.4%/1.7% |
| ほかの部分を変えない編集 | 最大100回 |
| 透過出力(RGBA) | ネイティブ対応 |
Seedreamの画像から、一貫した動画へ
- まずキャラクター、それから動画です。Seedreamで気に入った画像を1枚作り、複数回の編集機能を使って、ポーズだけを変えながら正面、斜め45度、横向き、全身の同じキャラクターを用意します。光は均一に、背景は無地にしてください。透過PNGで書き出した場合は、アップロードする前に無地のグレーか白の背景に載せます。
- 次に、そのうち3〜5枚を一つの被写体としてRefVidに追加し、名前を付けます。以降はその名前を入れてシーンを書くだけで、どのクリップも同じ画像から始まるため、顔や服、ラベルがクリップごとにずれません。
| ステップ | やること |
|---|---|
| 1. Seedreamでデザインする | キャラクターや商品のはっきりした画像を、無地の背景で1枚。 |
| 2. アングルを作る | 同じ画像を編集して、正面、斜め45度、横向き、全身の画像に。変えるのはポーズかアングルだけ。 |
| 3. RefVidに被写体を保存する | 画像を3〜5枚(最大10枚)一度だけ追加し、被写体に名前を付けます。 |
| 4. シーンを書いて生成する | どこで、被写体が何をして、カメラがどう動くかを、名前を入れて書きます。標準はKling 4.0、音声あり。 |
Seedreamのキャラクターにはどの動画モデル?
- リアルな人物なら、RefVidの標準モデルであるKling 4.0を使いましょう。720pまたは1080pで最大30秒、音声付きで、実在の人物のような顔にも対応します。おもちゃ、マスコット、ペット、イラストのキャラクターなら、Seedreamと同じByteDanceファミリーのSeedance 2.5も使えます。ただし、実在の人物のように見える写真は受け付けません。
- 最初のクリップに使えるプロンプトの例:「Boboが日の当たる公園のベンチを歩いて渡り、立ち止まってカメラに手を振り、腰を下ろす。ゆっくりズームイン、午後の暖かい光。」Boboを自分の被写体の名前に置き換えてください。
料金
- 画像モデルの料金は、ByteDanceまたは利用するアプリが決めます。RefVidでの動画部分はクレジット制で、Kling 4.0は音声込みで720pが1秒58クレジット、1080pが86クレジットです。単品動画は$2.99から、クレジットパックは$9.90から、プランは月額$10からで、クレジットに有効期限はありません。
- 新規アカウントにはKling 3.0 Omniの4秒動画が1本無料で付き、始めるのにカードは不要です。支払う前に、Seedreamの画像が参照画像としてうまく機能するか確かめられます。
AI動画モデルについてもっと読む
テキストから動画AI →
よくある質問
Seedream 5.5のリリース日はいつですか?
ByteDance Seedは2026年11月9日に公開しました。5.5シリーズのPro版も今後登場すると予告されていますが、日付は未定です。
Seedreamで動画は作れますか?
いいえ。バージョン5.5も、ほかのSeedreamと同じく画像モデルです。ByteDanceの動画モデルはSeedance 2.5です。Seedreamのキャラクターを動かすには、その画像をKling 4.0やSeedance 2.5などの参照から動画を作るモデルに参照画像として渡します。
Seedream 5.0 Proから何が変わった?
ByteDanceによると、最大100回の編集でも画像のほかの部分を変えずに保つこと、透過出力へのネイティブ対応、より自然な光と肌、小さな文字の鮮明さ、そして6つのテスト用途すべてで5.0 Proを上回る結果です。
新しいSeedreamは無料ですか?
ByteDanceはバージョン5.5のページに料金を載せていません。DolaとBytePlusのプレイグラウンドで試せるので、利用上限はそれぞれで確認してください。
Seedreamのキャラクターを動画で同じ姿に保つには?
Seedreamで、無地の背景でアングルの違う画像を3〜5枚作り、RefVidに一つの被写体として一度だけ保存して、各シーンをその名前で書きます。どのクリップも同じ画像から始まります。