Komponierte Startbilder für vom Nutzer gerahmte Produkt-Drehteller-Videos auf einem kommerziellen Videomodell: eine explorative Fallstudie
- Autor
- RefVid
- Veröffentlicht
- Zenodo-DOI
- 10.5281/zenodo.24288649
Status: explorative technische Fallstudie; eine kontrollierte Evaluation wurde nicht durchgeführt (Abschnitt 11 beschreibt die geplante).
Zusammenfassung
Wir beschreiben eine browserbasierte Oberfläche für den Bildaufbau von Produkten, die ein normalisiertes Grundflächen-Layout, Freisteller aus Referenzfotos, eine Konditionierung eines kommerziellen Videomodells (Kling 4 Reference-to-Video, über fal.ai angesprochen) auf das erste Bild und deterministische Standbild-Pausen an den Endpunkten kombiniert. Die Aufgabe stammte von einem europäischen Möbelhersteller mit einem Katalog von etwa 2.000 Produkten, der 360°-Drehteller-Videos aus drei oder vier gewöhnlichen Produktfotos erzeugen wollte und drei Mängel nannte, die einen Einsatz verhinderten: keine Kontrolle über Größe und Position des Produkts auf der Plattform, Teile des Produkts, die während der Drehung über den Plattformrand ragen, und ein sichtbarer Sprung beim Neustart der Schleife. Die Oberfläche lässt den Nutzer vier Layout-Parameter einstellen, zeigt eine Vorschau der Komposition, rastert sie (ohne Hilfslinien der Oberfläche) als Startbild des Clips und hängt nach der Generierung im Browser Standbilder vor und nach der Drehung an. Zuerst wurden Steuerung nur per Text, numerische Layout-Anweisungen sowie Start- und End-Anker auf einem früheren Modell erprobt (Abschnitt 3). In explorativen, unverblindeten Tests folgte das erste Ausgabebild in 6 von 7 Clips mit Kling 4 ungefähr dem komponierten Layout von Produkt und Plattform (alle 6 mit einem fotografisch schattierten Drehteller, 0 von 1 mit einer flach gezeichneten Scheibe); das ist Layout-Treue, keine Übereinstimmung des gesamten Bildes: In den vier Produktionsclips blieb der gezeichnete Hintergrund in 3 von 4 erhalten, im Sessel-Clip ersetzte das Modell ihn. In diesen vier Clips mit bewusst unterschiedlichen Einstellungen wurde in den abgetasteten Frames kein Produktteil über dem Plattformrand gesehen, und die gemeldete Differenz zwischen erstem und letztem Bild war gering. Diese Beobachtungen sind ermutigend, aber klein, adaptiv, teilweise nicht unabhängig reproduzierbar und belegen weder eine Erfolgsrate noch einen physischen Maßstab über Produkte hinweg, eine Eingrenzung während der gesamten Drehung oder eine nahtlose Schleife. Die Größensteuerung normalisiert die Grundfläche jedes Produkts auf die Plattform; sie erzwingt keinen gemeinsamen physischen Maßstab. Der Kunde kommentierte anschließend die vier Clips (Hintergrund, Dicke und Position der Plattform sowie ein runder Schatten unter dem Ecksofa); Frame 0 wurde überarbeitet, mit einem angepassten Studiohintergrund und dem eigenen Bodenschatten des Produkts, aus seinem Foto auf weißem Grund übernommen, anstelle einer gezeichneten Ellipse (Abschnitt 5). Sechs spätere Clips mit dem angepassten grauen Hintergrund und festen Einstellungen (Abschnitt 7.6) ergaben eine weitere Beobachtung: Nur mit Startbild fuhr die Kamera in einem Bett-Clip stetig heran, bis der Teller das Bild verließ, während vier andere Möbelstücke den komponierten Bildaufbau in jedem alle 0,5 s abgetasteten Frame behielten (Messungen des Operators); eine Wiederholung des Betts, bei der dasselbe komponierte Startbild auch als Endbild gesendet wurde, behielt den Bildaufbau bei und drehte sich einmal vollständig. Die Aufnahme nur mit Startbild driftete, die mit Start- und Endbild konditionierte nicht; die Wirkung des Eingriffs und die Quelle der Schwankung bleiben unbekannt. Das Senden des komponierten Startbilds als Endbild wurde dennoch noch am selben Abend umgesetzt und ausgeliefert (Abschnitt 4.4): Bei Drehung Auto oder 360° wird es nun automatisch gesendet. Das ist eine technische Entscheidung, kein Nachweis der Wirkung. Ein danach erstelltes zweites, ungefähr abgeglichenes Paar mit einem grünen Sessel bei 720p, mit ansonsten identischen Einstellungen und dem über den automatischen Pfad hinzugefügten Endbild, zeigte denselben Unterschied: Die Aufnahme, die mutmaßlich nur das Startbild trug (das fehlende Endbild ist aus Zeitablauf und Seitenzustand erschlossen, nicht aus dem Request abgelesen), fuhr heran, bis der Teller das Bild verließ; die Aufnahme mit Start- und Endbild behielt den Bildaufbau und drehte sich einmal vollständig. Zwei Paare mit je einer Aufnahme pro Arm belegen die Wirkung nicht. Zwei Clips, einer mit und einer ohne Endbild, erreichten die Frontpose 1–1,5 s zu früh und standen dann fast still, was die sichtbare Pause verlängerte; von den beiden Clips mit Start = Ende erreichte einer die Schwelle für frühe Ankunft und einer nicht, sodass ihr Zusammenhang mit dem Endbild unsicher bleibt. Fünf der sechs Clips wurden an den Kunden gesendet, dessen Urteil noch nicht vorliegt. Die Schattierungsvarianten aus Abschnitt 5 wurden nicht verglichen.
1. Einleitung
1.1 Problem und Kundenbedarf
Eingabe: drei oder vier Katalogfotos eines Produkts auf weißem Hintergrund (Frontansicht zuerst) und ein Produkttyp (Sofa, Sessel, Ecksofa, Pouf, Bett, Sonstiges). Ausgabe: ein kurzes Video, in dem sich das Produkt einmal auf einem runden Studio-Drehteller dreht, mit fester Kamera, in 1:1, 9:16 oder 16:9.
Der Kunde, ein europäischer Möbelhersteller, hatte auf einer Self-Service-Plattform für KI-Videos mehrere Drehteller-Clips erstellt und erklärt, er würde einen Einsatz für einen erheblichen Teil einer Kollektion von etwa 2.000 Produkten in Betracht ziehen, wenn die Ergebnisse konsistent wären und sich die Darstellung steuern ließe. Seine Anforderungen, zusammengefasst aus der Korrespondenz:
- R1. Steuerung von Größe und Position vor der Generierung, konsistent über die Kollektion. Der Nutzer sieht Maßstab und Position des Produkts auf der Plattform in einer Vorschau und passt sie an, und die Stücke behalten über die Videos hinweg konsistente Proportionen. Der Kunde beschrieb Sofas, die für die Plattform zu groß waren und deren Beine über die Ränder ragten, viel zu kleine Sofas und einen Sessel, der allein richtig wirkte, neben Sofas aus anderen Videos aber unproportioniert. Die Anforderung wurde in zwei späteren Feedbackrunden wiederholt.
- R2. Verbleiben auf der Plattform. Jeder Teil des Produkts bleibt während der gesamten Drehung auf der Plattform (angesprochen bei einem Ecksofa, dessen hinteres Bein mitten in der Drehung über den Rand ragte).
- R3. Schleife. Kein sichtbarer Sprung an der Stelle, an der die Drehung neu beginnt; optional eine Pause von etwa 2 s nach der Drehung.
- R4. Gleichmäßige Drehung ohne Ruckeln, angesprochen bei verlangsamter Wiedergabe im Player (0,5×). Eine konstante Winkelgeschwindigkeit wurde nie verlangt.
- R5. Drehbereich außer 360° (270° sowie ein Schwenk: von der Front 90° zu einer Seite, zurück zur Front, dann 90° zur anderen Seite).
- R6. Eigene Komposition je Format für 9:16, 16:9 und 1:1 statt eines Zuschnitts, den der Kunde für große Stücke wie Sofas, Ecksofas und Betten als unzureichend beurteilte.
Dieser Bericht behandelt R1–R3; R5 und R6 kommen dort vor, wo sie den Entwurf beeinflussen.
1.2 Warum das auf einem kommerziellen Endpunkt schwierig ist
Die Fotos erreichen das Modell als Referenzen, nicht als Bild der Szene. Das Modell zeichnet den Drehteller, dessen Größe und Position, den Kameraabstand und die Größe des Produkts selbst, und jeder Clip wird unabhängig generiert. Das fal-Schema für Kling 4 Reference-to-Video [19] führt prompt, multi_prompt, duration, start_image_url, middle_image_urls, end_image_url, image_urls, video_urls, elements, voice_ids, resolution und aspect_ratio auf; kein zugänglicher Parameter überträgt Kamerapose, Drehrichtung, physischen Maßstab, Seed oder Guidance. Geometrische Anforderungen lassen sich daher nur in Worten oder als Bilder ausdrücken. Über die internen Mechanismen des proprietären Modells treffen wir keine Aussage.
1.3 Beitrag
Eine technische Integration und explorative Einsatzstudie, kein neues Verfahren zur Videogenerierung:
- Ein Browser-Kompositor, der den Freisteller des Produkts mit vier vom Nutzer eingestellten Parametern auf einen gezeichneten, fotografisch schattierten Drehteller setzt, wobei der Bodenschatten aus dem Produktfoto selbst stammt (Abschnitt 5), eine Vorschau zeigt und das Ergebnis als Startbild des Clips sendet (bei vollen Drehungen inzwischen auch als Endbild, Abschnitt 4.4), zusammen mit den Referenzen aus mehreren Ansichten und einem strukturierten Prompt.
- Eine deterministische Nachbearbeitung im Browser, die dem generierten Clip Standbilder an den Enden (Standbild-Pausen) anhängt.
- Eine Darstellung der gescheiterten Alternativen (Prompt-Formulierung, numerischer Layout-Text, Start- und End-Anker sowie verkettete Clips auf einem anderen Modell, ein generierter Referenzsatz aus mehreren Ansichten) und der Grenzen der Zuverlässigkeit, die offen bleiben.
2. Begriffe
- Produkt: ein Katalogartikel (SKU). Form: der in der Oberfläche gewählte Produkttyp, der eine generische Grundfläche W × D in cm mitbringt (Abschnitt 4.3).
- Element: das Bündel der Fotos eines Produkts, das als Subjektreferenz an das Modell gesendet wird (ein Frontbild plus Referenzbilder).
- Komponiertes Startbild: das PNG, das der Browser aus dem Kompositor rendert und als
start_image_urlsendet. Vorschau: dieselbe Komposition auf dem Bildschirm, mit einem gestrichelten Hilfsring, den das komponierte Startbild weglässt. - Erstes Ausgabebild: das erste decodierte Bild des Clips, den das Modell zurückgibt.
- Rohclip: die MP4-Datei, wie der Anbieter sie zurückgibt. Clip mit Standbildern: die MP4-Datei nach der Nachbearbeitung im Browser (Standbild-Pausen angehängt, gesamter Clip neu codiert).
- Größe: der Schiebereglerwert (30–100 %), der von der Drehachse am weitesten entfernte Punkt der Produktgrundfläche in Prozent des Scheibenradius. In Gleichungen ist s = Größe / 100 ein Bruch.
- Layout-Treue: Das erste Ausgabebild zeigt Produkt und Plattform in etwa in der komponierten Größe und Position, visuell beurteilt. Erhalt des Hintergrunds: Das erste Ausgabebild behält den komponierten Hintergrund bei. Beides wird getrennt berichtet; keines von beiden ist eine Übereinstimmung des gesamten Bildes.
- Prompt v9: die Version des Prompt-Textes. Festgelegtes Rezept: die Kombination aus komponiertem Startbild, Prompt v9 und Standbild-Pausen im Browser, die nach den lokalen Tests aus Abschnitt 3 übernommen wurde.
- Operator: das Teammitglied, das die späteren Clips generiert und gemessen hat; „vom Operator berichtet“ kennzeichnet Werte, deren Messdateien nicht zu den Belegen gehören, die wir nachprüfen konnten.
3. Wie das Verfahren entstand
3.1 Verlauf
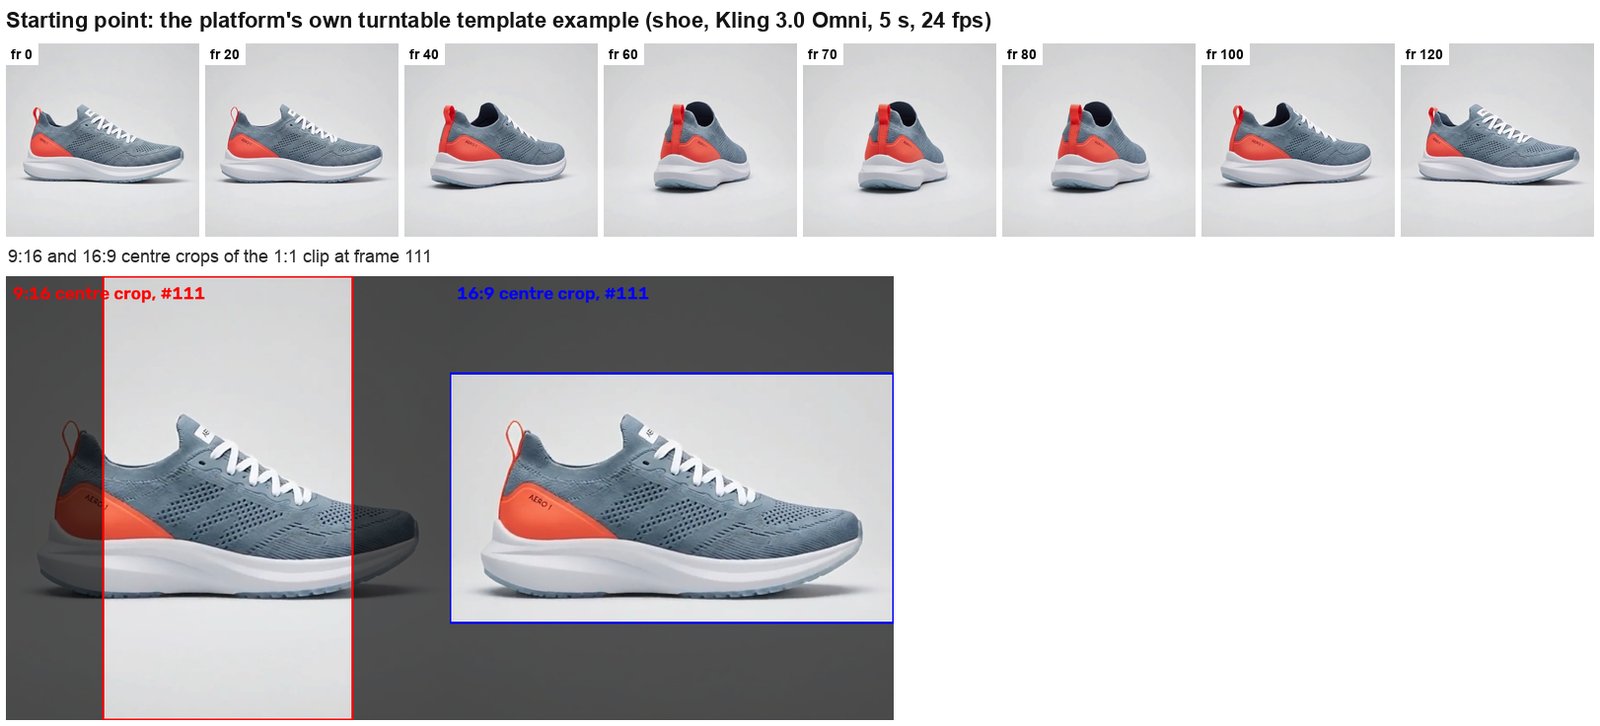
Ausgangspunkt. Die ersten eigenen Versuche des Kunden waren fünf Clips auf drei Modellen, erstellt aus Handy-Screenshots eines Webshops (Statusleiste, Adressleiste und Symbolleisten inklusive, das Möbelstück klein in einem hohen weißen Bild; zwei Sätze enthielten zusätzlich Detail-Nahaufnahmen). Bei Durchsicht von einem Bild alle 0,5 s zeigten zwei der drei Kling-4-Clips bereits saubere volle Drehungen; die Probleme waren die Größe auf dem Teller (ein Sofa so breit wie der Teller oder breiter, ein Sessel, der das Bild wie ein Sofa ausfüllte, ein winziges Bett auf einem großen Teller), die Konsistenz zwischen den Stücken, ein Bett, das nur zu einer Seite schwenkte, und in einem Clip ein Schnitt auf eine Nahaufnahme der Armlehne mit wechselnder Anzahl von Beinen. Wir führten den Schnitt auf die Nahaufnahme auf die Detailfotos zurück; das ist die Deutung eines einzigen Clips, keine geprüfte Ursache. Die Eingaben wurden daraufhin vorbereitet, indem die Screenshots mit etwa 8 % Rand auf das Möbelstück zugeschnitten und Detail-Nahaufnahmen aussortiert wurden. In den eigenen Vorlagenbeispielen der Plattform schwenkte ein Schuh-Clip (Kling 3.0 Omni) etwa 75° hin und zurück, und ein Figuren-Clip drehte sich etwa 270° und schnitt auf eine Nahaufnahme, obwohl der Prompt eine volle 360°-Drehung verlangte. In den untersuchten Clips war der Bildaufbau der Kamera innerhalb eines Clips stabil (Tellerbreite 80,9–81,1 % des Bildes; die Oberkante des Produkts bewegte sich um 1,9 %, die Mitte um 3,3 %), was Frame 0 als Steuerungspunkt nahelegte. Ein mittiger 9:16-Zuschnitt eines 1:1-Clips schnitt bis zu 28,3 % des Produkts ab (R6). Alle gemessenen Clips hatten 24 fps (Kling 4, Kling 3.0 Omni, PixVerse C1). Zunächst wurde entschieden, keine manuelle Steuerung von Größe und Position zu bauen und stattdessen auf Prompt-Vorgaben zu setzen; diese Entscheidung wurde später revidiert.
Prompt v1: Drehungseinstellung und Vorgaben für den Bildaufbau. Eine Einstellung „Drehung“ und serverseitig zusammengesetzte Vorgaben („the whole product stands fully on the turntable … centred … fills most of its surface; the camera is locked off“) wurden ohne kontrollierten Test ausgeliefert. „Fills most of its surface“ lässt jedes Produkt den Teller ausfüllen und widerspricht damit der zweiten Hälfte von R1. Der ursprüngliche Vorschlag für diesen Schritt war bereits gewesen, das erste Bild zu komponieren, mit einer separaten Option für einen gemeinsamen physischen Maßstab (eine feste Tellerbreite in cm und die reale Breite jedes Produkts); Letztere wurde nicht gebaut.
Gleichmäßige Zeitlupe und Drehbereich durch Schnitt (lokale Tests). Bildinterpolation (ffmpeg minterpolate) verringerte den Fehler bei zurückgehaltenen Bildern gegenüber einfacher halber Geschwindigkeit etwa um den Faktor 4, mit Artefakten dort, wo sich Teile überkreuzen; interpolierte Ausgaben wurden verworfen, und die Antwort auf R4 wurde ein längerer Clip mit der nativen Bildrate des Modells. Für R5 wurden Schwenk und 270° ohne neue Generierung aus einem vorhandenen 360°-Clip herausgeschnitten: Die Übergänge an den Umkehrpunkten waren sauber (das 0,90–0,91-Fache eines normalen Bildschritts), der Übergang zurück zur Frontansicht sprang jedoch um das 2,28-Fache eines normalen Schritts und hätte ein bestpassendes Bild und eine Überblendung über 2–3 Bilder gebraucht; zudem funktioniert das Herausschneiden eines Bereichs nur bei einem Clip, der sich tatsächlich durchgehend um 360° dreht, was das Modell nicht garantierte. Der Drehbereich wurde stattdessen als Prompt-Satz ausgeliefert, und die Bewegungssequenz ist seitdem vom Modell generiert.
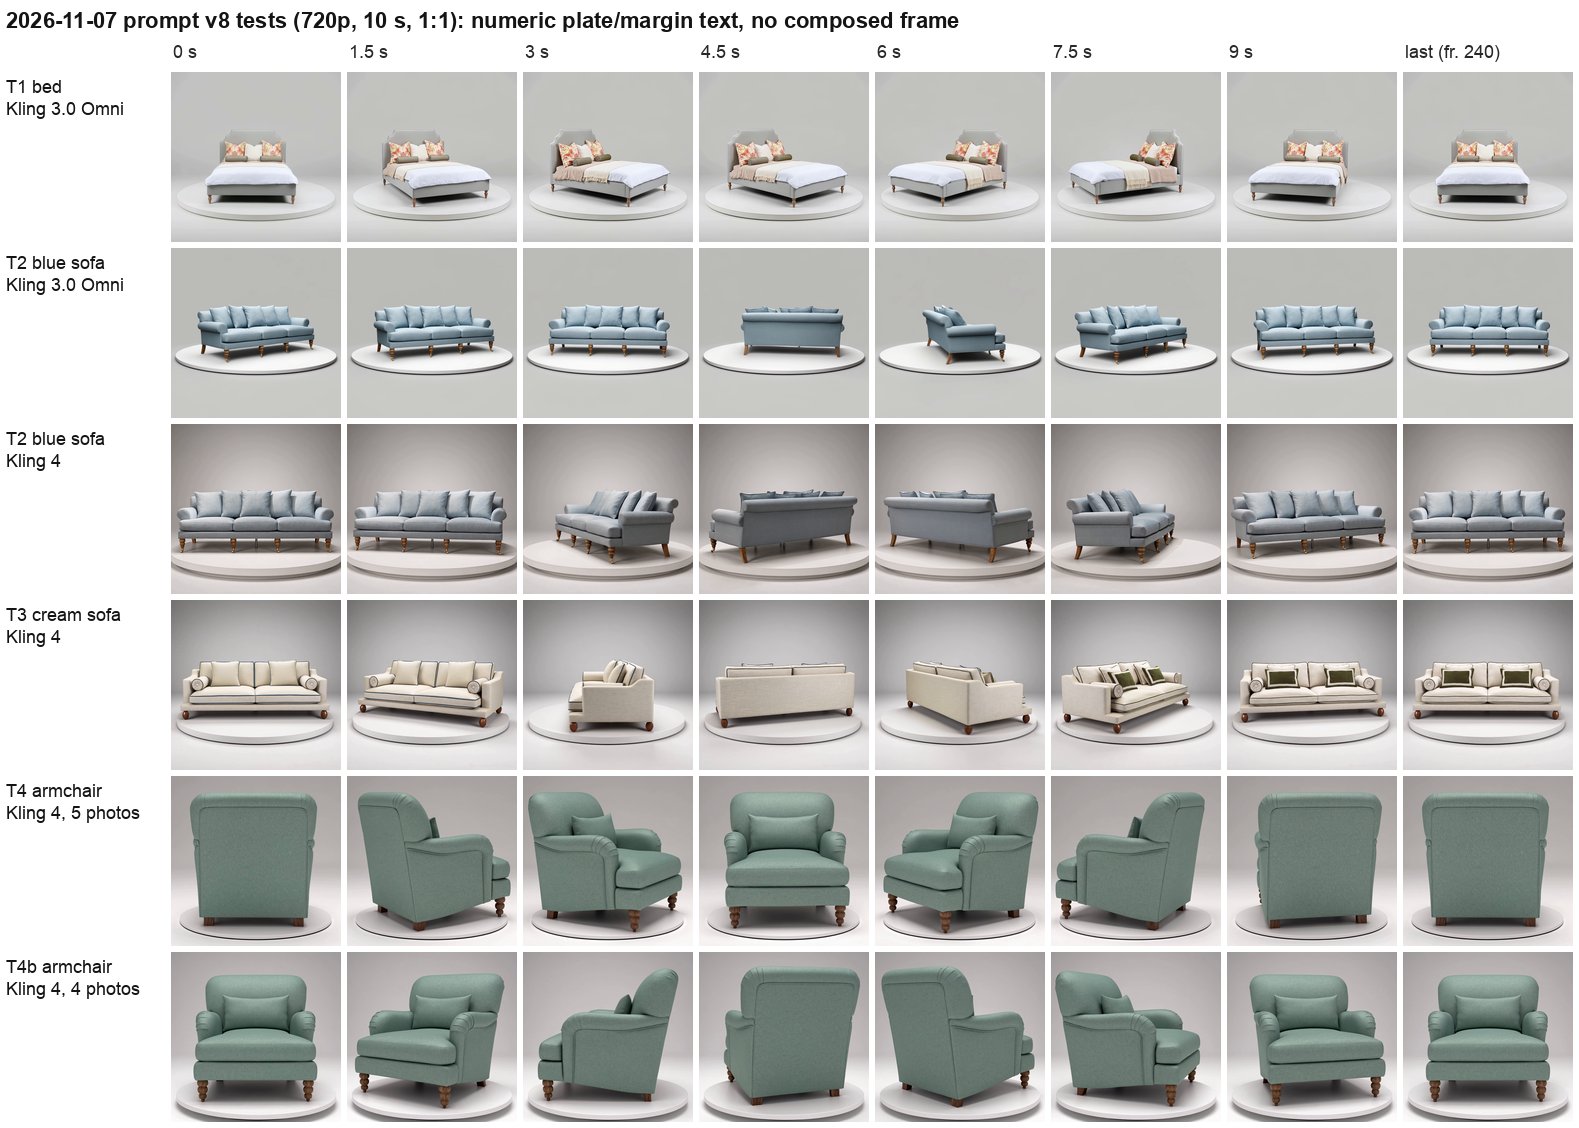
Prompt-Versionen v2–v8. v2–v7 waren Vorschläge und Entwürfe, nicht generiert. v8 wurde in der Produktion getestet: ein Bett mit Schwenk (Kling 3.0 Omni), ein blaues Sofa (Kling 3.0 Omni und Kling 4), ein cremefarbenes Sofa und ein grüner Sessel (Kling 4), 720p, 10 s, 1:1 (Abbildung 2). Numerische Anweisungen (5 % Abstand zum Teller, 5 % Bildränder) befolgte keines der beiden Modelle; Kling 3.0 Omni zeichnete einen großen Teller, Kling 4 einen Teller, der breiter als das Bild war. Derselbe Satz „first reference orientation as 0°“ wurde beim blauen Sofa (Kling 4) befolgt, beim Sessel nicht, der auf der Rückseite des Stuhls begann. Die sechs Referenzfotos des cremefarbenen Sofas zeigten zwei Konfigurationen desselben Sofas, und das Video wechselte mitten in der Drehung die Konfiguration; widersprüchliche Referenzen sind eine plausible Mitursache solcher Wechsel. Ein Folge-Durchgang mit dem Sessel (T4b), bei dem die Fotos von fünf auf vier reduziert wurden (Front, Seite, hintere Seite, Rückseite) und alle mit der Front als Frontbild ins Element gelegt wurden, begann auf der Front und drehte sich vollständig und durchgehend zurück zur Front. Die damals festgehaltene vorläufige Erklärung lautete, dass im früheren Durchgang das fünfte Foto (Rückseite) als separates Referenzbild statt ins Element geleitet worden war. Ein einzelnes Clip-Paar; nicht beweiskräftig, es deutet aber darauf hin, dass die Zuordnung der Referenzen und nicht nur die Befolgung von Sätzen die Startpose beeinflusste.
Die Kollektion des Kunden. Der Kunde schickte daraufhin fünf Stücke (Sessel 85 × 85 × 82, Sofa 240 × 94 × 82, Pouf 105 × 60 × 47, Ecksofa 240 × 200 × 82, Bett 210 × 163 × 123 cm) mit je 3–4 Fotos, insgesamt 16, sowie ein Maßblatt. Alle sind Freisteller auf Weiß mit etwa 1200 × 800 px; die Pouf-Fotos sind 3D-Renderings, in denen der Pouf nur etwa 45 % seines Bildes ausfüllt; Sessel, Sofa und Bett haben keine gerade Rückansicht (Sessel und Sofa haben eine hintere Dreiviertelansicht; vom Bett gibt es keine Ansicht der Kopfteil-Rückseite); die Ecksofa-Fotos haben statt reinem Weiß eine leichte graue Vignette und zeigen die Récamiere in jeder Ansicht rechts; das Bettzeug des Betts ist auf den Fotos unterschiedlich arrangiert. „Gewöhnliche Produktfotos“ bezeichnet in diesem Bericht diese Katalogbilder, und Aussagen zur Detailtreue beschränken sich auf das, was sie zeigen. Die generischen Grundflächen von fünf der sechs Formen in Abschnitt 4.3 (alle außer „Sonstiges“) sind die Maße dieser Stücke.
Versteckte Prompt-Ebenen. Die Produkte wurden in der Produktion generiert (Kling 4, 1080p, 1:1, 10 s), während serverseitige Prompt-Ebenen bearbeitet wurden: v1 „never reverse“; v2 entfernte „axis“ und ergänzte einen Satz zur flachen Scheibe nach einem Durchgang mit einer weißen Stange unter der Sitzfläche; v3 „frame 1 shows the product at exactly 0°“; v4 ein neuer Satz zum Schwenk. Mit v3 begannen Sessel, Sofa, Pouf und Ecksofa auf der Front und drehten sich einmal, ohne Stange. Das Bett scheiterte zweimal, und seine Fotos widersprachen einander. Dem Kunden war kurz zuvor mitgeteilt worden, dass manuelle Größeneinstellung nicht empfohlen werde. Vier dieser Clips wurden geliefert und bilden die Ausgangsbasis von Abschnitt 7.2; die Antwort des Kunden sprach Maßstab, den Sprung am Ende und das über den Rand ragende Ecksofa an.
Mechanismusanalyse, ein überzogenes Versprechen und seine Korrektur. Eine Antwort auf dieses Feedback versprach ein passendes letztes Bild, eine Pause, einen in der Größe angepassten Drehteller und neue Versionen. Bei der Überprüfung war nichts davon durch einen verfügbaren Mechanismus garantiert, und es wurde eine Korrektur verschickt, die feststellte, dass exakte Proportionen zwischen Produkten, das Verbleiben auf der Plattform während der gesamten Drehung und ein mit dem ersten identisches letztes Bild nicht garantiert werden könnten. Zwei Arbeitsregeln wurden festgelegt: eine nicht erfüllte Anforderung durch das Finden eines Mechanismus statt durch weitere Versuchsdurchgänge erfüllen und Ergebnisse nur an den eigenen Worten des Kunden messen. Die Analyse umriss zwei Wege: Rendern aus einem 3D-Modell (Weg A) oder Einschränken des Videos durch komponierte Bilder (Weg B). Eine interne Bewertung mit eigenen Konfidenzangaben kam zu dem Schluss, dass Text Maßstab, Verbleiben auf der Plattform oder eine exakte Schleife nicht garantieren kann (hoch); ein komponiertes Startbild kann Frame 0 festlegen (hoch); der Maßstab nach Frame 0 ist Modellverhalten (mittel, nicht verifiziert); exakte Standbild-Pausen erfordern Nachbearbeitung. Der Kunde bat darum, weiter zu testen, und fragte erneut nach einer vom Nutzer einstellbaren Größe und einer Pause von 2 s. Unsere Antwort sagte beides zu: eine Option, einzustellen, wie viel des Bildes das Produkt ausfüllt, sodass jedes Produkt in einer konsistenten Größe beginnt, mit dem Vorbehalt, dass sich die Größe während der Drehung noch verschieben kann, und der Behauptung, dass eine erneute Generierung in der Regel ein besseres Ergebnis liefern würde; sowie eine Pause von 2 s nach der vollen Drehung. Das waren Zusagen in der Korrespondenz, keine validierten technischen Schlussfolgerungen; insbesondere die Behauptung zur erneuten Generierung war durch keine gemessene Quote gestützt.
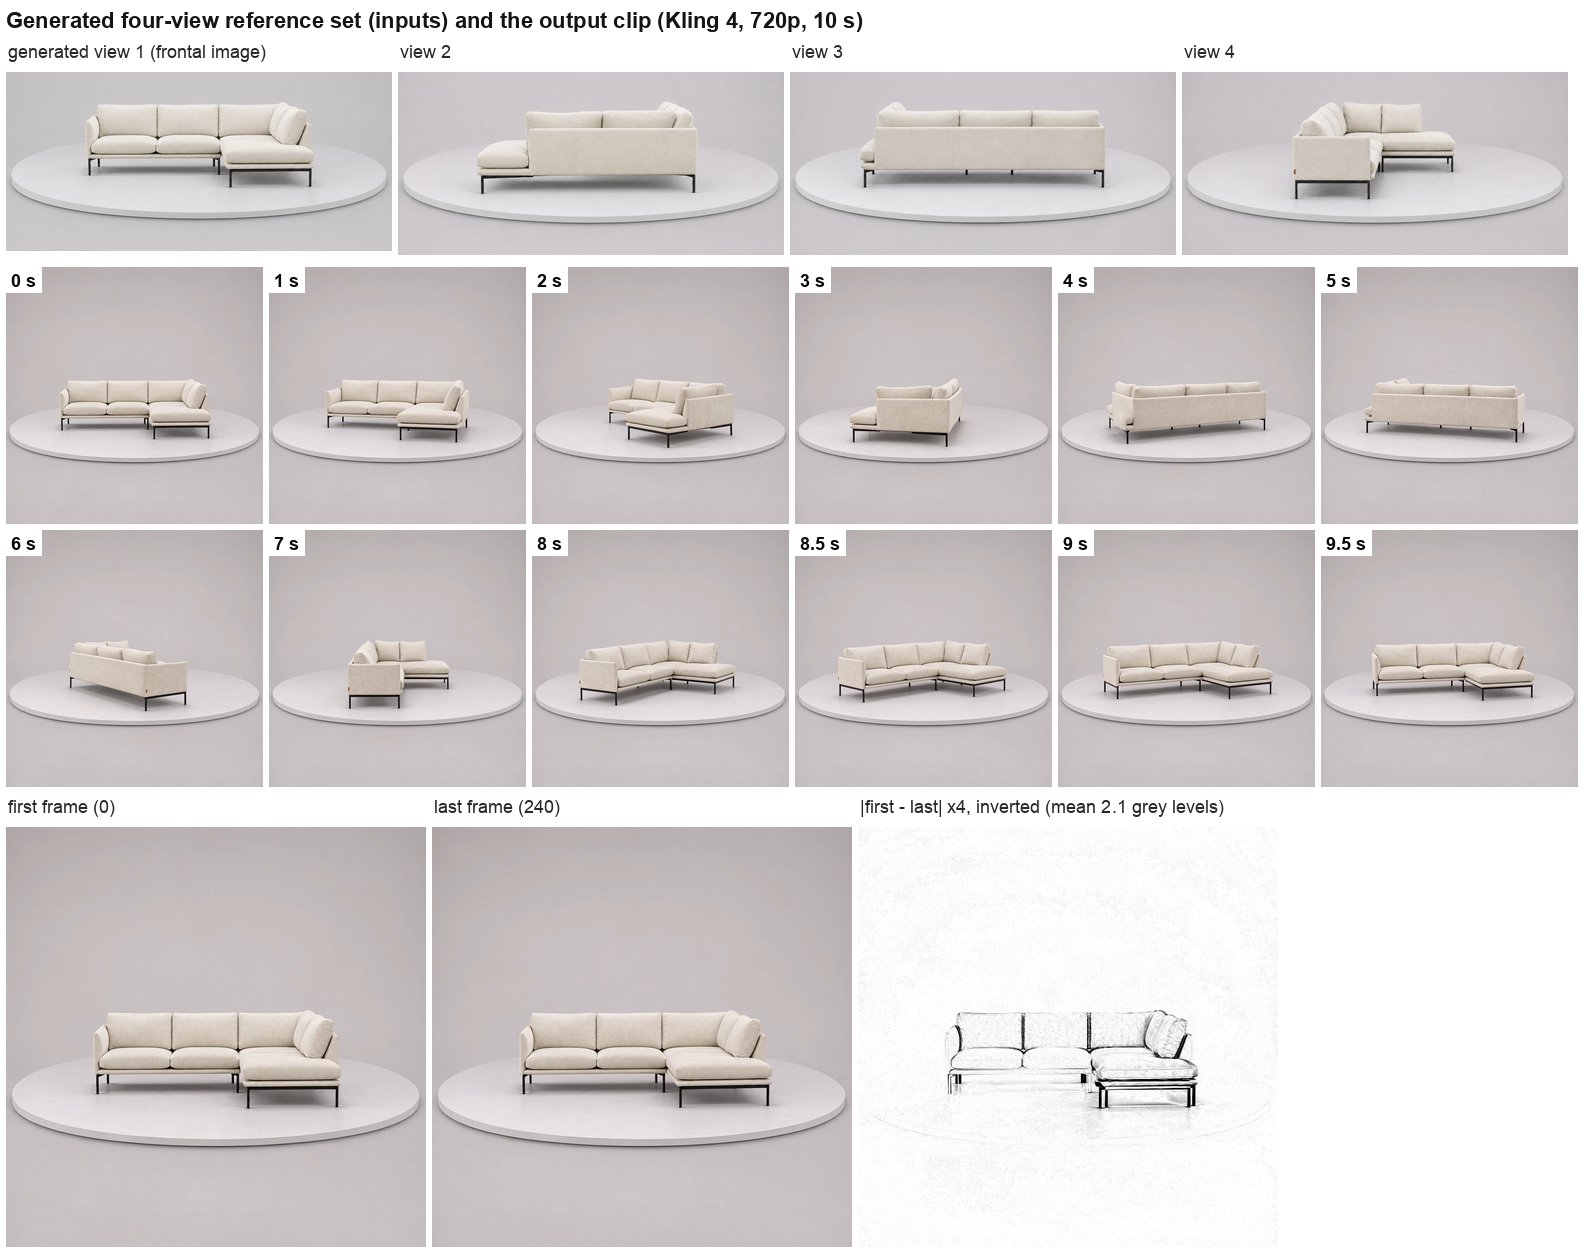
Generierter Referenzsatz aus vier Ansichten. Eine Produktionsgenerierung auf Kling 4 Reference-to-Video (720p, 10 s, 1:1) verwendete vier generierte Bilder des Ecksofas aus mehreren Blickwinkeln als einen Subjekt-Referenzsatz (das erste als Frontbild, die anderen als Referenzbilder), ohne Start-, End- oder Zwischenbilder. Der ursprüngliche Request-Body war nicht verfügbar; die Rekonstruktion beruht auf dem gespeicherten Datensatz und dem aktuellen Code. Der gespeicherte Prompt verlangte bereits 90° pro Viertel, konstante Geschwindigkeit, keine Umkehr, unveränderte Struktur und eine Rückkehr zur Front und sagte außerdem „the spin never stops“ und „zero dwell“, was der gewünschten Pause widerspricht. Um 8 s zeigte die Verbindung zwischen der langen Sitzfläche und der Récamiere einen sichtbaren Knick, der sich zur Frontansicht hin begradigte, also eine strukturelle Drift (keine Winkelmessung); erstes und letztes Bild lagen beide nahe der Front, die Außenkante der Récamiere und die vorderen Beine deckten sich jedoch nicht (mittlere absolute Graudifferenz über das ganze Bild 2,1), sodass es keine verifizierte nahtlose Schleife ist; in den stichprobenartig geprüften Bildern war kein Bein über dem Tellerrand zu sehen. Die vier Eingabeansichten waren nicht auf geometrische Konsistenz geprüft worden, sodass sich Inkonsistenz der Eingaben und Drift des Modells nicht trennen lassen. Unabhängig davon zeigten vier mit einem Bildmodell generierte Keyframe-Bilder Unterschiede in Proportionen und Details zwischen den Blickwinkeln und wurden keinem Videomodell übergeben.
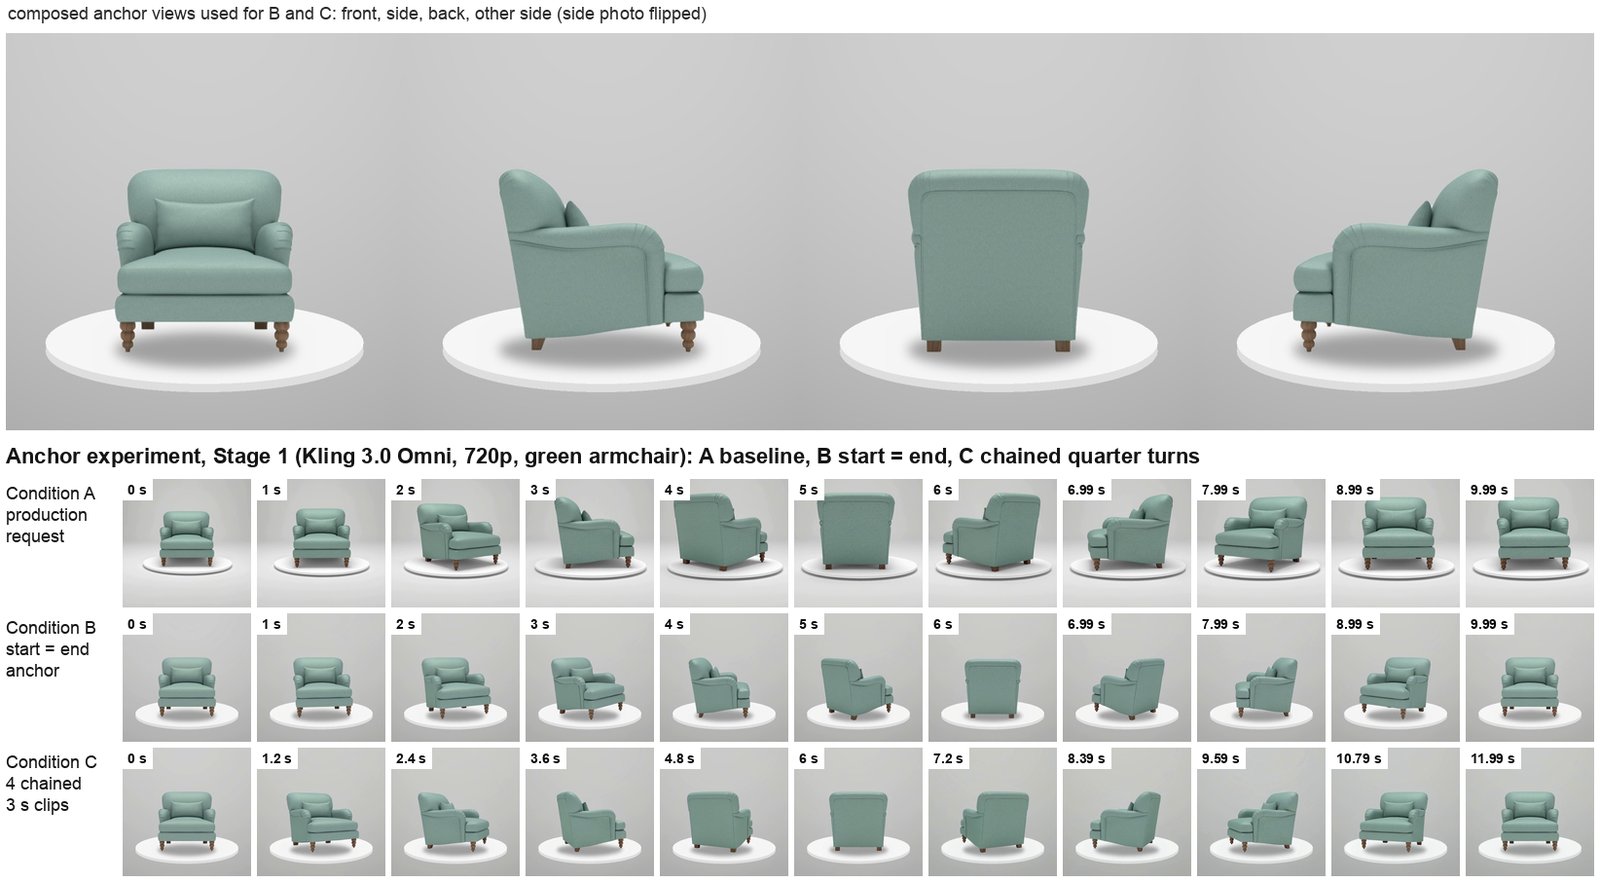
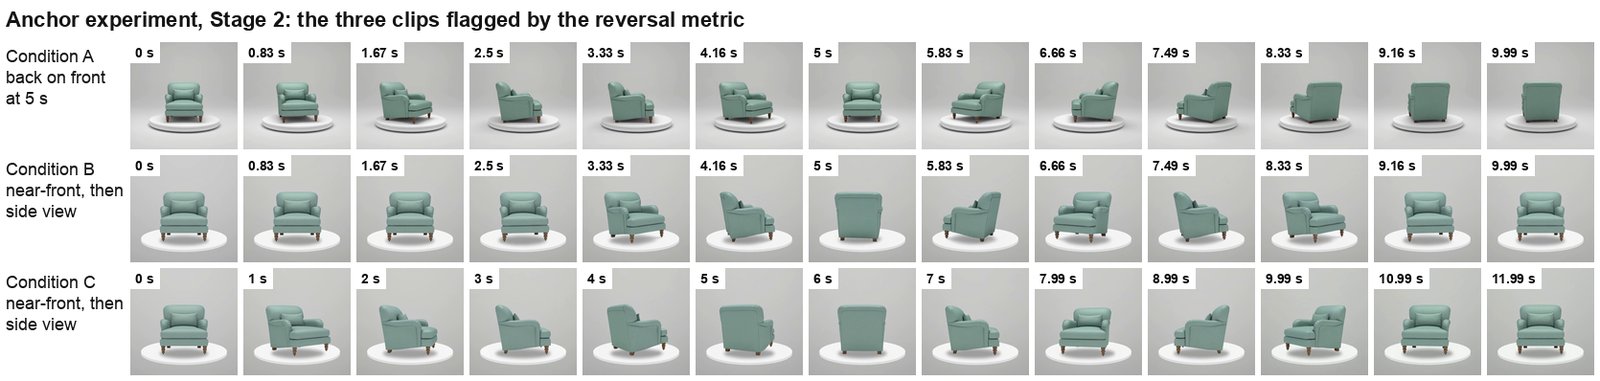
Komponierte Anker und verkettete Vierteldrehungen auf Kling 3.0 Omni. An einem grünen Sessel mit fünf konsistenten Fotos (Kling 3.0 Omni, 720p, ohne Ton, 1:1) wurden drei Bedingungen mit je drei Clips geprüft: A, der Produktions-Request (Ausgangsbasis); B, A plus ein komponiertes Frontbild sowohl als start_image_url als auch als end_image_url; C, vier verkettete 3-s-Clips, die jeweils auf dem letzten Bild des vorherigen Clips beginnen und auf einer komponierten Ansicht der nächsten Seite enden (die 270°-Ansicht war das gespiegelte Seitenfoto). Vor jedem neuen Clip wurden neun vorhandene Clips (gemischte Modelle, Prompts und Produkte) bewertet: 8 von 9 drehten sich ganz herum, nur 3 von 9 schlossen innerhalb des 2-Fachen eines normalen Bildschritts an (Nahtverhältnisse auf einem mittigen Ausschnitt), und nur T4b erfüllte Drehung, Start auf der Front, Naht und keine Veränderung zugleich. Das Bewertungsverfahren wurde an T4 und T4b kalibriert: Ein Maß für gleichmäßige Drehung trennte die gleichmäßige Drehung von T4b (größte Lücke 0,36 s) von der auf der Rückseite beginnenden von T4 (1,38 s); die Nahtverhältnisse über das ganze Bild betrugen 0,49 und 0,88 und lagen damit unter den Werten der früheren Analyse auf dem mittigen Ausschnitt für dieselben Clips (1,0 und 1,5), sodass die beiden Messungen nicht austauschbar sind; und Kling 4 zeichnete den Sessel mit etwa 73–75 % der Bildbreite gegenüber 45 % für seine reale Größe auf einem 150-cm-Teller. Neun finale Videos entstanden aus 18 Anbieteraufrufen (A 3, B 3, C 12), 96 generierten Sekunden. Bestehensgrenzen wurden vor der ersten Stufe festgelegt; ein absoluter Nahtschwellenwert und eine Umkehrmetrik kamen später hinzu (Abschnitt 7.4). Ergebnisse: Produktbreite in Frame 0 in allen sechs B- und C-Clips innerhalb von 0,7 % des komponierten Werts, während A zwischen −21 % und +18 % schwankte und ein A-Clip während der Drehung um 44 % wuchs; letztes gegenüber erstem Bild 1,9–2,1 Graustufen für B und 3,5–4,5 für C gegenüber 7,2–21,8 für A; in allen neun nach Augenmaß in 16 Bildern kein Bein über dem Rand; in jeder Bedingung kehrte einer von drei Clips um oder drehte zu weit (in den Bildstreifen wiederholen sich Ansichten außer der Reihe: Ein Clip der Ausgangsbasis ist bei 5 s wieder auf der Front und endet auf seiner Rückseite; ein B-Clip und ein C-Clip zeigen eine fast frontale Ansicht, gefolgt von einer Seitenansicht, bevor sie auf der Front enden). Die Arbeit mit diesem Modell wurde eingestellt; eine vorgeschlagene dritte Stufe (Richtung in jedem Segment benannt) wurde nicht durchgeführt. Das Video „nicht vom Modell generiert“ zu machen, indem das Produkt in jedem Bild auf einen Teller montiert oder Bilder ersetzt werden, wurde ausgeschlossen.
3D-Weg (entworfen, nicht durchgeführt). Als Quellen kamen die eigenen 3D-Modelle des Kunden oder eine Bild-zu-3D-Generierung aus den Fotos mit einem kleinen Demo-Budget in Betracht. Eine Anfrage nach 3D-Dateien wurde entworfen, aber nicht verschickt. Festgehaltene Gründe, ihn nicht durchzuführen: Renderings würden nicht zu den realen Stoffen passen, aus Fotos generierte Modelle enthalten geschätzte Geometrie und eingebrannte Beleuchtung, und es handelt sich um eine andere Produktlinie.
Nur eine numerische Layout-Zeile, Kling 4. Um die Kosten für den Freisteller zu vermeiden, wurde zuerst ein reiner Prompt-Weg versucht: eine Layout-Zeile mit den vier Einstellungen als Zahlen. In einem Produktionsdurchgang wurden die Zahlen nicht befolgt. Ein serverseitiger ffmpeg-Zusammensetzungsschritt, der Standbild-Pausen anhängen sollte, verlor die Standbilder; die Standbild-Pausen wurden in den Browser verlagert.
Prompt v9. v9 führte einen Entwurf mit beschrifteten Zeilen (Scene, Layout, Rotation, Camera, Motion, Product; Layout immer gesendet; konstante Geschwindigkeit; letztes Bild gleich Bild 1; starres Produkt) mit der serverseitigen Ebene v4 zusammen, die in der Produktion aktiv gewesen war (Bild 1 bei 0° mit Front zur Kamera, starre Drehung um die Mitte der Scheibe, nie umkehren, Viertel-Timing mit der Rückansicht zur Hälfte, Schwenk zeigt nie die Rückseite, flache Scheibe, aus der nichts herausragt, Scheibe waagrecht und an ihrem Platz). Eine in der Produktion gespeicherte v4-Ebene würde die Dreh- und Bewegungssätze von v9 überschreiben, daher musste direkt nach dem Deployment eine leere Ebenenversion gespeichert werden. Ob und wann dieses Zurücksetzen erfolgte, ist nicht dokumentiert. Solange das nicht geklärt ist, ist unsicher, welche Dreh- und Bewegungssätze jede spätere Produktionsgenerierung (Abschnitte 7.3 und 7.6) tatsächlich erhielt; der Text in Anhang A ist v9, wie der Code ihn erzeugt, keine Aufzeichnung dessen, was gesendet wurde.
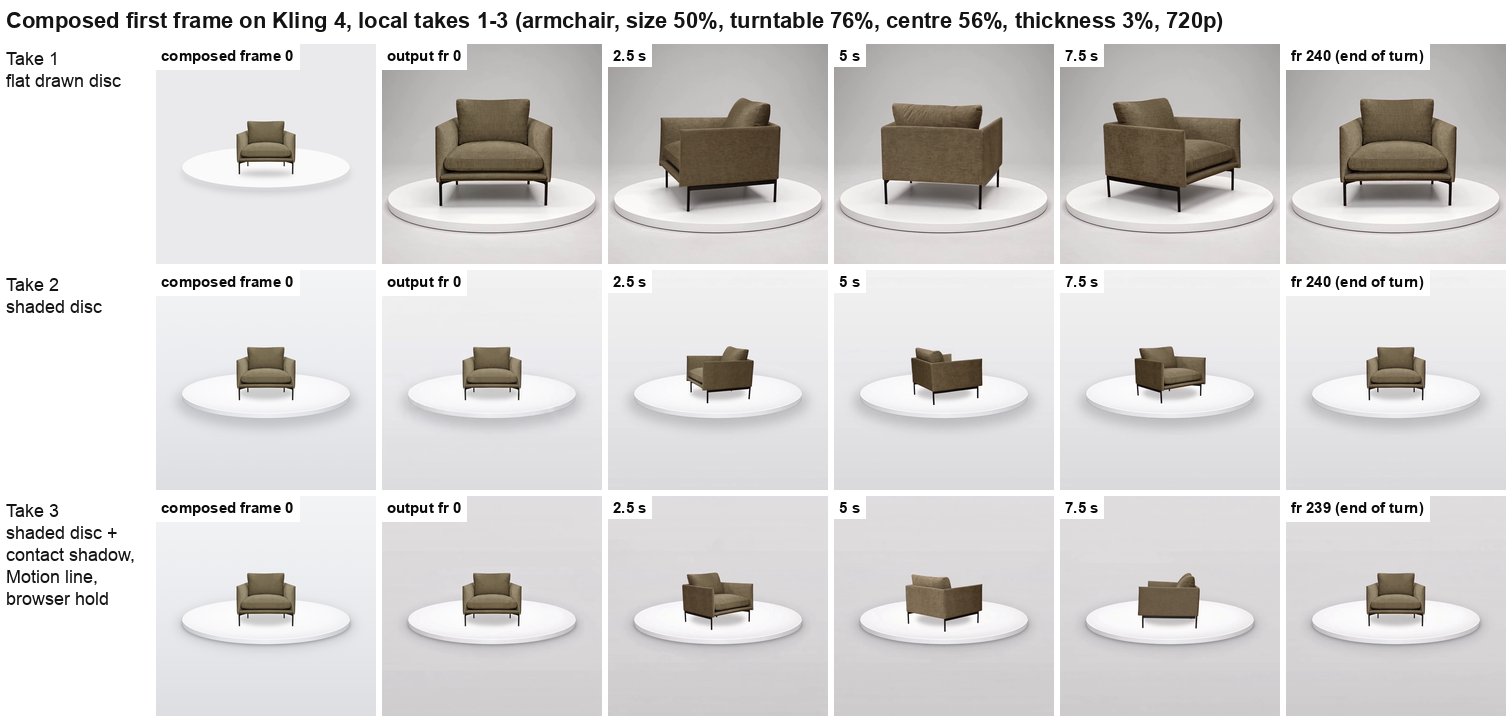
Komponiertes Startbild auf Kling 4 (lokal, drei Durchgänge). Auf einem lokalen Deployment, das die echten APIs aufruft, mit einem Element aus den drei Sesselfotos des Kunden (Front zuerst), Kling 4 Reference-to-Video 720p, 10 s, 1:1, Größe 50 %, Drehteller 76 %, Mitte 56 %, Dicke 3 %, im Uhrzeigersinn:
- Durchgang 1 (flach gezeichnete Ellipse und Schatten). Das Request-Log des Anbieters zeigte, dass das Bild als
start_image_urlnebenelementsempfangen wurde; das erste Ausgabebild war die eigene Komposition des Modells (ein großer Stuhl auf einer großen Scheibe). Die Drehung selbst war vollständig. - Durchgang 2 (ein einzelner visueller Eingriff: Scheibe als Studiofotografie neu gezeichnet, mit schattiertem Rand, beleuchteter Oberseite, dunkler werdendem Hintergrund und Schattierung der Grundfläche; gleicher Endpunkt, Prompt und gleiche Einstellungen). Die Ausgabe begann auf dem komponierten Startbild, der Sessel behielt seine Größe während der Drehung bei und endete auf der Front.
- Durchgang 3 (gebündelte Überarbeitung, drei Änderungen zugleich: ein enger Kontaktschatten, eine neue Motion-Zeile im Prompt, die ab Bild 1 konstante Geschwindigkeit verlangt, und im Browser erzeugte Standbild-Pausen). Begann auf dem komponierten Startbild, Größe beibehalten, Rückseite bei 5 s, Front am Ende, SSIM erstes/letztes Bild 0,98; Datei mit Standbildern 12,12 s (Container-Dauer), die letzten 2 s still. Das Ergebnis von Durchgang 3 lässt sich keiner einzelnen seiner drei Änderungen zuschreiben.
Durchgang 3 wurde als festgelegtes Rezept übernommen, und eine gleichmäßige Drehgeschwindigkeit wurde als Ziel fallen gelassen, da der Kunde sie nicht verlangt hatte.
Release, Produktionsclips und Feedback. Eine Durchsicht vor dem Release führte zu „Eigener Bildaufbau“ gekoppelt an Kling 4, gespeicherter Form pro Produkt, der Freisteller-Schaltfläche auf der Bühne, Kostenzeilen, die den Freisteller nennen, einer Längenangabe, die die Pause zeigt, einem Hinweis, während Standbild-Pausen hinzugefügt werden, und klareren Beschriftungen; benannte Voreinstellungen und eine Stapel-Warteschlange wurden zurückgestellt. Ein Produktionsclip verlangte gegen den Uhrzeigersinn und drehte sich im Uhrzeigersinn, daher wurde die Richtung ausgeblendet. Ein Clip mit Standbildern hörte auf zu spielen, als er im selben Player den Rohclip ersetzte; das wurde behoben. Die Detailseite erhielt eine Überlagerung mit dem tatsächlichen komponierten Startbild des Clips, die eine frühere schematische Strichzeichnung ersetzte. Vier Produktionsclips mit dem komponierten Startbild (Abschnitt 7.3) und ein Studio-Tutorial wurden an den Kunden geschickt. Die Antwort des Kunden enthielt begrenztes positives Feedback zu bestimmten Punkten (nach unserer Zusammenfassung: das Ergebnis nah an dem, was er möchte, der Tellerdurchmesser richtig, die 2-s-Pause funktioniert) neben vier Korrekturen: Der Schatten des Ecksofas war rund, statt seiner Form zu folgen; in jedem Video sollte dieselbe dünne Plattform verwendet werden; das Produkt sollte in jedem Video an derselben Bildschirmposition stehen; und der Hintergrund des Sessel-Clips sollte für die gesamte Kollektion verwendet werden. Er schickte außerdem Fotos eines zweiten Bettmodells und bat um dessen Video. Das ist keine Abnahme und betrifft nicht die späteren Clips.
Schattierung von Frame 0 und die neu erstellten Clips. Am selben Nachmittag wurde Frame 0 überarbeitet (Abschnitt 5): ein wählbarer, an den Sessel-Clip angepasster Studiohintergrund, Entfernung der gezeichneten Ellipse und ein aus dem Foto übernommener Bodenschatten. Darauf folgten sechs neu erstellte Clips mit festen Einstellungen und dem angepassten Hintergrund (Abschnitt 7.6). Der Plan hatte vier neue Clips vorgesehen (das zweite Bett, Ecksofa, Sofa und Pouf), ohne neuen Sessel-Clip, je ein Durchgang; erstellt wurden sechs: die vier geplanten, ein Sessel und ein zweiter Durchgang des Betts. Die Wiederholung des Betts folgte aus der Drift des ersten Bett-Durchgangs und änderte eine Bedingung (das Endbild); der Grund für die Neuerstellung des Sessels ist nicht dokumentiert. Der driftende Bett-Durchgang wurde generiert, aber nicht geliefert, die Auswahl zwischen Durchgängen verursachte also zusätzliche Kosten. Nach dem Bett-Paar wurde das Senden des komponierten Startbilds als Endbild bei vollen Drehungen gebaut und ausgeliefert (Abschnitt 4.4), und fünf Clips wurden mit Anleitungen zur Selbstbedienung an den Kunden geschickt. Sein Urteil steht noch aus.
3.2 Chronologie
| Datum (2026) | Phase | Art | Ergebnis |
|---|---|---|---|
| 11-05 bis 11-06 | Fünf eigene Clips des Kunden; Anforderungen R1–R6; Durchsicht der Clips und Vorbereitung der Eingaben | Kundenclips, Feedback, lokale Durchsicht | Größe und Konsistenz waren die Hauptprobleme; zwei Kling-4-Clips drehten sich bereits vollständig |
| 11-06 | Messungen an Vorlagenclips; Tests zu Interpolation und Bereichsschnitt; Prompt v1 mit Einstellung „Drehung“ | lokale Tests, ausgeliefert | Bildaufbau innerhalb eines Clips stabil; Interpolation verworfen; Schnitt erfordert echte 360° |
| 11-07 | Prompt v2–v8; Tests mit v8 und das T4b-Paar | generiert (6 Clips) | numerischer Text nicht befolgt; Zuordnung der Referenzen beeinflusste die Startpose |
| 11-09 | Kollektion erhalten und geprüft; versteckte Prompt-Ebenen v1–v4 | generiert | vier Stücke drehten sich einmal ab der Front; Bett scheiterte |
| 11-10 | Ausgangsbasis geliefert; Kundenfeedback; Mechanismusanalyse; Clip mit Referenzen aus vier Ansichten | generiert, Feedback, Analyse | Maßstab, Sprung am Ende, Verbleiben auf der Plattform angesprochen; strukturelle Drift mit generierten Ansichten |
| 11-11 | Anker-Experiment auf Kling 3.0 Omni | generiert (9 Videos) | Größe in Frame 0 mit Ankern gehalten; je Bedingung 1 von 3 umgekehrt; eingestellt |
| 11-12 | Korrektur früherer Zusagen; erneute Anfrage; numerische Layout-Zeile; Prompt v9; lokale Durchgänge 1–3; komponiertes Startbild ausgeliefert | generiert, ausgeliefert | Zahlen nicht befolgt; schattiertes komponiertes Startbild befolgt, flaches nicht |
| 11-13 morgens | Vier Produktionsclips; Tutorial verschickt; Korrekturen des Kunden | generiert, Feedback | Layout befolgt, Hintergrund 3 von 4; vier Korrekturen |
| 11-13 nachmittags | Anpassung des Hintergrunds, Entfernung der Ellipse, übernommener Schatten | ausgeliefert | in dieser Phase keine Generierung |
| 11-13 abends | Sechs neu erstellte Clips; automatisches Endbild; fünf Clips verschickt | generiert, ausgeliefert | eine Drift nur mit Startbild; Wiederholung mit Start = Ende driftete nicht; Urteil ausstehend |
4. Endgültiges Verfahren
4.1 Überblick
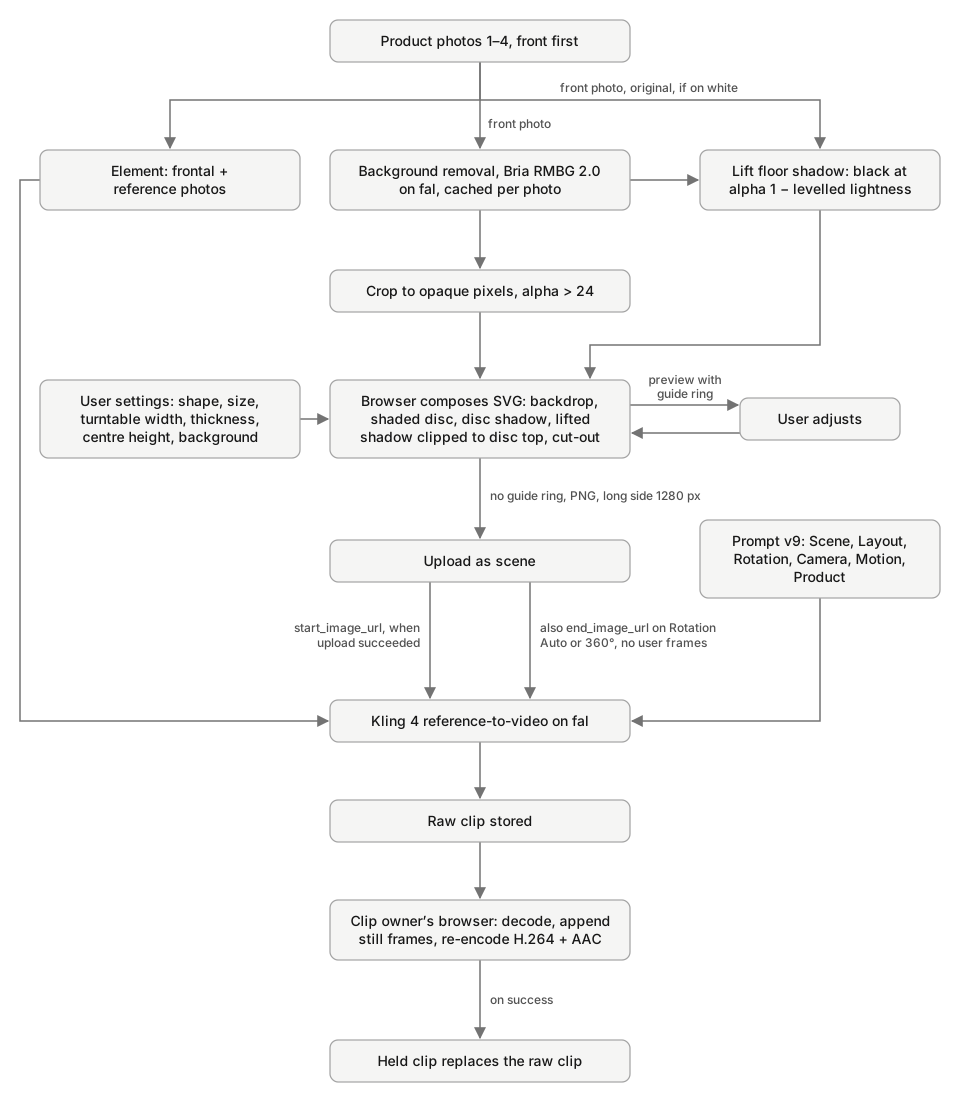
4.2 Ablauf für den Nutzer
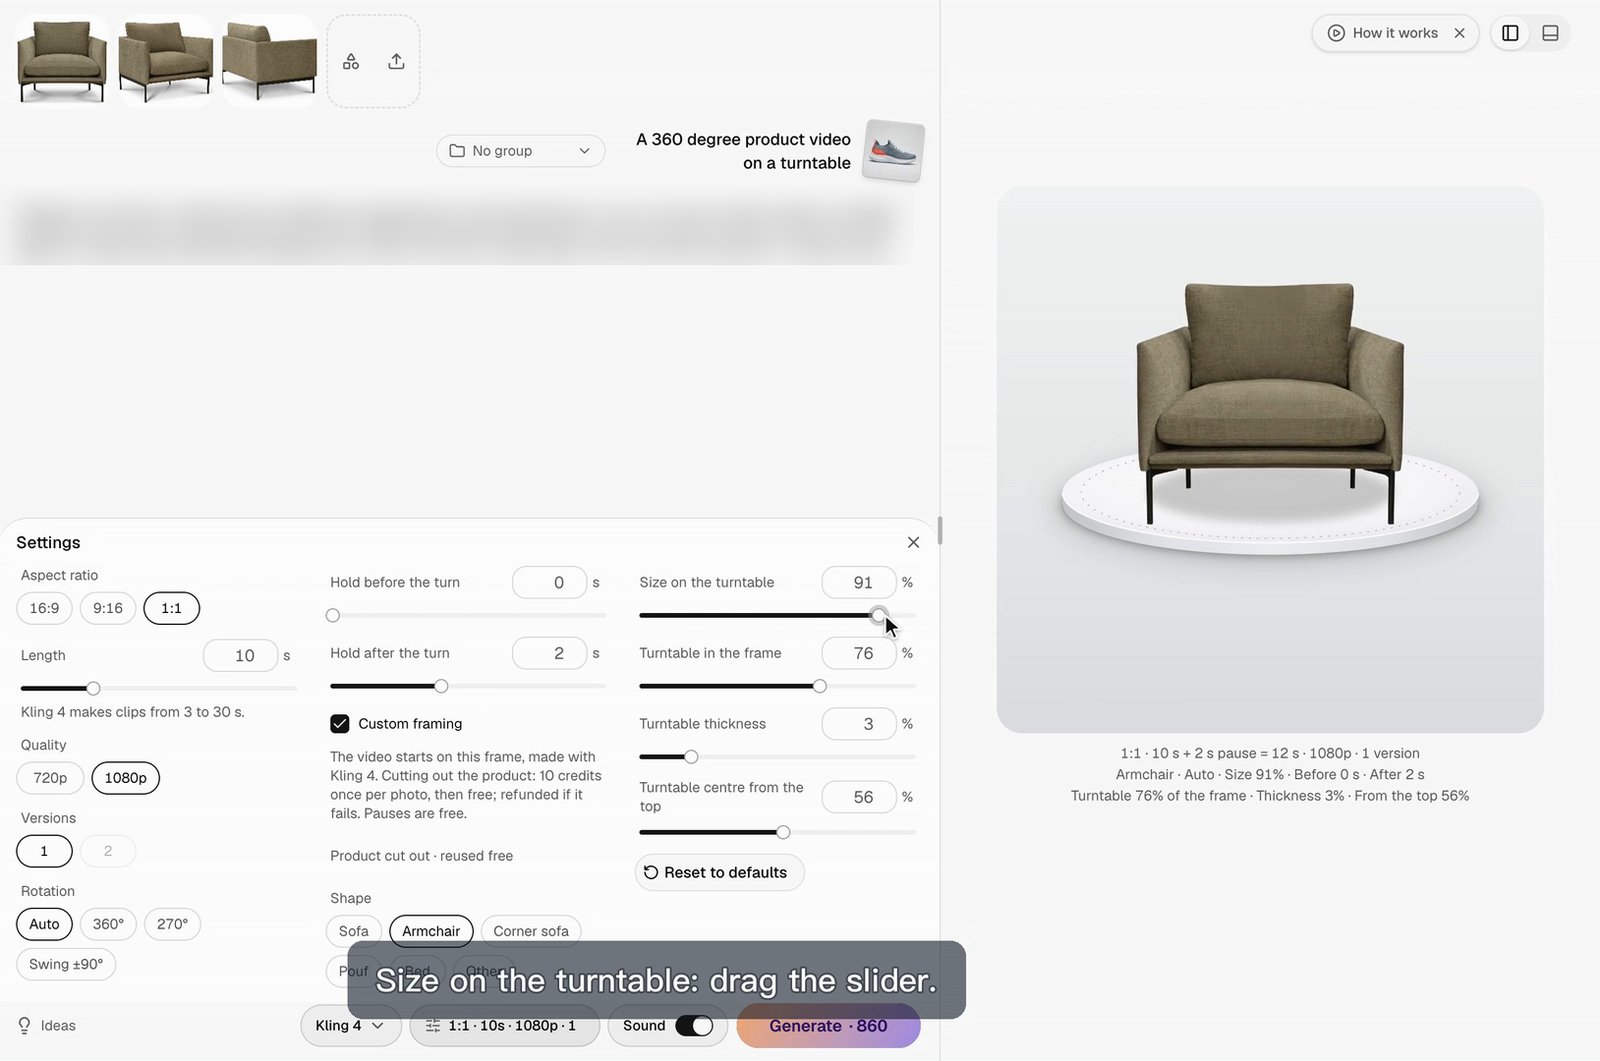
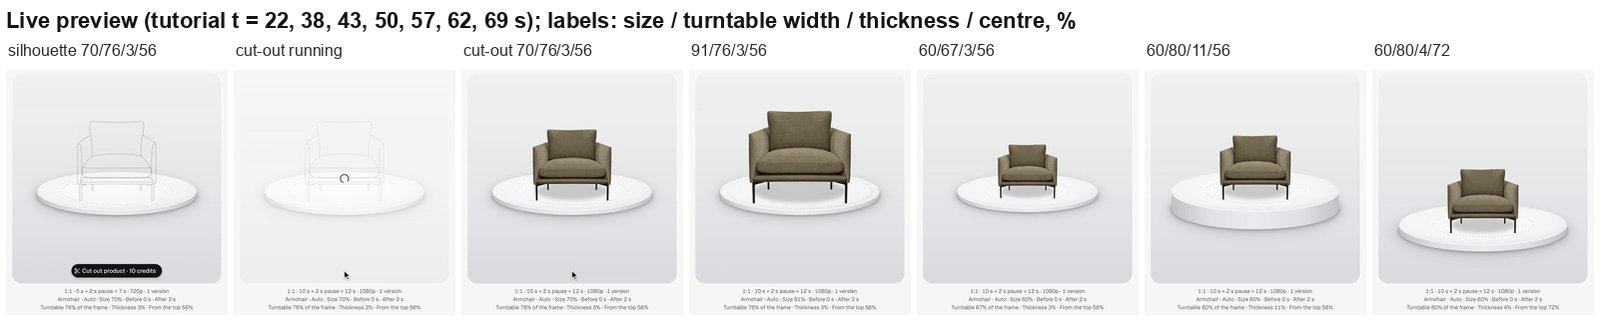
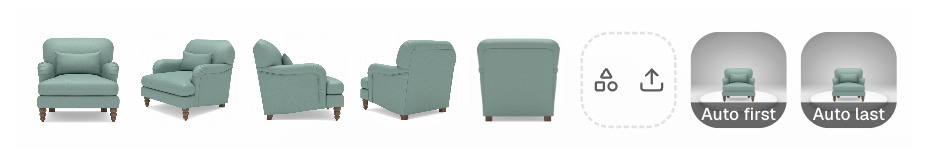
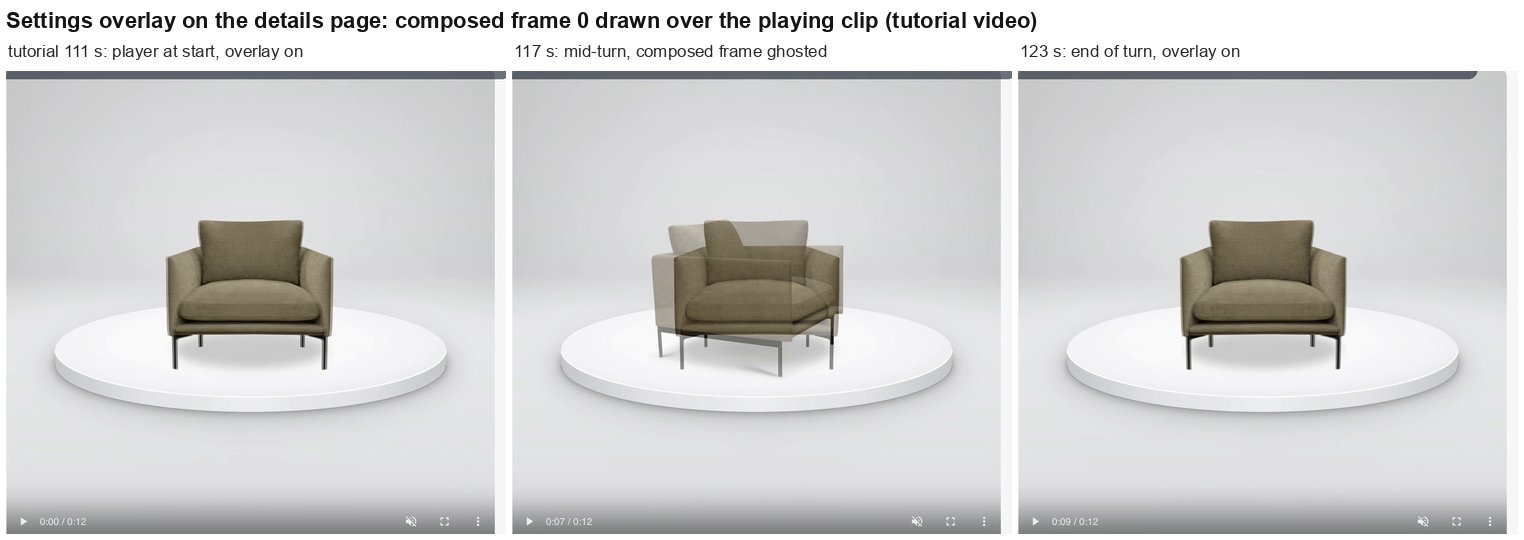
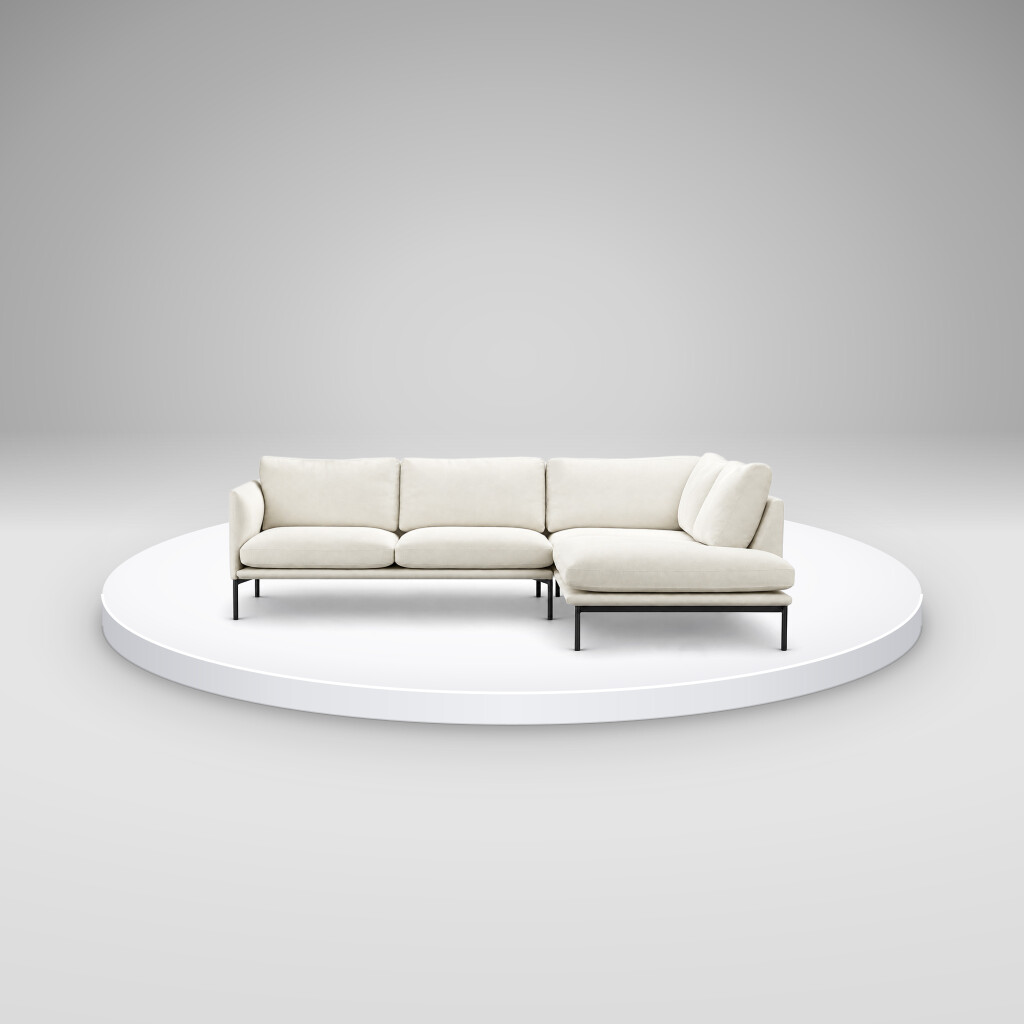
In der Drehteller-Vorlage setzt der Nutzer das Häkchen bei Eigener Bildaufbau, wodurch das Modell auf Kling 4 umgestellt wird. Die leere Bühne wird zu einer Live-Zeichnung des Drehtellers mit einer generischen Silhouette der gewählten Form. Der Nutzer startet den Freisteller (einmal pro Foto berechnet, bei Fehlschlag erstattet, danach wiederverwendet); der Freisteller ersetzt die Silhouette. Vier Schieberegler mit Zahlenfeldern ändern die Vorschau live: Größe auf dem Drehteller, Breite des Drehtellers im Bild, Dicke des Drehtellers, Höhe der Drehtellermitte; eine Auswahl „Hintergrund“ wechselt zwischen „Hell“ und „Studiograu“ (Abschnitt 5.1). Drehung und Standbild-Pausen liegen außerhalb von „Eigener Bildaufbau“ und kosten nichts. Ist „Eigener Bildaufbau“ ohne Freisteller aktiviert und hat der Nutzer weder ein eigenes erstes Bild noch eine Fortsetzung eines früheren Clips angegeben, wird die Generierung mit der Aufforderung abgelehnt, den Freisteller zu starten; mit einem eigenen ersten Bild oder einer Fortsetzung läuft sie ohne komponiertes Startbild weiter. Die Fotoreihe des Studios zeigt immer eine Kachel „Erstes Bild“ und eine Kachel „Letztes Bild“: Leer ist eine Kachel eine Upload-Schaltfläche; mit „Eigener Bildaufbau“ und einem Freisteller zeigt die Kachel „Erstes Bild“ das komponierte Startbild mit der Markierung „Auto-Start“, und bei Drehung Auto oder 360° zeigt es auch die Kachel „Letztes Bild“, markiert mit „Auto-Ende“. Ein Tippen auf eine Auto-Kachel lässt den Nutzer stattdessen ein eigenes Bild wählen. Nach der Generierung listet die Detailseite die gesendeten Einstellungen auf und bietet eine Überlagerung des tatsächlichen komponierten Startbilds auf dem Video, sodass die Überlagerung den echten Freisteller mit der Ausgabe vergleicht (Abbildung 10). Die Abbildungen 7, 8 und 10 stammen aus einem Studio-Tutorial, das aufgenommen wurde, bevor es die Auswahl „Hintergrund“ gab.
Numerische Eingabe. Bis zu einer Korrektur am Morgen, an dem die Produktionsclips geliefert wurden, begrenzte ein Zahlenfeld jeden einzelnen Tastendruck, sodass die Eingabe von „60“ bei Größe (30–100) 100 ergab. Die Produktionsclips aus Abschnitt 7.3 entstanden vor der Korrektur; ihre dokumentierten Einstellungen sind die gesendeten Werte, der Fehler könnte also das betroffen haben, was der Nutzer beabsichtigte, nicht das, was der Datensatz angibt, und ob einer ihrer Werte getippt statt per Schieberegler eingestellt wurde, ist nicht dokumentiert.
Die Einstellungen bleiben im Konto gespeichert: Die Drehteller-Parameter gelten für alle Formen gemeinsam; Größe und Standbild-Pausen werden pro Form gespeichert; die Form jedes Produkts wird pro Element gespeichert.
4.3 Komposition
- Bühne. Scheibenmitte (300, 400) in SVG-Einheiten, Radius r = 210, von 14° oberhalb betrachtet (Neigung = sin 14°, gewählt anhand der eigenen Drehteller-Clips des Modells).
- Ansicht. Bildbreite = 2r × 100 / (Drehtellerbreite %); Höhe = Breite / Seitenverhältnis; die obere Mitte der Scheibe liegt beim Prozentwert der Mittenhöhe des Bildes. Jedes Seitenverhältnis erhält eine eigene Komposition (R6).
- Scheibe. Randhöhe = Dicke % × 2r × cos 14°; schattierter Rand, beleuchtete Oberseite mit einem Glanzlicht vorn, ein Hintergrund (Hell: ein Verlauf, der zum Boden hin dunkler wird; Studiograu: Abschnitt 5.1) und der eigene Schatten der Scheibe auf dem Boden. Ursprünglich wurde unter dem Produkt zusätzlich eine weichgezeichnete Grundflächen-Ellipse als Kontaktschatten gezeichnet; sie wurde entfernt, und der Bodenschatten des Produkts wird, sofern vorhanden, nun aus seinem Foto übernommen (Abschnitt 5).
- Produktmaßstab. k = r × s / sweep (s als Bruch), wobei sweep = √((W/2)² + (D/2)²) der Abstand von der Achse zur am weitesten entfernten Ecke der Grundfläche ist und W × D die generische Grundfläche der Form (Sofa 240 × 94, Sessel 85 × 85, Ecksofa 240 × 200, Pouf 105 × 60, Bett 163 × 210, Sonstiges 100 × 60 cm). Der Freisteller wird W·k breit gezeichnet, zentriert auf der Achse, mit seiner Unterkante auf der Vorderkante der Grundfläche.
Was die Maßstabsregel leistet und was nicht. Jede Form erhält ihren eigenen Faktor k in Pixeln pro Zentimeter, die Regel steuert also die normierte Belegung durch die Grundfläche: Bei s = 100 % erreicht die am weitesten entfernte Ecke der Grundfläche beim Vorbeischwenken gerade den Scheibenrand, und zwar für jede Form. Den physischen Maßstab über Produkte hinweg bewahrt sie nicht. Eine Verdopplung von W und D lässt die gezeichnete Breite beim selben Schiebereglerwert unverändert. Bei gleichem s stehen die gezeichneten Breiten von Sessel, Pouf und Sofa im Verhältnis 297 : 365 : 391 SVG-Einheiten (1 : 1,23 : 1,32), während ihre realen Breiten 85 : 105 : 240 cm betragen (1 : 1,24 : 2,82). Proportionen zwischen Produkten (die „konsistenten Proportionen“ aus R1) bleiben daher der manuellen Wahl von s pro Form durch den Nutzer überlassen. Ein echter Katalogmaßstab würde einen gemeinsamen physischen Tellerdurchmesser oder einen gemeinsamen Faktor in Pixeln pro Zentimeter plus die realen Maße jeder SKU erfordern; Produktmaße allein, in dieselbe Normierung eingespeist, würden ihn nicht erreichen.
- Ausgabe. Das SVG wird ohne den Hilfsring geklont, serialisiert, auf ein Canvas mit 1.280 px an der langen Seite gezeichnet und als PNG exportiert. Das komponierte Startbild hat daher dieselbe Komposition wie die Vorschau, abgesehen von den UI-Hilfslinien und bis auf die Rasterung. Es wird hochgeladen und als
start_image_urlgesendet.
4.4 Wann das komponierte Startbild gesendet wird
Als Startbild. Es wird nur gesendet, wenn „Eigener Bildaufbau“ aktiviert ist, ein Freisteller vorhanden ist und der Nutzer weder ein eigenes erstes Bild noch eine Fortsetzung eines früheren Clips angegeben hat, die beide Vorrang haben. Schlagen Rendering oder Upload fehl, wird der Fehler protokolliert und die Generierung läuft ohne Startbild weiter. Eine Variante, die in diesem Fall abbricht (fail-closed), ist künftige Arbeit.
Als Endbild (nach dem Paarvergleich aus Abschnitt 7.6 hinzugefügt; laut Operator am selben Abend ausgeliefert). Dasselbe hochgeladene komponierte Startbild wird zusätzlich als end_image_url gesendet, wenn alle folgenden Bedingungen erfüllt sind: Das komponierte Startbild wird als Startbild gesendet (Bedingungen oben), der Nutzer hat kein eigenes letztes Bild gesetzt, das Modell akzeptiert ein Endbild (Kling 4 tut dies), und Drehung steht auf Auto oder 360°. Es wird nicht gesendet bei 270°, dessen Endpose vom Start abweicht, und nicht bei Schwenk ±90°, der zwar zu 0° zurückkehrt, damit aber nicht erprobt wurde. Die Auslieferung ist eine technische Entscheidung, kein Beleg dafür, dass das Endbild eine Drift des Bildaufbaus verhindert. Eine Generierung über diesen automatischen Pfad ist festgehalten: ein Sessel-Clip (Abschnitt 7.6), der den Bildaufbau behielt, während sein Zwilling nur mit Startbild heranfuhr. Die automatisierten Prüfungen sind zweierlei: für die Benutzeroberfläche statische Prüfungen, dass die Bedingungen wie beschrieben formuliert sind, die weder die Zustände der Kacheln rendern noch den Upload- und Request-Pfad ausführen; für den Request-Builder Unit-Tests, die ihn ausführen und prüfen, dass ein Endbild bei Kling 4 und beiden Stufen von Kling 3.0 Omni als end_image_url weitergegeben wird und nie bei Modellen ohne Endbild. Die Auto-Kacheln wurden während der Entwicklung nicht in einer laufenden Oberfläche gesehen, weil sich in der lokalen Umgebung kein Freisteller erstellen ließ.
4.5 Parameter
| Einstellung | Bereich | Standard | Geltungsbereich |
|---|---|---|---|
| Größe auf dem Drehteller (am weitesten entfernter Punkt der Grundfläche / Scheibenradius) | 30–100 % | 70 % | pro Form |
| Breite des Drehtellers im Bild | 40–95 % | 76 % | alle Formen |
| Dicke des Drehtellers (Rand / Durchmesser) | 1–12 % | 3 % | alle Formen |
| Drehtellermitte von oben | 30–80 % | 56 % | alle Formen |
| Hintergrund | Hell, Studiograu | Hell | alle Formen |
| Drehung | Auto, 360°, 270°, Schwenk ±90° | Auto | pro Clip |
| Pause vor / nach der Drehung | 0–5 s, Schritte von 0,1 s | 0 s / 2 s | pro Form |
| Richtung | nur im Uhrzeigersinn | im Uhrzeigersinn | — |
Werte außerhalb des Bereichs weist der Server zurück, statt sie zu begrenzen. „Gegen den Uhrzeigersinn“ wurde ausgeblendet, nachdem Kling 4 es in einem Produktionsclip ignoriert hatte; die Richtung existiert nur als Prompt-Satz.
4.6 Prompt
Der Server erzeugt pro Gruppe eine beschriftete Zeile: Scene (die Worte des Nutzers), Layout (die vier Einstellungen in Worten, nur mit „Eigener Bildaufbau“), Rotation, Camera, Motion, Product. Vollständiger Text in Anhang A. Zwei Implementierungsdetails sind wichtig:
- Ausweichregel bei Überlänge. Überschreitet der Prompt das Limit eines Modells, werden Kandidaten versucht, bei denen Zeilen in fester Reihenfolge wegfallen: zusätzlicher Nutzertext, Product, Motion, Camera, Rotation, dann Layout; als letzter Ausweg bleibt die Scene-Zeile allein. Layout und Rotation werden daher normalerweise, aber nicht immer gesendet.
- Das Unterdrücken von Vorgaben ist Schlüsselwortabgleich. Die Zeilen Camera und Motion sowie der Standardtext der Product-Zeile entfallen, wenn die eigenen Worte des Nutzers auf Themenmuster passen (z. B. „camera“, „zoom“, „orbit“); bei ausgeschaltetem Ton enthält die Product-Zeile weiterhin den Stille-Satz („The video is silent.“). Das ist keine semantische Erkennung von Widersprüchen: Eine Zeile entfällt auch bei Worten, die mit ihr übereinstimmen („keep the camera fixed“), und manche widersprechende Formulierung wird nicht erkannt.
Die Layout-Zeile gibt in Worten wieder, was das komponierte Startbild zeigt. In früheren Tests wurde numerischer Layout-Text allein nicht befolgt (Abschnitt 3.1), daher ist das Bild als Träger des Layouts vorgesehen.
4.7 Standbild-Pausen
Standbild-Pausen werden nicht vom Modell angefordert. Der Rohclip wird im Browser mit WebCodecs decodiert; der Browser schreibt Kopien des ersten decodierten Bildes für die Pause davor, den decodierten Clip und dann Kopien des letzten decodierten Bildes für die Pause danach; er verschiebt den Ton entsprechend, füllt die Pausen mit Stille, codiert neu in H.264 + AAC und lädt das Ergebnis hoch, das den Rohclip einmalig ersetzt. Decodiert wird statt einer MP4-Edit-List, weil die Clips B-Frames verwenden und Browser Verweildauern aus Edit-Lists nicht berücksichtigen. Ein serverseitiger Weg über einen ffmpeg-Zusammensetzungsdienst bleibt deaktiviert, nachdem er die Standbilder verloren hatte.
Eigenschaften und Grenzen:
- Bedingt. Der Vorgang läuft im Browser des Clip-Eigentümers, wenn der Clip angezeigt wird. Schlagen Abruf, Decodierung, Codierung oder Upload fehl, bleibt der Rohclip unverändert, und der Versuch wird bei einem späteren Besuch wiederholt. Er hängt von der Codec-Unterstützung des Browsers und den Ressourcen des Geräts ab.
- Auf Bilder quantisierte Standbildkopien. Jede Standbildkopie erhält eine volle Bilddauer, und Kopien werden hinzugefügt, solange ihre Startzeit unter dem angeforderten Ende liegt, sodass sich die nominalen Dauern der wiederholten Samples zu den angeforderten Sekunden aufaddieren, aufgerundet auf ganze Bilder: 2 s bei 24 fps sind genau 48 Bilder, 0,1 s ergeben dagegen 3 Kopien mit einer nominalen Ausdehnung von 0,125 s. Die übrige Zeitleiste folgt dieser Rundung nicht auf dieselbe Weise. Bei einer vorangestellten Pause werden die bewegten Bilder und der Ton um den angeforderten Wert (0,1 s) verschoben, nicht um den gerundeten, sodass sich das nominale Intervall der letzten Standbildkopie (0,083–0,125 s) mit dem ersten bewegten Bild (ab 0,1 s) überschneidet. Bei einer nachgestellten Pause beginnen die Kopien am Ende des letzten bewegten Bildes, das Ende, bis zu dem der Ton mit Stille aufgefüllt wird, wird jedoch um den angeforderten Wert vorgerückt. Bei Pausenwerten aus ganzen Bildern fallen beide zusammen; bei Bruchteil-Pausen wurden die Zeitstempel der decodierten Ausgabe und die A/V-Synchronität nicht gemessen.
- Nicht verlustfrei. Der gesamte Clip wird neu codiert, daher sind weder der bewegte Abschnitt noch die Standbilder pixelidentisch mit dem decodierten Rohclip.
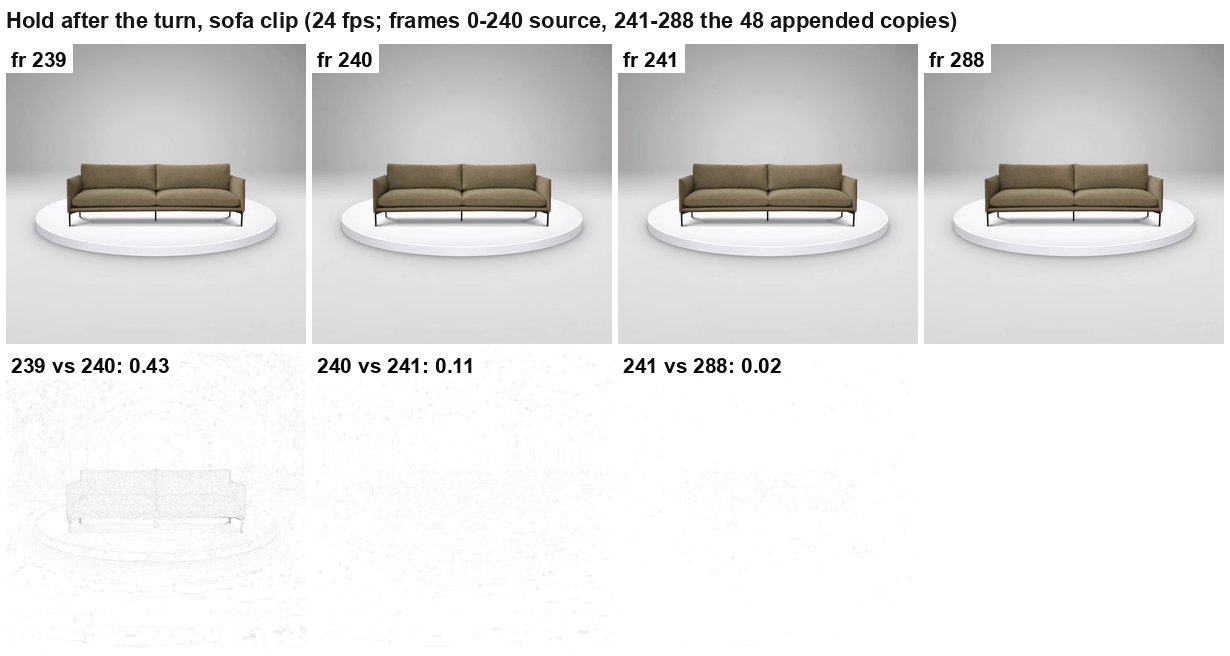
Gemessen an heruntergeladenen Kopien mit Standbildern von vier gelieferten, neu erstellten Clips (Abschnitt 7.6). Jede hat 289 Videobilder bei 24 fps, einen Videostream von 12,041667 s und eine Container-Dauer von 12,120816 s (der AAC-Tonstream ist länger). Bei einem 10-s-Rohclip mit 241 Bildern, wie ihn heruntergeladene 10-s-Kling-4-Clips haben, sind die Bilder 0–240 decodierte Quellbilder und die Bilder 241–288 die 48 Kopien (2 s) ab 10,041667 s; Bild 240 bei 10,000 s ist das letzte Quellsample. Die Rohdateien wurden nicht aufbewahrt, daher ist diese Grenze aus den Bildzahlen und dem Verfahren erschlossen, nicht aus Rohmaterial abgelesen. Der Encoder setzt alle 48 Bilder einen Keyframe (0, 48, …, 240). Graustufen (Rec.-601-Luma), volle 1440 px: Gegenüber der ersten Kopie (Bild 241) weicht jedes spätere Pausenbild um eine mittlere absolute Differenz pro Bild von höchstens 0,010–0,022 Graustufen ab (der Bereich bezieht sich auf die vier Clips) und um ein Maximum pro Pixel von 5–11; gegenüber Bild 240 beträgt der größte Mittelwert pro Bild 0,10–0,12 und das Maximum pro Pixel 12–50 (50 beim Ecksofa), weil dieser Vergleich den Schritt vom letzten Quellbild zur ersten neu codierten Kopie einschließt. Im Sofa-Clip betrug die mittlere absolute Graudifferenz von Bild 239 zu 240 0,43, von 240 zu 241 0,11 und von 241 zu 288 0,02. Die Pause ist daher visuell still, aber nicht pixelidentisch; der Rest pro Pixel ist Codierungsrauschen, das sich an Kanten konzentriert.
Nicht getestet: Bruchteil-Pausen, Pausen vor der Drehung, Tonsynchronität in Clips mit Standbildern und Ton sowie unterbrochene Verarbeitung.
4.8 Kosten pro Clip
| Schritt | Listenpreis des Anbieters (abgerufen am 2026-11-13) | Dem Nutzer berechnet |
|---|---|---|
| Freisteller (Bria RMBG 2.0) [21] | $0.018 pro Bild | eine feste Credit-Gebühr, bei Fehlschlag erstattet, wiederverwendet |
| Kling 4, 720p [19] | $0.157 / s | Standard-Credit-Regel |
| Kling 4, 1080p [19] | $0.235 / s | Standard-Credit-Regel |
| Komposition und Standbild-Pausen | $0 (Browser) | kostenlos |
Das sind Anbieterpreise, keine Endkunden-Creditpreise, und sie enthalten keine Wiederholungen, keine Auswahl zwischen Durchgängen und keine Arbeitszeit des Operators.
5. Schattierung von Frame 0: Hintergrund und Produktschatten
Nach dem Feedback des Kunden zu den vier Produktionsclips wurde Frame 0 auf drei Arten geändert: ein wählbarer Studiohintergrund, die Entfernung des gezeichneten Schattens unter dem Produkt und ein aus dem eigenen Foto des Produkts übernommener Bodenschatten. Alle drei ändern nur das komponierte Startbild; Prompt v9 und der Request bleiben unverändert. Als die Änderungen vorgenommen wurden, hatte noch keine Generierung eine davon verwendet. Die sechs neu erstellten Clips aus Abschnitt 7.6 verwendeten dann den Hintergrund „Studiograu“ ohne gezeichnete Ellipse; ob ihr Frame 0 auch den übernommenen Schatten enthielt, ist nicht dokumentiert. Ihre Beobachtungen sind in den Abschnitten 5.1 und 5.7 ergänzt; im Übrigen beschreibt dieser Abschnitt Mechanismen und ihre Fehlerarten, kein beobachtetes Modellverhalten.
5.1 Hintergrund
Alle vier Produktionsclips erhielten denselben gezeichneten hellen Hintergrund (Pixelwerte in Frame 0 oben, in der Mitte und unten 243 / 234 / 221). Das Modell behielt ihn in den Clips von Ecksofa, Sofa und Pouf bei (erstes Ausgabebild 244 / 234 / 222) und ersetzte ihn im Sessel-Clip ab dem ersten Bild durch ein dunkleres graues Studio (Wand etwa 150 in den Ecken, etwa 200 hinter dem Produkt, Boden etwa 222). Der Kunde bat daraufhin um den Hintergrund des Sessel-Clips für die gesamte Kollektion. Da dieser Hintergrund in einem Durchgang die eigene Wahl des Modells gewesen war, reproduzierte ihn keine Einstellung. „Eigener Bildaufbau“ bietet nun eine Auswahl „Hintergrund“, Hell (die bisherige Zeichnung, Standard) oder Studiograu, die zusammen mit den Drehteller-Einstellungen im Konto gespeichert wird. Studiograu besteht aus einem radialen Wandverlauf, einem flacheren radialen Bodenverlauf und einer geradlinigen Überblendung dazwischen, angepasst an das erste Bild des Sessel-Clips unter Ausschluss von Produkt und Teller; die Anpassung wird intern mit einem mittleren Fehler von 1,7 Graustufen (0–255) angegeben, wie in Chrome gerendert (1,5 für das angepasste Modell vor dem Rendern). Das Protokoll der Chrome-Messung (Kanalumrechnung, Maske, Auflösung, Browserversion) wurde nicht dokumentiert, und sie wurde nicht unabhängig reproduziert. Eine unabhängige Prüfung an gespeicherten 720-px-Bildern (Referenzbild, angepasstes Modell, Maske und das SVG von Frame 0), mit der Maske bei > 127 binarisiert (73,4 % der Pixel behalten) und der maskierten mittleren absoluten Graudifferenz gegenüber der Referenz, ergibt 1,63 für das Bild des angepassten Modells (bereits in Graustufen) und für das mit librsvg 2.58.4 bei 720 × 720 gerenderte SVG von Frame 0 1,48 mit einer Rec.-601-Luma-Umrechnung bzw. 1,43 mit Rec.-709-Gewichten auf den codierten Werten. Keines dieser Protokolle ist maßgeblich, und keines bestätigt oder widerlegt den Chrome-Wert. Das SVG-Rendering enthält außerdem die Silhouettenkontur der Vorschau ohne Hilfslinien, die teilweise innerhalb der behaltenen Maske liegt. In der maskierten Fehlerkarte konzentrieren sich die Fehler im Überblendungsband zwischen Wand und Boden und an der äußeren Wand. Die Anpassung soll den gewünschten Look in Frame 0 reproduzieren.
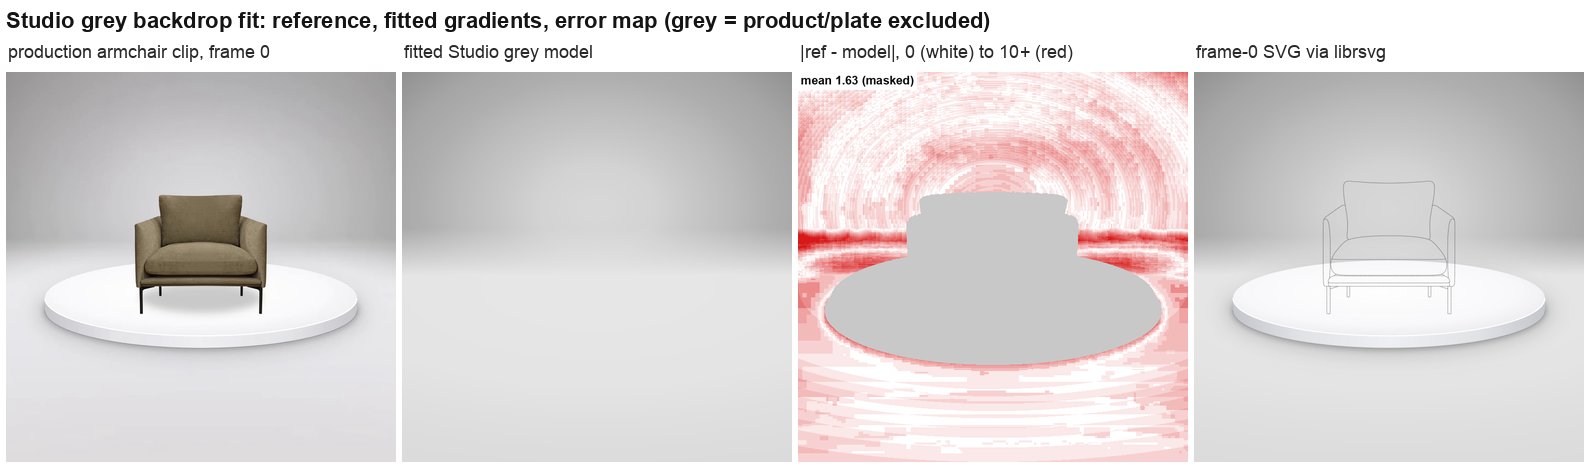
Angepasste Geometrie. Die Pixel von Frame 0 des Sessel-Clips wurden mit maskiertem Produkt und Teller durch zwei radiale Verläufe und eine geradlinige Überblendung angepasst. Die Positionen beziehen sich auf die Hinterkante des Tellers (y = cy − r · tilt), sodass der Hintergrund Größe und Höhe des Tellers folgt; bei Drehteller 80 % und Mitte 58 % in 1:1 liegt die Hinterkante bei etwa 48 % der Bildhöhe, wie im Sessel-Clip. Der Wandverlauf ist 0,133 h über der Hinterkante zentriert (bei diesen Einstellungen 35 % von oben), mit einem Ellipsenparameter von 0,40 w × 0,30 h (der Verlaufsradius ist das 1,71-Fache davon, sodass der letzte Farbstopp etwa in den Ecken liegt) und den Graustopps 216, 215, 211, 199, 188, 175, 166, 145. Der Bodenverlauf ist 0,067 h unter der Hinterkante zentriert (55 %), 0,80 w × 0,30 h (×1,62), Stopps 231 → 219. Die Wand wird über dem Boden durch eine geradlinige vertikale Überblendung von 0,063 h über bis 0,037 h unter der Hinterkante maskiert (42 % → 52 %). Frühere, von Hand erstellte Versionen, ein geschätzter vertikaler Verlauf und eine gebogene, weichgezeichnete Bodenlinie, wurden nach Augenmaß als falsch beurteilt, bevor die Anpassung gemessen wurde (Angabe des Operators; diese Versionen wurden nicht aufbewahrt).
Erhalt des Hintergrunds, zwei getrennte Gruppen. Heller Hintergrund, die vier Produktionsclips aus Abschnitt 7.3: in 3 von 4 erhalten (siehe oben). Studiograu, die sechs neu erstellten Clips aus Abschnitt 7.6 (ein anderer Hintergrund, andere Einstellungen, eine andere Referenz): Der Operator berichtet in der Ausgabe aller sechs ein graues Studio. Für diesen Bericht wurde ein graues Studio in den fünf heruntergeladenen Clips gesehen, die sich über den Namen oder den Inhalt einer Generierung zuordnen ließen (Sofa, Pouf, Ecksofa und beide Bett-Clips); keine heruntergeladene Datei ließ sich dem neu erstellten Sessel-Clip zuordnen, daher beruht dessen Erhalt allein auf dem Bericht des Operators. Der Operator verglich die Graustufen der Ausgabe mit dem Sessel-Clip, an den der Hintergrund angepasst wurde: Wandecke 147–150 gegenüber 150, Wandmitte 204–206 gegenüber 208, Boden 229 gegenüber 231 sowie 220–221 gegenüber 220 (welche Clips jeder Bereich abdeckt und die Messpunkte sind Angaben des Operators; Messdateien nicht verfügbar). Eine Stichprobe für diesen Bericht an den decodierten ersten Bildern der heruntergeladenen Kopien mit Standbildern (obere Ecken und eine untere Ecke, Quadrate von 4 %, Graustufen) ergab obere Ecken 147–149 und untere Ecke 218–220 für Sofa, Pouf, Ecksofa und das Bett mit Start = Ende, gegenüber 151–154 und 221 für eine heruntergeladene Kopie, die vermutlich, aber nicht nachweislich der Sessel-Produktionsclip ist. Der Erhalt in der zweiten Gruppe ist daher in 6 von 6 vom Operator berichtet, für diesen Bericht in den 5 zuordenbaren heruntergeladenen Clips gesehen und an den gemessenen Punkten in 4 davon zahlenmäßig nah; die beiden Gruppen werden nicht zusammengefasst, und Hell gegenüber Studiograu wurde nicht unter gleichen Bedingungen verglichen (Abschnitt 11, Ablation 9).
5.2 Der Bodenschatten des Produkts: Problem
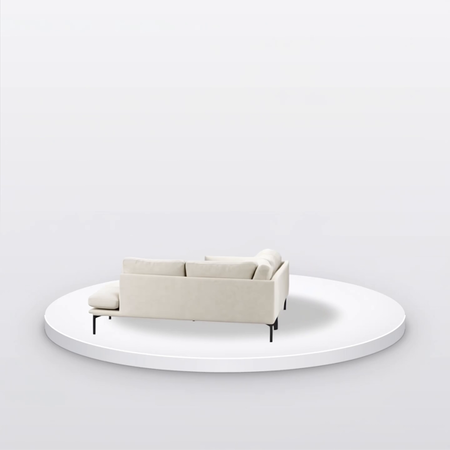
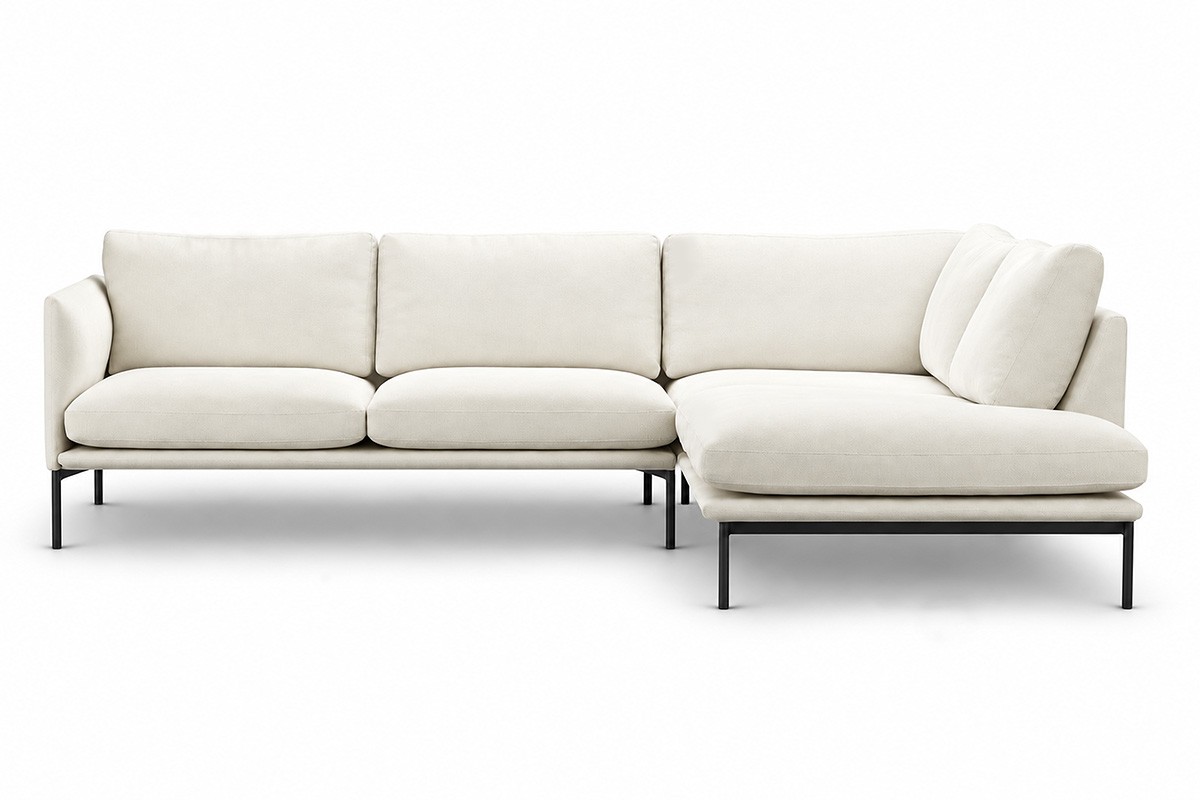
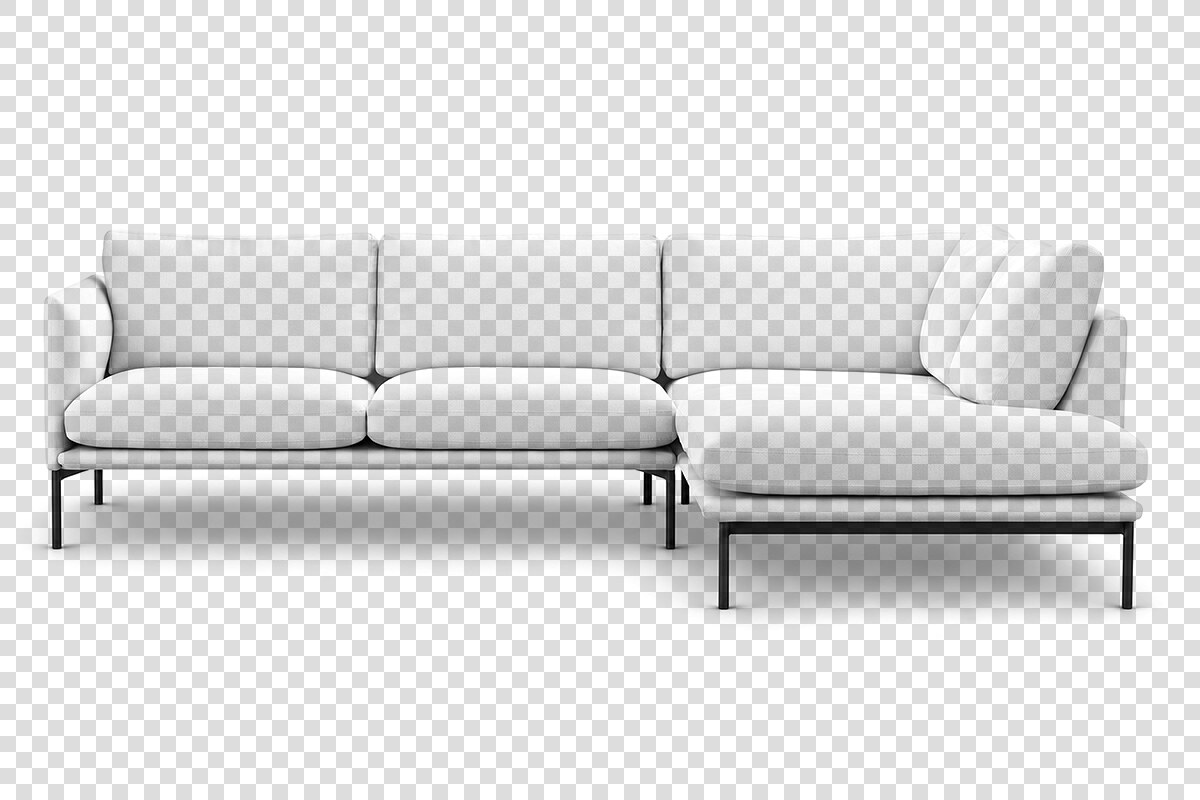
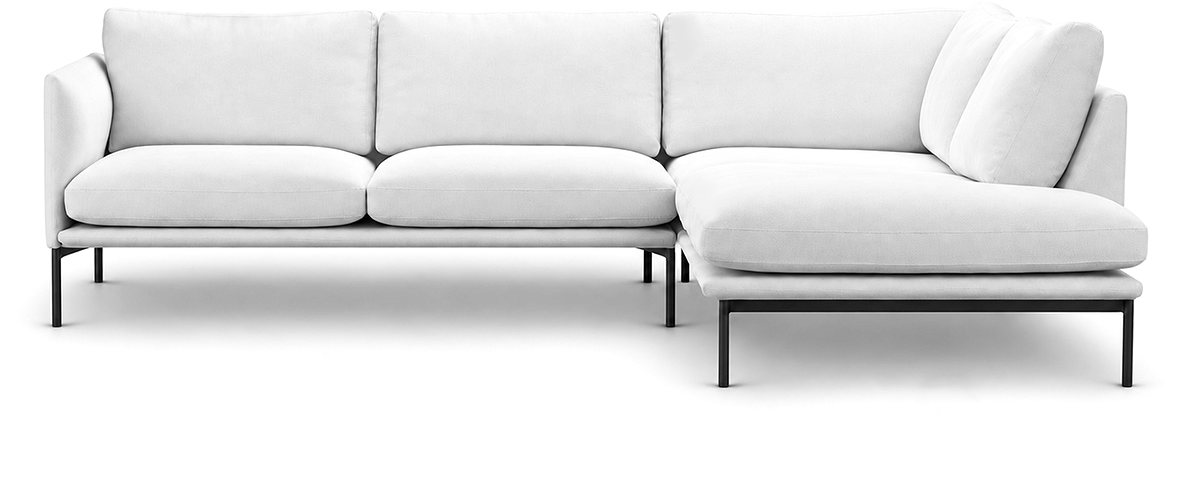
Ein Freisteller entfernt den Hintergrund zusammen mit dem Bodenschatten, den ein Katalogfoto auf weißem Hintergrund enthält (Abbildung 15 zeigt einen solchen Schatten unter Sitzfläche und Récamiere). Ursprünglich glich Frame 0 dies mit einer gezeichneten Grundflächen-Ellipse aus: 20 % Schwarz, weichgezeichnet, mit den Halbachsen 0,92 × W/2 × k und 0,92 × D/2 × k × tilt aus der generischen Grundfläche der Form (Abschnitt 4.3). Beim Sessel, beim Sofa und beim Pouf lag die Ellipse größtenteils unter dem Möbelstück. Beim Ecksofa (generische Grundfläche 240 × 200 cm) war sie ein gefülltes Oval, abgeleitet aus einer nahezu quadratischen Grundfläche (im Bildraum beträgt ihr Achsenverhältnis (200/240) × sin 14° ≈ 0,20, sie ist auf dem Bildschirm also nicht rund), während das Produkt L-förmig ist, sodass ein großer Teil davon in der leeren Ecke des L lag (nach unserer internen Beschreibung etwa die Hälfte). Der Kunde meldete, dass der Schatten rund sei, statt der Form des Ecksofas zu folgen, und im Produktionsclip des Ecksofas ist während der Drehung ein breiter grauer Fleck auf dem Teller zu sehen (Abbildung 13).
5.3 Alternativen, die nicht funktionierten
| Alternative | Was versucht wurde | Befund | Ergebnis |
|---|---|---|---|
| Gezeichnete Grundflächen-Ellipse | der ausgelieferte Frame 0 der vier Produktionsclips | grauer Fleck auf dem Teller während der Drehung des Ecksofas, vereinbar mit einem Fortbestehen des gezeichneten Grundflächenschattens (Abbildung 13); Beanstandung des Kunden | entfernt |
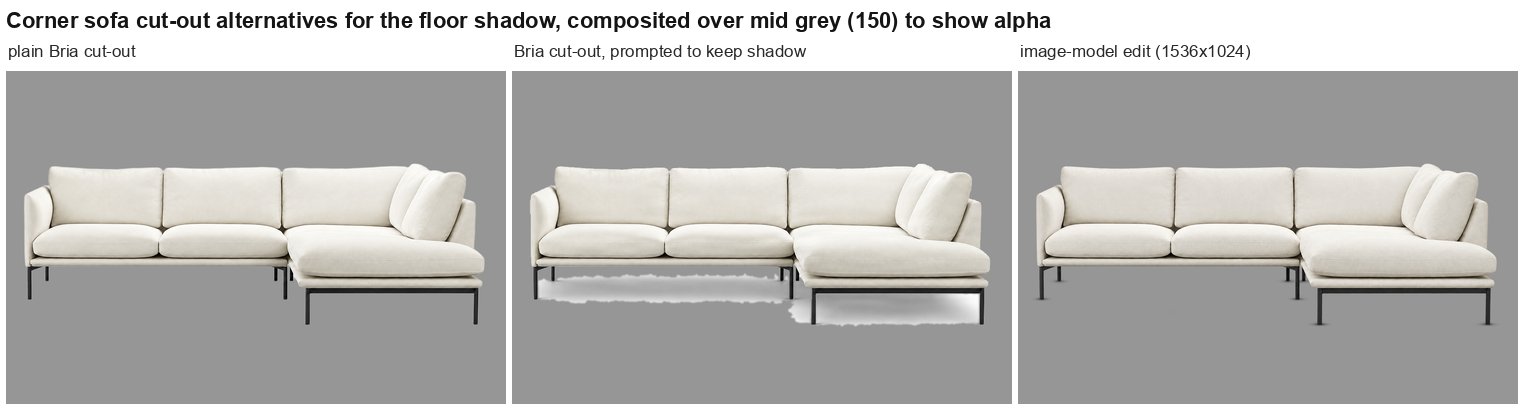
| Freisteller mit Prompt, den Schatten zu erhalten | Bria-Freisteller mit einem Prompt, der verlangt, den Schatten zu erhalten (genauer Wortlaut nicht festgehalten), fünf Produktfotos | der Boden unter jedem Möbelstück kam als deckende, fast weiße Pixel statt als halbtransparenter Schatten zurück (nach Sichtprüfung): beim Ecksofa stieg der Anteil fast deckender Pixel (Alpha ≥ 95 %) von 29,1 % der Bildfläche beim einfachen Freisteller auf 35,6 %, während Pixel mit mittlerem Alpha (5–95 %) 1,6 % ausmachten (für diesen Bericht an den gespeicherten PNGs gemessen; diese Anteile allein sagen nicht, ob die mittleren Pixel Bodenschatten oder Segmentierungskante sind) | nicht verwendet |
| Bearbeitung durch ein Bildmodell zu einem transparenten PNG mit halbtransparentem Schatten | das Ecksofa-Foto, bearbeitet von einem universellen Bildgenerierungsmodell | der Schatten ging bis auf kleine Spuren unter den Fußspitzen verloren (nach Sichtprüfung; Pixel mit mittlerem Alpha 0,7 % der Bildfläche gegenüber 0,8 % beim einfachen Freisteller); das Bild wurde aus einem Foto mit 1200 × 800 in 1536 × 1024 neu generiert, sodass die pixelgenaue Entsprechung zum Foto und damit die Treue zum Produkt nicht gewährleistet ist | nicht verwendet |
| Kein Produktschatten | Frame 0 mit entfernter Ellipse und nichts an ihrer Stelle (innerhalb einer Stunde abgelöst) | keiner: Daraus wurde kein Clip generiert. Die Befürchtung war, dass das Modell ohne Schatten in Frame 0 oder in den Referenzfotos möglicherweise keinen wirft; das ist eine Hypothese, nicht getestet. In den Produktionsclips, in denen die Ellipse in Frame 0 unter Sessel, Sofa und Pouf verborgen war, warf das Modell bei deren Drehung einen Schatten | abgelöst |
5.4 Methode: der aus dem Foto übernommene Schatten
Die Katalogfotos haben einen weißen Hintergrund, daher entspricht außerhalb des Produkts die Dunkelheit eines Pixels näherungsweise der Stärke des Schattens. Die Methode nutzt diese Dunkelheit direkt. Sie verwendet kein KI-Modell, verursacht keine Kosten über den bereits erstellten Freisteller hinaus und lässt das Freisteller-Asset selbst unverändert (es wird wie zuvor über die Ebene gezeichnet).
- Gleiche Bildfläche. Der Freistellungsdienst liefert einen Freisteller der vollständigen Bildfläche des Fotos, daher ist zu erwarten, dass Originalfoto und Freisteller Pixel für Pixel übereinstimmen. Geprüft werden nur gleiche Abmessungen; die Registrierung wird nicht verifiziert. Der Browser lädt sowohl das Originalfoto als auch den Freisteller, auch bei früher erstellten Freistellern.
- Bereich. Der Produktrahmen ist der deckende Begrenzungsrahmen des Freistellers (Alpha > 24, wie beim Zuschneiden). Der Bereich ist dieser Rahmen, auf jeder Seite um 5 % seiner Breite verbreitert und nach unten um 25 % seiner Höhe verlängert, auf das Foto beschnitten; er beginnt an der Oberkante des Produkts.
- Stärke. Für jedes Pixel im Bereich gilt die Helligkeit L = 0,2126 R + 0,7152 G + 0,0722 B auf den 8-Bit-sRGB-Werten. Das Foto wird so angehoben, dass L ≥ 250 weiß wird: ℓ = min(255, 255 · L / 250). Die Schattenebene ist schwarz mit Alpha a = 1 − ℓ / 255 (gespeichert als 255 − ℓ, gerundet).
- Compositing. In Frame 0 wird die Ebene nach der Scheibe und vor dem Freisteller gezeichnet, zusammen mit dem Freisteller skaliert und platziert (derselbe Faktor Pixel pro Fotopixel) und auf die Ellipse der Scheibenoberseite beschnitten. Danach wird der Freisteller darübergezeichnet.
In welchem Sinn dies eine Multiplizieren-Überblendung ist. Die Äquivalenz gilt für die Schattenebene allein, über einem deckenden Teller, unter folgenden Bedingungen:
- Transmission. Unter Vernachlässigung der Quantisierung beträgt die Transmission der Ebene q = min(1, L / 250), wobei L = 0,2126 R′ + 0,7152 G′ + 0,0722 B′ die kodierten 8-Bit-sRGB-Werte R′, G′, B′ des Fotos verwendet. L ist daher ein gewichtetes Mittel gammakodierter Werte (lumaähnlich), keine Luminanz in linearem Licht.
- Quantisiertes Alpha. Das gespeicherte Alpha ist A = round(255 · (1 − q)), die tatsächlich angewandte Transmission also q₈ = 1 − A / 255.
- Deckender Teller. Schwarz mit Alpha A / 255, im Modus source-over auf ein deckendes Tellerpixel P gezeichnet, ergibt (1 − A / 255) · P = q₈ · P, vor jeder späteren Abtastung und Rundung. Das ist genau die Multiplikation mit einem neutralgrauen Bild des Werts 255 · q₈, in den kodierten Werten, mit denen der Compositor arbeitet (das standardmäßige Compositing von Canvas 2D und SVG im Browser arbeitet auf sRGB-kodierten Werten).
- Graues gegenüber farbigem Foto. Es entspricht dem Multiplizieren des angehobenen Farbfotos auf den Teller nur dort, wo alle drei angehobenen Kanäle dieses Fotos gleich dem Skalar q sind, etwa bei neutralgrauen oder auf Weiß beschnittenen Pixeln. Bei farbigen Pixeln, etwa einem getönten Schatten oder dem Bezug, ist es keine RGB-Multiplikation des Fotos.
- Was es nicht ist. Es ist weder eine Multiplikation mit dem ursprünglichen, nicht angehobenen Foto noch ein physikalisches Dämpfungsmodell in linearem Licht. Ein Vergleich mit einer anderen Multiplizieren-Implementierung ist nur bei gleichem Arbeitsfarbraum, gleicher Abdeckung, gleichem Beschnitt und gleicher Abtastung ein Vergleich unter gleichen Bedingungen.
Das endgültige Composite ist eine andere Sache. Frame 0 zeichnet danach den Freisteller über die Ebene. Mit dem Freisteller-Alpha m, der nicht vormultiplizierten Freistellerfarbe F und dem Ergebnis der Ebene q₈ · P darunter ist ein Pixel von Frame 0 C = m · F + (1 − m) · q₈ · P. Wo m = 1 ist, verdeckt der Freisteller die Ebene vollständig, vollständig deckende Freistellerpixel bleiben also erhalten. Wo 0 < m < 1 ist (die weiche Kante des Freistellers), scheint die Ebene durch und trägt, was das Foto dort enthält: Die eigene Dunkelheit des Produkts, die in der Ebene enthalten ist (Abbildung 16), etwaige weiße oder Hintergrundreste in F und Segmentierungsfehler in m können jeweils einen helleren oder dunkleren Saum erzeugen. Die Herleitung belegt daher keine artefaktfreie Produktkante. Was die Methode belegt, ist enger gefasst: Sie hat keine Ausschlusslücke um das Produkt (siehe Hinweis zur Umsetzung unten), und auf dem einen geprüften Bild, dem Ecksofa, erschien uns die Kante nach Augenmaß akzeptabel. Prüfungen mit weichem Alpha, farbigen Kanten und browsergerenderten Kanten wurden nicht durchgeführt (Abschnitt 5.5).
Übereinstimmung mit der freigegebenen Vorschau. Eine Rasterung der Studio-Darstellung mit der übernommenen Ebene und eine Rasterung einer früheren, intern freigegebenen Multiplizieren-Vorschau desselben Bildes (beide vollständige Bilder einschließlich Freisteller, beide mit 1.600 px in librsvg, nicht in Chrome) unterschieden sich um mittlere absolute 0,02 Graustufen (RGB-Mittel 0,023 / 255; nach Rec. 709 gewichtetes Grau der kodierten Werte 0,023 / 255; für diesen Bericht gemessen). Wie die Vorschau erstellt wurde, ist nicht festgehalten, daher prüft dies die Übereinstimmung mit der Vorschau, nicht die Formel; zudem wird ein Mittelwert über das ganze Bild durch den unveränderten Hintergrund verdünnt und sagt daher wenig über die Kante aus. Eine Metrik für den Kantenbereich ist in Abschnitt 11 aufgeführt.
Hinweis zur Umsetzung. Eine frühere Implementierung schnitt den Bereich mit 2 px Abstand zur Produktkante aus und behielt nur Pixel, die dunkler als 250 waren; das Ergebnis wurde an der Produktkante als gezackt beurteilt. Die endgültige Methode hat keinen dieser Schnitte: Jedes Pixel im Bereich erhält das oben beschriebene Alpha, und allein der Freisteller definiert die Produktkante.
5.5 Anwendbarkeit
Die Ebene wird nur erstellt, wenn alle folgenden Bedingungen erfüllt sind; andernfalls hat Frame 0 keinen Produktschatten, wie in der letzten Zeile von Abschnitt 5.3, und die Generierung läuft weiter.
- Heuristik der Randhelligkeit aus Stichproben. Die mittlere Helligkeit (Median) der entlang der vier Ränder des Fotos abgetasteten Pixel beträgt mindestens 240. Damit sollen Raum- oder farbige Hintergründe ausgeschlossen werden, deren dunkle Pixel Szenerie und kein Schatten sind und auf den Teller gedruckt würden. Es handelt sich um eine Heuristik, nicht um die Verifizierung eines Fotos mit weißem Hintergrund: Sie misst weder die Gleichmäßigkeit des Hintergrunds noch, ob die Dunkelheit ein Schatten ist, und sie lässt zum Beispiel eine Raumaufnahme mit weißem Rand passieren oder ein Bild, dessen heller Rand eine dunkle Szenerie im Inneren umschließt.
- Gleiche Größe. Foto und Freisteller haben dieselben Pixelabmessungen. Das ist die einzige Registrierungsprüfung; gleiche Abmessungen beweisen keine pixelgenaue Entsprechung.
- Mindestens ein dunkles Pixel außerhalb des Freistellers. Mindestens ein Pixel im Bereich mit Freisteller-Alpha ≤ 24 hat ein Ebenen-Alpha ungleich null (angehobene Helligkeit unter 255). Das ist kein semantischer Schattendetektor: Jedes solche Pixel, ob Schatten oder nicht, besteht die Prüfung.
- Das Foto wird geladen. Ein fehlgeschlagenes Laden oder Dekodieren entfernt nur den Schatten, nicht den Freisteller.
Die Unit-Tests sind synthetische Tests auf Array-Ebene an einem Bild mit 40 × 30 und einem Freisteller mit binärem Alpha. Sie decken den Alphawert eines grauen Schattenpixels ab, dass ein Schattenpixel neben dem Produkt dasselbe Alpha erhält wie ein weiter entferntes (keine Ausschlusslücke in der Ebene), die untere Grenze des Bereichs sowie das leere Ergebnis bei einem gleichmäßig nicht weißen Hintergrund und bei einem sauberen weißen Boden. Sie prüfen weder ein weich auslaufendes Freisteller-Alpha noch farbige Kanten, Browser-Rendering, abweichende Abmessungen, Fehlalarme am Rand oder die seitlichen Grenzen des verbreiterten Bereichs, und sie validieren nicht die Qualität der gerenderten Kante. Die Methode wurde an einem Produktfoto, dem Ecksofa, visuell geprüft. Für dieses Foto beträgt der Median der Randhelligkeit 254,0, der Produktrahmen ist (43, 222), 1106 × 388 px, und der Bereich ist x ∈ [0, 1200), y ∈ [222, 707), an beiden Seiten des Fotos beschnitten; eine Neuberechnung der Ebene aus dem Original-JPEG reproduziert die im gespeicherten SVG von Frame 0 eingebettete Ebene exakt (mittlere und maximale Alpha-Differenz 0).
5.6 Grenzen des übernommenen Schattens
- Kamerageometrie. Der Schatten ist so zu sehen, wie das Foto ihn zeigt (von vorn, leicht von oben), zusammen mit dem Freisteller skaliert. Er wird nicht auf die 14°-Ansicht der gezeichneten Scheibe umprojiziert und verwendet nicht die Grundfläche der Form, seine Tiefe auf dem Teller ist also die des Fotos, nicht die der Scheibe. Es ist dieselbe Perspektivabweichung wie beim Freisteller selbst (Abschnitt 10).
- Dunkelheit, die kein Schatten ist. Alles Dunkle in dem Bereich, den der Freisteller entfernt hat, bleibt als Dunkelheit erhalten: Lücken zwischen Teilen des Produkts, die der Freisteller transparent gemacht hat, eine sichtbare Boden- oder Horizontlinie, Spiegelungen, Flecken oder Retuschereste. Der Bereich beginnt an der Oberkante des Produkts, daher sind Lücken innerhalb der Silhouette eingeschlossen.
- Feste Schwellen. Der Weißpunkt (250) und der Hintergrundtest (240) sind Konstanten, nicht pro Foto gemessen. Ein Hintergrund zwischen 240 und 250 besteht den Test, hinterlässt aber eine schwache gleichmäßige Tönung über dem gesamten Bereich (L = 245 ergibt etwa 2 % Abdunklung) mit geraden Kanten dort, wo der Bereich endet; ein Schatten, der heller als 250 ist, geht verloren.
- Begrenzter Bereich. Ein Schatten, der mehr als 25 % der Produkthöhe unter das Produkt oder mehr als 5 % seiner Breite seitlich darüber hinausreicht, wird mit einer geraden Kante abgeschnitten. Schatten außerhalb der oberen Ellipse der Scheibe entfällt durch den Beschnitt.
- Eine Ansicht. Nur der Schatten des Frontfotos wird verwendet; welchen Schatten das Produkt nach Frame 0 hat, generiert das Modell.
- Nur Helligkeit. Farbe im Schatten des Fotos wird nicht wiedergegeben (Abschnitt 5.4).
5.7 Offene Frage
Für keine Generierung ist festgehalten, dass sie den übernommenen Schatten verwendet hat. Zwei Beobachtungen aus den Neuaufnahme-Clips (Abschnitt 7.6), deren Frame 0 keine gezeichnete Ellipse hatte:
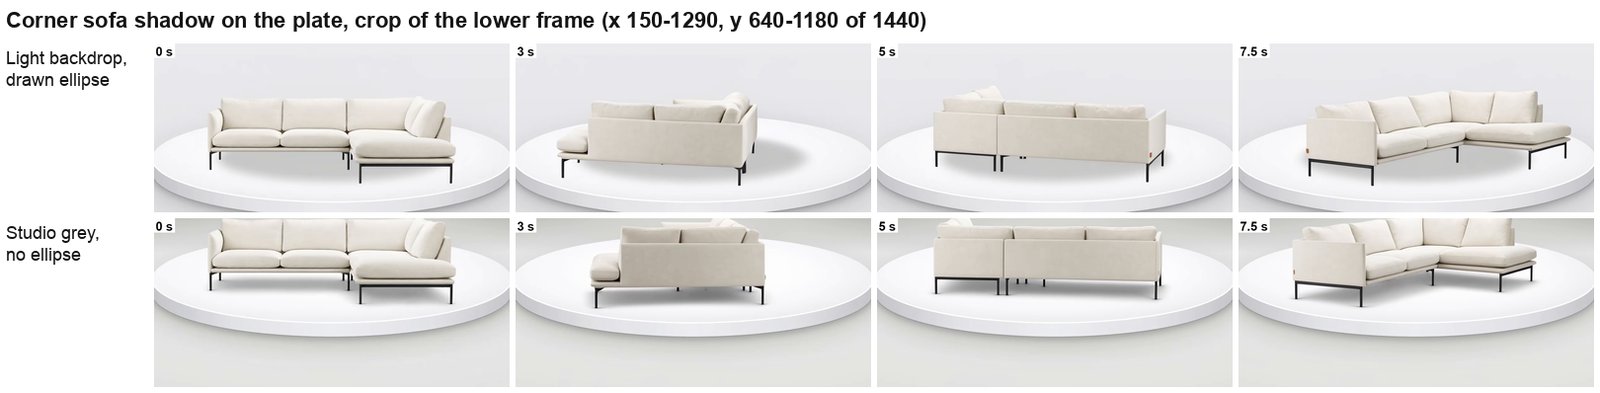
- Ecksofa ohne die Ellipse. Im Neuaufnahme-Clip des Ecksofas (Abbildung 18, untere Reihe) folgt der Schatten auf dem Teller bei 0, 2,5, 5 und 7,5 s der L-Form, und es ist keine runde Spur zu sehen (Bilder des Operators; vereinbar mit Ausschnitten des Tellers bei 0, 3, 5 und 7,5 s, die für diesen Bericht betrachtet wurden). Verglichen mit dem Fleck im Produktionsclip des Ecksofas (Abbildung 13) ist dies damit vereinbar, dass die gezeichnete Ellipse diese Spur verursacht hat, doch es ist ein Clip pro Bedingung, bei dem auch andere Einstellungen geändert wurden (Hintergrund, Größe, Mitte), kein kontrollierter Test mit entfernter Ellipse; ob dieser Frame 0 einen übernommenen Schatten enthielt, ist nicht festgehalten.
- Anscheinend aus den Referenzfotos übernommene Schatten (Hypothese). Der Operator verglich die Referenzfotos des Sessels von der Seite und von hinten mit dessen Bild bei 2,5 s und fand, dass der Bodenschatten im Clip den Schatten in den Fotos ähnelte. Das ist ein visueller Eindruck an einem Produkt; er lässt sich aus der Ausgabe nicht belegen und wird als Hypothese darüber festgehalten, wie das Modell den Schatten während der Drehung bildet, nicht als Befund.
Ob das Modell während der Drehung einen Schatten unter dem Produkt beibehält, ihn starr mit dem Produkt dreht, ihn als feste Spur auf dem Teller zurücklässt (wie es der Ecksofa-Clip für die gezeichnete Ellipse nahelegt) oder ihn durch einen eigenen ersetzt, ist nicht verifiziert. Keine dieser Varianten ist automatisch richtig: Unter festen Lichtquellen ändert ein echter Schlagschatten seine Form, wenn sich die Ausrichtung des Objekts ändert, daher ist weder eine feste Spur noch eine starr mitrotierende Kopie des Fotoschattens im Allgemeinen physikalisch korrekt. Eine zweite offene Frage ist, ob ein Schatten in Frame 0 die Treue zum Startbild verändert (Abschnitt 7.5). Abschnitt 11 führt die Ablationsstudie für beide Fragen auf.
6. Was das System festlegt und was nicht
Durch die Methode festgelegt, unter den genannten Bedingungen:
- Bei erfolgreichem Rendern und Hochladen und ohne ein vom Nutzer bereitgestelltes erstes Bild oder eine Fortsetzung hat das als
start_image_urlgesendete komponierte Startbild die Komposition der Vorschau (ohne den Hilfsring) mit den eingestellten Parametern, im Seitenverhältnis des Clips. - Bei gleichen Drehteller-Einstellungen hat das komponierte Startbild jedes Produkts dieselbe Drehtellerbreite, -dicke und -position. Die Produktgröße folgt der Regel der normierten Belegung aus Abschnitt 4.3, nicht einem gemeinsamen physischen Maßstab.
- Das komponierte Startbild wird mit der Generierung gespeichert und kann über die Ausgabe gelegt werden.
- Die Einstellungen werden im Konto gespeichert und wiederverwendet.
- Wenn die Verarbeitung im Browser gelingt, enthält der Clip mit Standbildern die Bewegungssequenz, gefolgt (oder angeführt) von wiederholten dekodierten Endbildern, als Ganzes neu kodiert; bei Standbild-Pausen aus ganzen Frames (wie den in der Produktion verwendeten 1–3 s bei 24 fps) decken die Kopien genau die angeforderte Zeit ab, während das Timing bei Bruchteilen und bei vorangestellten Standbild-Pausen Abschnitt 4.7 folgt und nicht verifiziert ist.
- Der Freisteller wird einmal pro Foto berechnet und bei einem Fehlschlag erstattet; ist Eigener Bildaufbau ausgeschaltet, wird davon nichts gesendet oder berechnet.
- Wenn alle vier Prüfungen aus Abschnitt 5.5 bestanden sind (Randhelligkeit aus Stichproben, gleiche Pixelabmessungen, mindestens ein dunkles Pixel außerhalb des Freistellers, erfolgreiches Laden), enthält Frame 0 die angehobene Dunkelheit des Fotos im Bereich um das Produkt, beschnitten auf die Oberseite der Scheibe, unter dem Freisteller; andernfalls hat Frame 0 keinen Produktschatten. Das Bestehen der Prüfungen verifiziert weder, dass das Foto eine Aufnahme auf weißem Hintergrund ist, noch, dass die Dunkelheit ein Schatten ist, noch, dass Foto und Freisteller registriert sind.
- Wenn das komponierte Startbild als Startbild gesendet wird, die Drehung Auto oder 360° ist und der Nutzer kein letztes Bild festgelegt hat, wird dasselbe komponierte Startbild auch als Endbild gesendet (Abschnitt 4.4). Ob das Modell dann darauf endet, den Bildaufbau dazwischen beibehält oder dennoch eine volle Drehung ausführt, legt die Methode nicht fest.
In einer kleinen explorativen Stichprobe beobachtet, nicht festgelegt: dass das erste Ausgabebild dem komponierten Produkt- und Plattformlayout folgt (näherungsweise, nach Augenmaß); dass es den komponierten Hintergrund behält (Hell: 3 von 4 Produktionsclips; Studiograu, ein separater Satz: laut Operator in 6 von 6 Neuaufnahme-Clips, für diesen Bericht gesehen in den 5, die einer heruntergeladenen Datei zugeordnet sind, Abschnitt 5.1); dass der Bildaufbau von Frame 0 für den Rest des Clips erhalten bleibt (in einem der fünf Neuaufnahme-Clips nur mit Startbild war das nicht der Fall, Abschnitt 7.6); dass das Produkt während der gesamten Drehung auf der Plattform bleibt; Schließen der Schleife; Größe und Proportionen während der Drehung; eine vollständige Drehung in eine Richtung; strukturelle Treue. Die Bewegungssequenz wird vom Modell generiert; optionale Standbild-Pausen wiederholen dekodierte Endbilder, und das vollständige Video wird neu kodiert. Das unterscheidet sich davon, ein Produkt während der gesamten Bewegung auf einen Teller zu compositen, was bewusst ausgeschlossen wurde.
7. Explorative Auswertung
7.1 Stand der Evidenz
Alle Tests in diesem Bericht sind explorativ: meist ein Durchlauf pro Bedingung oder Produkt (das Anker-Experiment hatte drei Durchläufe pro Bedingung), Einstellungen gezielt oder adaptiv variiert, nicht verblindet beurteilt von den Personen, die das System gebaut haben, ohne zurückgehaltene Produkte. Die Metriken wurden während der Arbeit angepasst (Abschnitt 7.4). Keines der folgenden Ergebnisse ist eine Rate, und kein Vergleich zwischen Bedingungen kontrolliert für Produkt, Parameter oder zufällige Schwankung.
7.2 Ausgangslage: ausgelieferte Clips ohne komponiertes Startbild
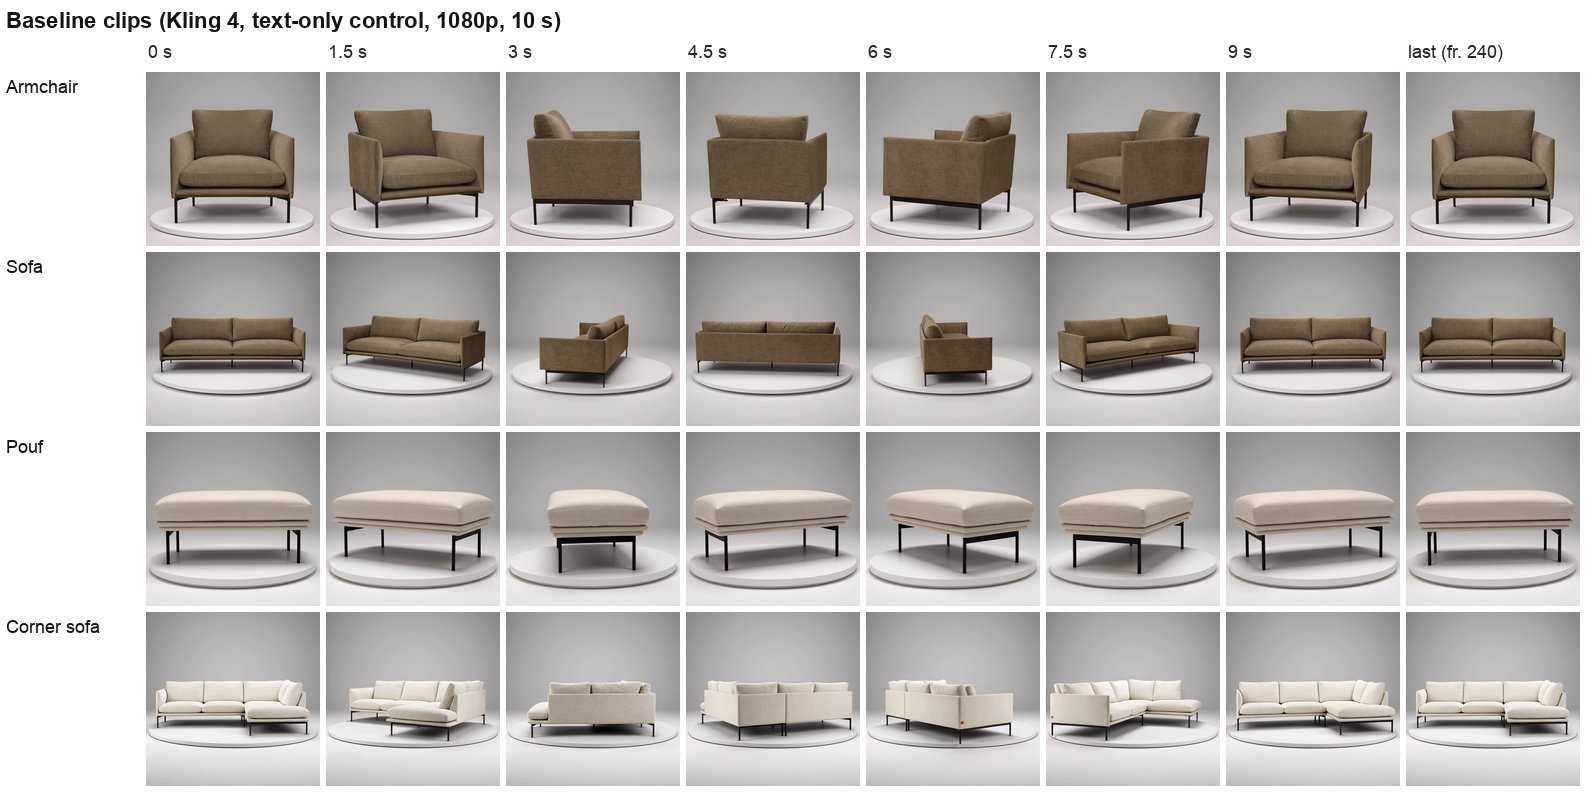
Vier Clips der Produkte des Kunden (Kling 4, 1080p, 1:1, 10 s, Steuerung nur per Text mit verborgener Ebene v3): Der Teller war in allen vier auf dem Bildschirm etwa gleich breit, und jedes Produkt wurde ins Bild eingepasst (Sessel etwa 75 % der Tellerbreite, Sofa etwa 90 %, Pouf füllte den Teller und ragte darüber hinaus); SSIM zwischen erstem und letztem Bild 0,85–0,97, wobei jeder Clip 10–15° vor der Frontansicht endete; die Récamiere des Ecksofas und ein hinterer Fuß ragten in Seitenansichten über den Tellerrand. Die Clips sind in Abbildung 19 zu sehen.
7.3 Produktionsclips mit dem komponierten Startbild
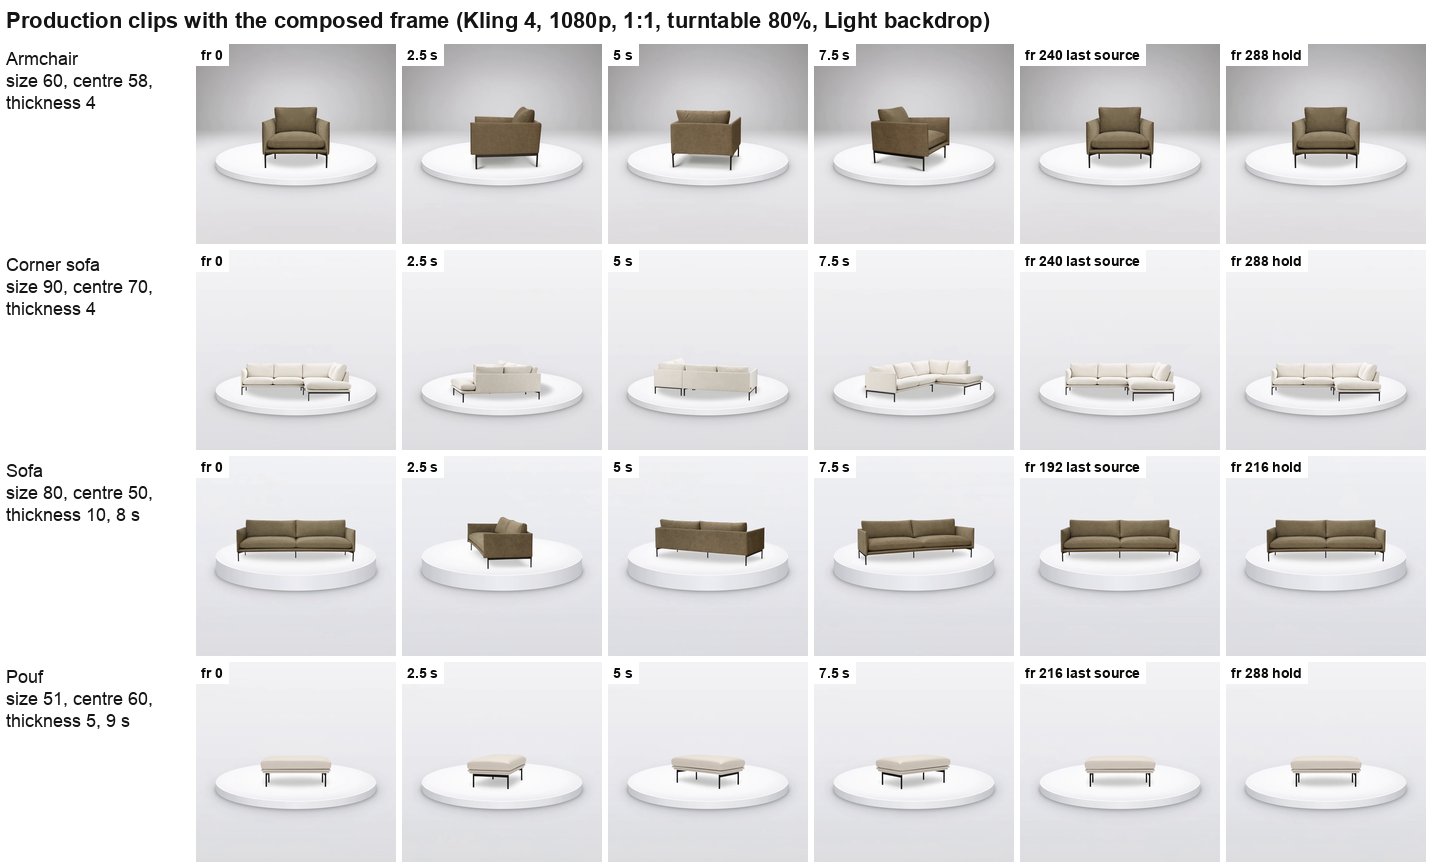
Vier Clips wurden auf der Produktionsseite mit Eigener Bildaufbau, Kling 4, 1080p, 1:1, mit Ton generiert. Die Einstellungen wurden zwischen den Möbelstücken variiert, um die Bedienelemente zu erproben (Anhang B). Prüfungen:
- Erstes Ausgabebild gegenüber dem komponierten Startbild, per Sichtvergleich (dieselbe Überlagerung ist im Produkt verfügbar): ungefähre Layout-Treue für Produkt und Plattform und, getrennt davon, Erhalt des Hintergrunds.
- Eingrenzung, nach Augenmaß an 34–40 Frames pro Clip, mit Blick auf Füße und das Ende der Récamiere gegenüber dem Scheibenrand.
- Endpunktdifferenz: mittlere absolute Pixeldifferenz zwischen dem ersten Bild und dem letzten Bild vor der Standbild-Pause, auf einer Skala von 0–255. Farbraum, Auflösung, Skalierungsverfahren und Analysebereich wurden für diese Clips nicht festgehalten; die Skripte des Anker-Experiments verwendeten vollständige Graustufenbilder mit 240 × 240, wobei eines vor einer Flächenskalierung in Grau umwandelte und ein anderes vor dem Umwandeln (bilinear) skalierte, sodass selbst diese beiden nicht identisch sind.
- Bewegung: alle 0,2 s abgetastete Frame-Differenz sowie Sichtprüfung auf Ruckeln oder Verformung.
- Standbild-Pausen: Dateilänge und Stillstand der Endbilder.
| Produkt | Clip | Länge | Größe | Drehteller / Dicke / Mitte (%) | Pause danach | Layout-Treue (ungefähr) | Hintergrund erhalten | Über den Rand in abgetasteten Frames | Endpunktdifferenz |
|---|---|---|---|---|---|---|---|---|---|
| Sessel | Abbildung 20 (siehe Hinweis zur Herkunft) | 10 s | 60 % | 80 / 4 / 58 | 2 s | ja (gemeldet) | nein: durch ein dunkleres graues Studio ersetzt | keines gesehen (gemeldet) | nicht einzeln festgehalten |
| Ecksofa | Abbildung 20 | 10 s | 90 % | 80 / 4 / 70 | 2 s | ja | ja | keines gesehen | 0,92 |
| Sofa | Abbildung 20 | 8 s | 80 % | 80 / 10 / 50 | 1 s | ja | ja | keines gesehen | nicht einzeln festgehalten |
| Pouf | Abbildung 20 | 9 s | 51 % | 80 / 5 / 60 | 3 s | ja | ja | keines gesehen | 0,57 |
Eine interne Notiz nennt den Bereich 0,57–1,79 über die vier Clips und 1,5–5,5 für Frames im Abstand von 0,2 s während der Drehung. Beim Sofa war eine Drehung gegen den Uhrzeigersinn angefordert, es drehte sich aber im Uhrzeigersinn. Die komponierte Drehtellerbreite, Dicke, Höhe der Mitte und Produktgröße wurden in allen vier näherungsweise, nach Augenmaß, eingehalten; der komponierte Hintergrund blieb in drei erhalten (Abschnitt 5.1). Aus diesen Sichtprüfungen lässt sich keine exakte Anzahl von Übereinstimmungen des ganzen Bildes ableiten. Betrachtet bei 0, 2,5, 5 und 7,5 s, beim letzten Quellframe und beim letzten Pausenframe unterscheiden sich Größe, Tellerdicke und Tellerhöhe je Möbelstück wie eingestellt; Ecksofa, Sofa und Pouf behalten den hellen Hintergrund, und der Sessel steht ab Frame 0 in einem dunkleren grauen Studio.
Herkunft. Die einzelnen Endpunktwerte für den Sessel und das Sofa, die verglichenen Frames, die Vorverarbeitung und der Bewertungsbefehl sind nicht festgehalten. Die ursprüngliche Auswertungsnotiz identifizierte den Sessel-Clip nicht eindeutig (eine lokale Aufnahme und der verlinkte Produktionsclip haben unterschiedliche Einstellungen); ein späterer Produktionsdatensatz identifiziert den verlinkten Produktionsclip. Der einzelne Endpunktwert des Sessels ist weiterhin nicht festgehalten, daher sind die Sessel-Zeile und der Bereich 0,57–1,79 intern gemeldet und nicht unabhängig reproduzierbar. Es handelt sich um eine ungeklärte Herkunft, nicht um einen Beleg dafür, dass es keine vier Produktionsclips gab.
Was diese Prüfungen stützen. Keine sichtbare Verletzung der Eingrenzung in den abgetasteten Frames, nicht aber eine Eingrenzung während der gesamten Drehung: Füße können verdeckt sein, und eine projizierte Silhouette, die die gezeichnete Ellipse überschreitet, ist nicht dasselbe wie eine Grundfläche, die die Plattform verlässt. Sichtbare strukturelle Konsistenz, nicht Treue zu nicht beobachteten realen Oberflächen. Eine geringe Endpunktdifferenz, keine nahtlose Schleife: Frames im Abstand von 0,2 s entsprechen bei 24 fps etwa fünf Frame-Intervallen, nicht einem gewöhnlichen Schritt; die beiden Bereiche überschneiden sich (1,79 > 1,5); und Endpunktähnlichkeit allein würde auch ein Clip erfüllen, der sich kaum bewegt, die Richtung umkehrt oder in einer ähnlichen, aber falschen Pose endet. Die Bewegungskontinuität über den Übergang hinweg wurde nicht gemessen, und es wurde kein Betrachtertest zur Sichtbarkeit der Naht durchgeführt. Beim Versand der Clips beschrieb die Korrespondenz die Standbild-Pause als optional, weil die Clips nahtlos loopen; das war eine Behauptung in der Korrespondenz, kein gemessenes Ergebnis.
| Mangel | Ausgangslage (kein komponiertes Startbild) | Produktion (komponiertes Startbild) |
|---|---|---|
| R1 Größe | Produkt ins Bild eingepasst; Pouf so breit wie das Sofa | Größe vom Nutzer je Möbelstück eingestellt und im komponierten Startbild sichtbar; gleiche Tellerbreite in allen vier, Dicke und Position bewusst variiert |
| R2 Eingrenzung | Récamiere und ein hinterer Fuß in Seitenansichten über dem Rand | Ecksofa bei 90 %: in abgetasteten Frames nichts gesehen |
| R3 Endpunkte | SSIM 0,85–0,97, 10–15° vor der Frontansicht | Endpunkt-MAE 0,57–1,79 (intern gemeldet); andere Metrik |
Die lokale Sessel-Aufnahme 3 (Abschnitt 3.1), mit SSIM gemessen, ergab 0,98.
7.4 Offengelegte Anpassungen der Metriken
- Im Anker-Experiment wurden die Bestehensgrenzen vor der ersten Stufe festgelegt, doch eine absolute Nahtschwelle (letztes gegenüber erstem Bild ≤ 4 Graustufen) kam nach der ersten Stufe hinzu, weil das vorab registrierte Nahtverhältnis langsam bewegte Clips benachteiligte, und eine Umkehr-Metrik (eine Winkelspur aus der Ähnlichkeit zu vier komponierten Ansichten) kam nach der zweiten Stufe hinzu, als die ursprünglichen Metriken eine Umkehr übersehen hatten.
- Für die Produktionsprüfungen gab es keine vorab festgelegten Bestehensgrenzen.
- Der Schleifenschluss wurde bei den Ausgangsclips als SSIM und bei den Produktionsclips als mittlere absolute Differenz gemessen. Das sind unterschiedliche Maße und nicht vergleichbar; nötig ist ein Protokoll, das auf beide Sätze angewandt wird (Abschnitt 11). Eine retrospektive Neubewertung aller lokal vorliegenden Clips nach einem einheitlichen Protokoll findet sich in Abschnitt 7.7; sie ist beobachtend und ersetzt die geplante Auswertung nicht.
7.5 Layout-Treue zum Startbild über die Durchläufe
| Durchlauf | Modell | Startbild | Clips | Ungefähre Layout-Treue für Produkt und Plattform | Hintergrund erhalten |
|---|---|---|---|---|---|
| Anker-Experiment, B und C | Kling 3.0 Omni | komponiert (Start = Ende oder verkettet) | 6 | 6 von 6 (Produktbreite in Frame 0 innerhalb von 0,7 %) | nicht bewertet |
| Lokale Aufnahme 1 | Kling 4 | flach gezeichnete Scheibe | 1 | 0 von 1 | nein (eigene Komposition des Modells) |
| Lokale Aufnahmen 2–3 | Kling 4 | fotografisch schattierte Scheibe | 2 | 2 von 2 | nicht gesondert festgehalten |
| Produktion | Kling 4 | schattierte Scheibe mit Kontaktschatten | 4 | 4 von 4 | 3 von 4 |
| Neuaufnahme, nur Start (Abschnitt 7.6) | Kling 4 | schattierte Scheibe, Hintergrund Studiograu | 5 | 5 von 5 bei Frame 0 (gemeldet); danach driftete der Bildaufbau in 1 von 5 | graues Studio laut Operator in allen 5, für diesen Bericht gesehen in den 4, die heruntergeladenen Dateien zugeordnet sind; Graustufen an den gemessenen Punkten nahe an der angepassten Referenz (Abschnitt 5.1) |
| Neuaufnahme, Start = Ende (Abschnitt 7.6) | Kling 4 | dasselbe komponierte Startbild als Start und Ende, von Hand gesetzt | 1 | 1 von 1 | graues Studio gesehen; nahe an den gemessenen Punkten (Abschnitt 5.1) |
Layout-Treue bedeutet hier, dass Produkt und Plattform ungefähr in der komponierten Größe und Position erscheinen, nach Augenmaß beurteilt; sie ist keine Übereinstimmung des ganzen Bildes. Die sechs Layout-Erfolge mit Kling 4 fassen lokale Entwicklungsdurchläufe und Produktionsdurchläufe mit unterschiedlichen Kompositionen, Prompts und Einstellungen zusammen. Unter einer IID-Annahme läge die exakte binomiale untere 95-%-Grenze für 6 von 6 bei etwa 54 %, doch diese Annahme beschreibt diese zusammengefasste Entwicklungsstichprobe nicht. Der einzelne Fehlschlag mit flacher Scheibe, gefolgt von Erfolgen mit schattierter Scheibe, begründet die Hypothese, dass der Darstellungsstil des komponierten Startbilds die Treue beeinflusst; er belegt sie nicht. In den lokalen Aufnahmen begann die Ausgabe mit der flach gezeichneten Scheibe (Aufnahme 1) mit einem großen Stuhl auf einer großen Scheibe; mit der schattierten Scheibe (Aufnahmen 2 und 3) begann sie mit dem komponierten kleinen Stuhl und behielt diese Größe während der Drehung bei. Die Zeilen der Neuaufnahmen werden gesondert aufgeführt, weil ihre Messungen durch den Operator nach einem anderen Protokoll erfolgten, weil sie einen anderen Hintergrund verwendeten (Studiograu statt Hell; die Zählungen zum Erhalt des Hintergrunds aus beiden Sätzen werden nicht zusammengefasst) und weil sich herausstellte, dass Treue in Frame 0 nicht bedeutet, dass der Bildaufbau nach Frame 0 erhalten bleibt (Abschnitt 7.6).
7.6 Drift des Bildaufbaus während der Drehung und das komponierte Startbild als Endbild
Aufbau. Sechs Clips, vom Operator im Studio nach den Schattierungsüberarbeitungen aus Abschnitt 5 erstellt: Kling 4 Reference-to-Video, 1080p, 1:1, 10 s plus eine Pause von 2 s danach, Eigener Bildaufbau mit Drehteller bei 80 % des Bildes, Dicke 4 %, Mitte 58 % von oben und dem Hintergrund Studiograu, also die festen Parameter eines Neuaufnahme-Plans, der älter ist als die Clips und diese nicht festhält. Die Größenwerte je Möbelstück, die verwendeten PNGs für Frame 0, ob Frame 0 einen übernommenen Schatten enthielt (Abschnitt 5), der Prompt in der gesendeten Form und ob die Clips in der Produktion oder lokal erstellt wurden, sind nicht festgehalten. Die Fotos des zweiten Bettmodells sind drei Front- und Dreiviertelansichten auf Weiß, ohne Rück- oder Seitenansicht.
Ergebnisse. Tellerbreite (in Prozent der Bildbreite), Tellermitte (in Prozent der Bildhöhe von oben) und SSIM zwischen erstem und letztem Bild sind Messungen des Operators, alle 0,5 s abgetastet; die Messdateien sind nicht verfügbar. Die SSIM-Werte in eckigen Klammern sind eine Prüfung für diesen Bericht an den heruntergeladenen Kopien mit Standbildern (1440 × 1440, 24 fps, 289 Videoframes; Videostream 12,041667 s, Container 12,120816 s, weil der Audiostream länger ist): ffmpeg ssim (Y, "All") auf vollständigen Graustufenbildern, dekodierter Frame 0 gegenüber Frame 240 bei 10,000 s, dem letzten Quellframe vor den 48 Pausenkopien (Abschnitt 4.7). Ein Vergleich mit Frame 239 ändert die Werte um 0,001–0,002. Ob die beiden Protokolle, das des Operators und dieses, identisch sind, ist nicht bekannt.
| Produkt | Clip | Konditionierung | Tellerbreite über den Clip | Tellermitte über den Clip | Volle Drehung | SSIM erstes gegenüber letztem Bild, gemeldet [dieser Bericht, Frame 0 gegenüber 240] |
|---|---|---|---|---|---|---|
| Bett (zweites Modell) | Bett-Clip nur mit Startbild, nicht ausgeliefert, kein öffentlicher Link | nur Start | 80,0 % bei 0 s, 89 % bei 5 s, 97,5 % bei 8 s, über 100 % (über beide Bildränder hinaus) ab 9 s | 58 % → 67 % | gedreht; letztes Bild etwa 25 % größer als das erste, die Schleife springt also | nicht angegeben [0,845, heruntergeladene Kopie diesem Clip nach Inhalt zugeordnet] |
| Bett (zweites Modell) | Bett-Clip mit Start = Ende (Abbildungen 23, 26) | Start = Ende (dasselbe komponierte Startbild als Erstes Bild und Letztes Bild) | 80,0–80,1 % in jeder auswertbaren Stichprobe; zwei Stichproben in Seitenansicht ausgeschlossen, weil das Bett die breiteste Zeile des Tellers verdeckt und ihre Breite daher nicht auswertbar ist | 58,1 % | ja, 360° | 0,993 [0,994] |
| Sessel | Neuaufnahme-Clip des Sessels (keine Abbildung) | nur Start | 80,1 % in jedem abgetasteten Frame | 58,1 % | ja | innerhalb von 0,993–0,996 [keine heruntergeladene Kopie diesem Clip zugeordnet] |
| Sofa | Neuaufnahme-Clip des Sofas (Abbildung 26) | nur Start | 80,1 % | 58,1 % | ja | innerhalb von 0,993–0,996 [0,994] |
| Pouf | Neuaufnahme-Clip des Poufs (Abbildung 26) | nur Start | 80,1 % | 58,1 % | ja | innerhalb von 0,993–0,996 [0,997] |
| Ecksofa | Neuaufnahme-Clip des Ecksofas (Abbildung 26) | nur Start | 80,1 % | 58,1 % | ja | innerhalb von 0,993–0,996 [0,995] |
Die ausgelieferten Clips sind den Generierungen nur über den Produktnamen zugeordnet. Stichproben alle 0,5 s über 0–10 s ergäben 21 pro Clip; die genaue Anzahl der Stichproben des Operators pro Clip ist nicht festgehalten, nur dass zwei Stichproben des Betts mit Start = Ende ausgeschlossen wurden. Die Standbild-Pausen der fünf ausgelieferten Clips wurden als statisch gemeldet, „0–1 Graustufe“ zwischen den Pausenframes; die Angabe des Operators ist mit einer mittleren absoluten Differenz pro Frame vereinbar, nicht mit einem Maximum pro Pixel. Für diesen Bericht an vier heruntergeladenen Clips nachgemessen (Abschnitt 4.7): nach der ersten Kopie Mittelwerte pro Frame von höchstens 0,010–0,022 und Maxima pro Pixel von 5–11 Graustufen; für den Sessel ist keine heruntergeladene Kopie zugeordnet. Eine weitere heruntergeladene Sessel-Datei vom selben Nachmittag ergibt nach der obigen Prüfung 0,982; sie lässt sich dem ausgelieferten Sessel-Clip nicht zuordnen und wird nicht verwendet.
Für diesen Bericht wurden außerdem Frame 0 und Frame 240 der fünf zuordenbaren heruntergeladenen Clips direkt verglichen (Graustufen, mittlere absolute Differenz): Die vier ausgelieferten Clips unterscheiden sich hauptsächlich entlang von Kanten (0,48–0,89), während das Bett nur mit Startbild sichtbar größer endet (16,54). Ein komponiertes Startbild des Betts, neu gerendert, nachdem der Clip nur mit Startbild erstellt worden war (also bestenfalls eine Neudarstellung des für diesen Clip gesendeten Bildes und nur mutmaßlich das PNG, das für den Clip mit Start = Ende als Erstes Bild und Letztes Bild gesetzt wurde), stimmt in beiden Clips mit Ausgabeframe 0 überein (mittlere absolute Graudifferenz 3,08 und 2,13, Unterschiede an Kanten); bei Frame 240 stimmt der Clip mit Start = Ende weiterhin überein (2,11), der Clip nur mit Startbild nicht (15,20: größeres Bett und größerer Teller). Sekündlich betrachtet wächst das Bett nur mit Startbild während der Drehung, ab 8 s deutlich größer, bis der Teller bei 9,95 s beide Bildränder erreicht, während das Bett mit Start = Ende in jeder Sekunde Tellergröße und -position beibehält.
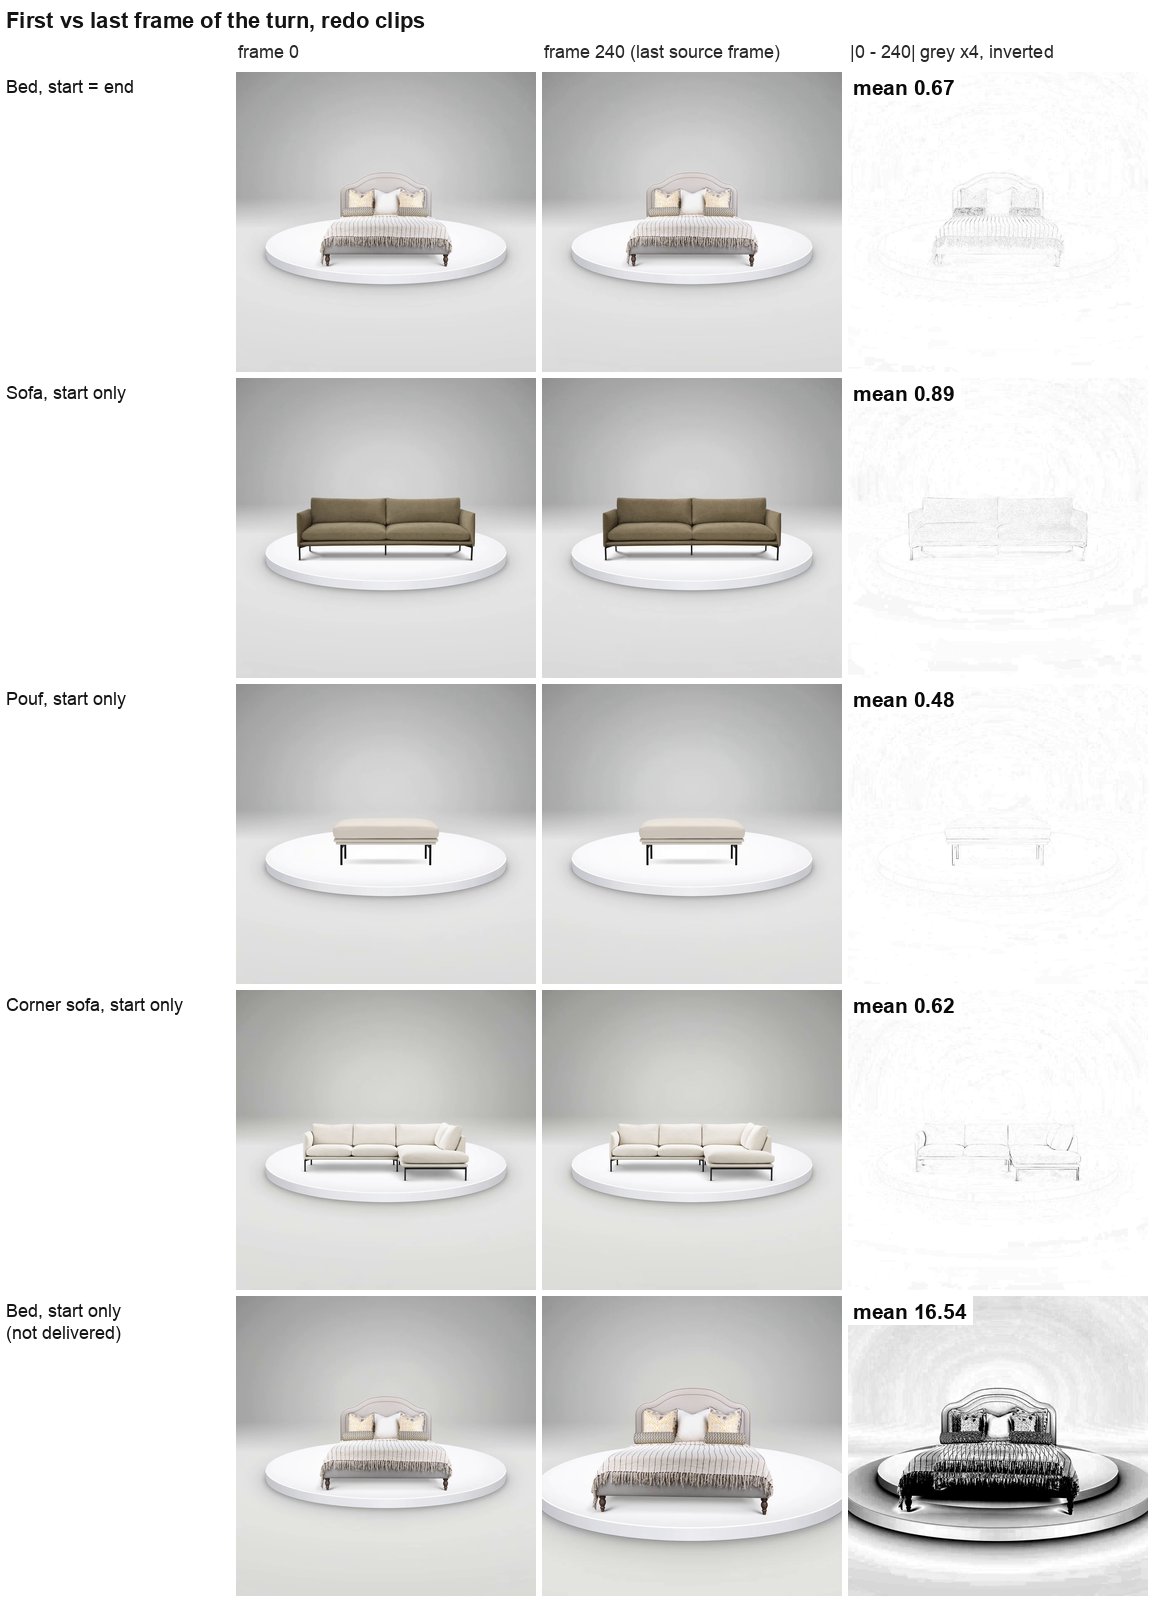
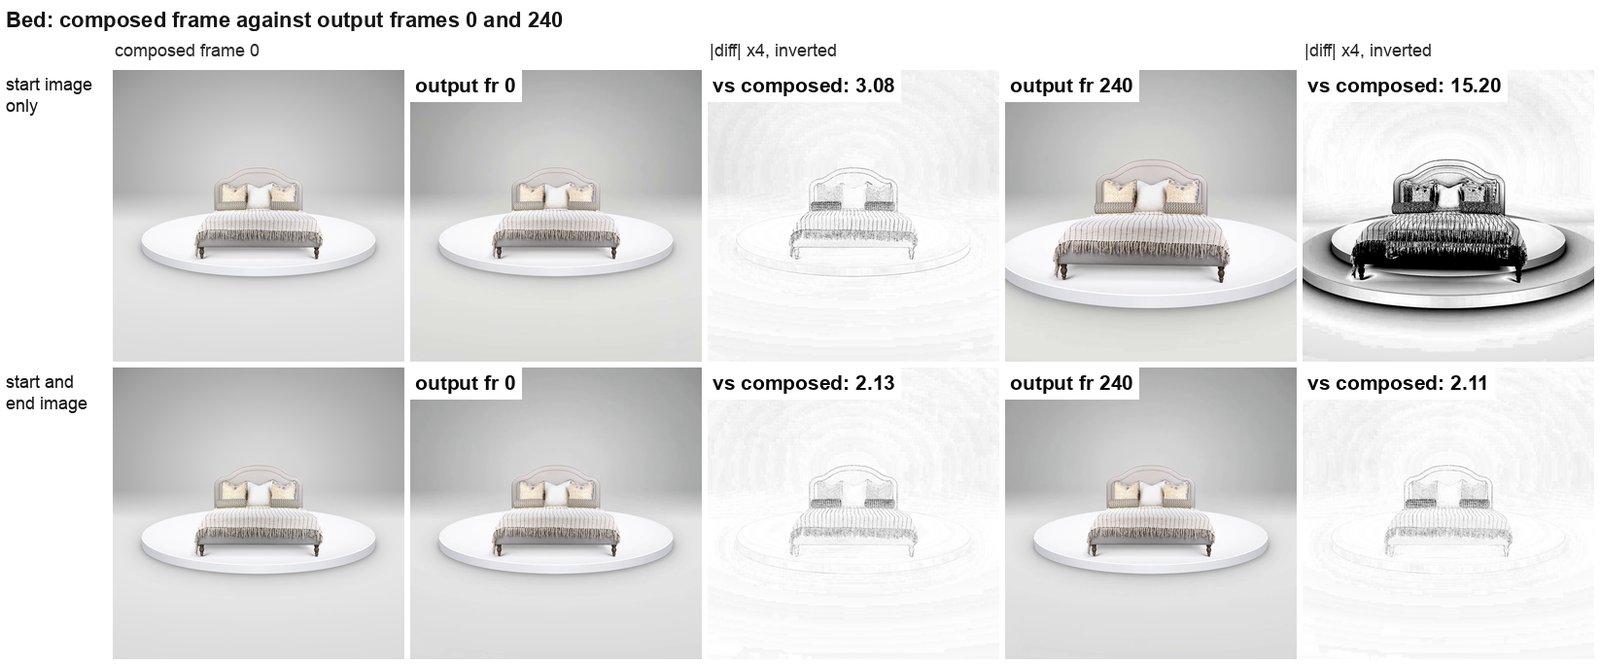
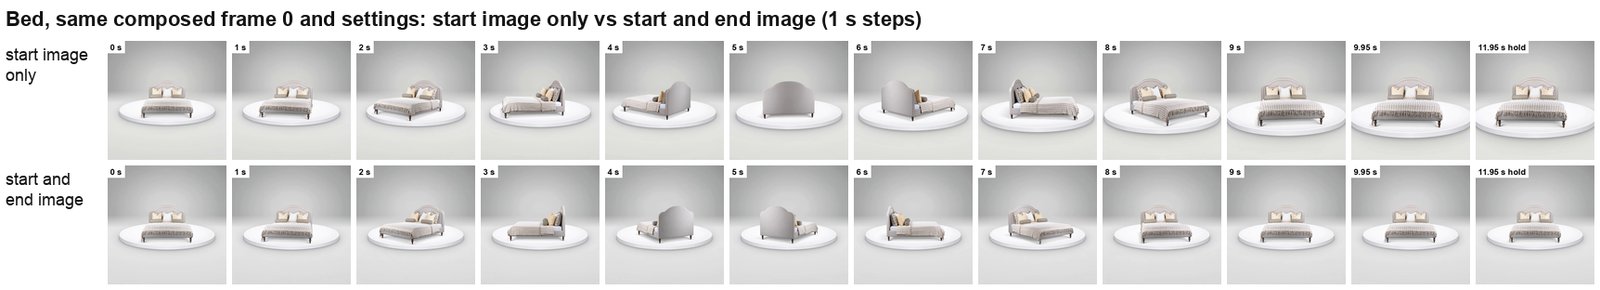
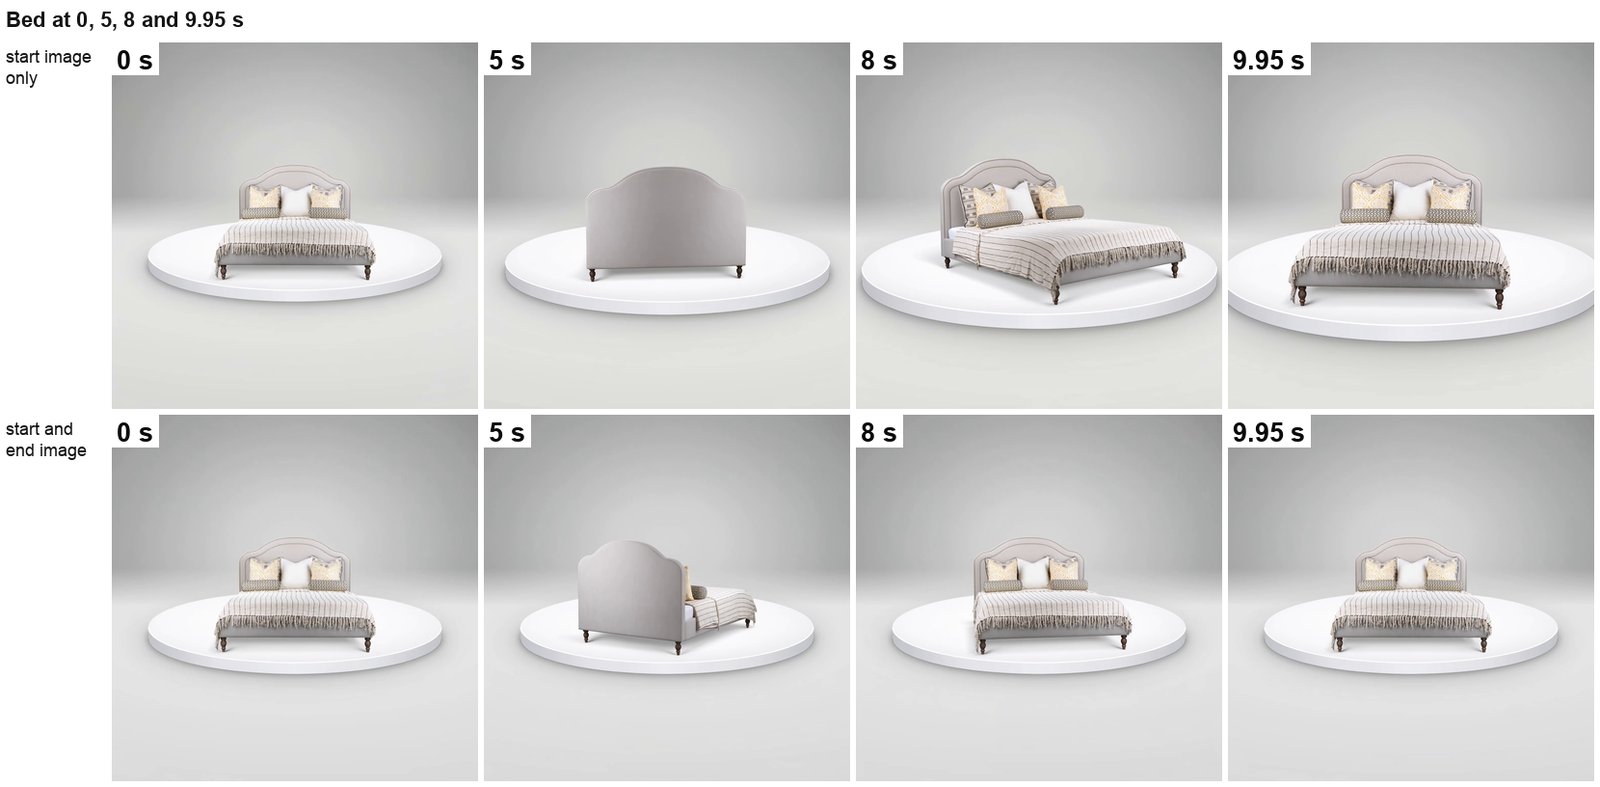
Was diese Clips zeigen. Im Bett-Clip nur mit Startbild folgte das erste Ausgabebild dem komponierten Layout, die Layout-Treue in Frame 0 (Abschnitt 7.5) war also gegeben, danach ging der Bildaufbau verloren: Die Kamera fuhr während der Drehung stetig heran. Die Kamera-Zeile des Prompts ("camera position, aim, focal length, focus, aperture and crop stay constant", Anhang A) war laut Meldung in der Anfrage enthalten und verhinderte dies nicht. Die vier anderen Clips nur mit Startbild behielten den komponierten Bildaufbau in jedem abgetasteten Frame, die Drift trat bei ihnen also nicht auf; sie trat einmal auf, beim tiefsten und höchsten Möbelstück des Satzes (Beschreibung des Operators). Ob sie mit dieser Form zusammenhängt oder ein zufälliges Ereignis ist, das jedes Möbelstück treffen könnte, lässt sich aus einem Clip pro Möbelstück nicht entscheiden, daher sagt der Durchlauf nicht, welche Produkte gefährdet sind. Eine Größenänderung innerhalb eines Clips war schon zuvor ohne komponiertes Startbild beobachtet worden (ein Ausgangsclip mit Kling 3.0 Omni wuchs während der Drehung um 44 %, Abschnitt 3.1), und die zu Beginn der Arbeit geprüften Clips hatten einen stabilen Bildaufbau; die früheren Clips mit komponiertem Startbild wurden nur nach Augenmaß auf die Größe während der Drehung geprüft, und eine solche Drift mit komponiertem Startbild war in dieser Arbeit zuvor nicht festgehalten worden.
Die Wiederholung, bei der das komponierte Startbild zusätzlich als end_image_url gesendet wurde (Kling 4 akzeptiert dies), driftete nicht, und ihr Teller blieb in jeder auswertbaren Stichprobe in der komponierten Breite und Position (zwei verdeckte Stichproben in Seitenansicht ausgeschlossen). Das ist eine Aufnahme pro Arm an einem Produkt; sie zeigt, dass der Durchlauf mit Endbild nicht driftete, nicht, dass das Endbild Drift verhindert. Der Arm nur mit Startbild driftete in einem von fünf Clips, daher würde auch ein unverändertes Rezept nur mit Startbild häufig einen einzelnen nicht driftenden Clip liefern, wie ihn der Arm mit Start = Ende ergab. Endpunkt-Konditionierung ist eine Zielvorgabe, die Übereinstimmung zwischen letztem und erstem Bild begünstigt, keine Garantie dafür, und ihr Beitrag zur beobachteten SSIM von 0,993 (0,994 in der Prüfung) ist nicht gemessen: Die vier Clips nur mit Startbild erreichten ohne sie ähnliche Werte. Ein hoher Wert wäre mit einer unnatürlichen oder unstetigen Drehung dazwischen vereinbar und zeigt daher für sich allein keine nahtlose Schleife (Abschnitt 7.3 führt auf, was Endpunktähnlichkeit nicht zeigen kann).
Offenes Risiko: keine Drehung. Bei identischem Start- und Endbild erfüllt auch ein Produkt, das sich nicht dreht oder sich nur teilweise dreht und zurückkehrt, die Vorgabe, dort zu enden, wo es begann. Das Bett drehte sich in seiner einen Aufnahme einmal vollständig, ebenso der automatische Sessel-Clip mit Start = Ende (unten, Abbildung 27). Bei einer Abtastung alle 0,5 s ist ein kurzes Überschießen oder eine Umkehr zwischen den Stichproben nicht ausgeschlossen; keine Umkehr-Metrik (Abschnitt 7.4) wurde angewandt. Je einmal unter zwei Einstellungen beobachtet, nicht als zuverlässig gezeigt.
Verhältnis zur Anker-Bedingung Start = Ende. Jenes Experiment verwendete Kling 3.0 Omni bei 720p, den grünen Sessel und von separaten Skripten komponierte Anker-Frames; einer seiner drei Clips mit Start = Ende schoss über und kehrte zurück, und die Arbeit mit diesem Modell wurde aus diesem Grund eingestellt. Der vorliegende Clip unterscheidet sich in Modell (Kling 4), Auflösung (1080p), Produkt (ein Bett), Komposition (der eigene Composer des Studios mit dem Hintergrund Studiograu) und Zweck (Erhalt des Bildaufbaus, nicht Schließen der Schleife). Die beiden sind nicht vergleichbar, und dieser Clip widerspricht dem früheren Fehlschlag nicht: Konditionierung mit Start = Ende hat nun bei einem Modell in einem von drei Clips eine Umkehr und bei einem anderen in jedem von zwei Clips eine volle Drehung erzeugt (einer von Hand gesetzt, einer automatisch, Abschnitt 7.6 und unten), was bei keinem der beiden eine Rate ist.
Frühe Ankunft und eine längere Pause (offene Beobachtung). Im Bett-Clip mit Start = Ende erreichte das Bett die Frontpose bei etwa 9,0 s statt am Ende der 10-s-Drehung: Die SSIM gegenüber dem ersten Bild betrug 0,904 bei 8 s, 0,929 bei 8,5 s und 0,993 bei 9 s, und von 9 bis 10 s stand das Bett nahezu still (Änderung von Frame zu Frame etwa 0,05 gegenüber etwa 1,0 während der Drehung; Einheiten wie vom Operator gemessen). Mit der angehängten Pause von 2 s betrug die sichtbare Pause daher etwa 3 s statt der angeforderten 2 s. Der ohne Endbild erstellte Pouf verhielt sich ebenso und erreichte die Front bei etwa 8,5 s, seine sichtbare Pause betrug also etwa 3,5 s; Ecksofa, Sofa und Sessel erreichten die Front erst bei 10 s. Die Ankunftszeiten sind ungefähr und beruhen auf der Posenähnlichkeit zu Frame 0; der Stillstand vor dem Ende der Drehung ist der Frame-zu-Frame-Wert des Operators, kein gemessenes ruhendes Segment. Diese Werte stammen vom Operator; die Messdateien sind nicht verfügbar. Eine Prüfung für diesen Bericht an den heruntergeladenen Kopien mit Standbildern (Graustufen-SSIM des zu jedem Zeitpunkt dekodierten Frames gegenüber dem dekodierten Frame 0, per Suche) ergab 0,920, 0,931 und 0,992 bei 8, 8,5 und 9 s für das Bett mit Start = Ende, 0,987 und 0,996 bei 8 und 8,5 s für den Pouf sowie 0,961, 0,978 und 0,995 bei 9, 9,5 und 10 s für das Ecksofa, im Muster vereinbar mit den Werten des Operators, aber nach einem anderen Protokoll. Eine für diesen Bericht berechnete Reihe pro Frame (SSIM gegenüber Frame 0 bei voller Auflösung; mittlere Änderung von Frame zu Frame auf 480-px-Graustufen) reproduziert diese Einzelwerte; beim Bett fällt die Änderung von Frame zu Frame von einem Mittel von 1,30 über 1–8 s auf 0,054 über 9–10 s, dasselbe Muster wie „etwa 1,0 gegenüber 0,05“ des Operators auf einer anderen Skala, und die SSIM des Betts nur mit Startbild gegenüber Frame 0 bleibt bis zum Ende bei etwa 0,84–0,85. Da ein Clip ohne Endbild dieselbe frühe Ankunft zeigte und der automatische Sessel-Clip mit Start = Ende (unten) nicht früh ankam (0,42 s vor dem Ende): Von den beiden Clips mit Start = Ende erreichte einer die Schwelle für frühe Ankunft und einer nicht, sodass ihr Zusammenhang mit dem Endbild unsicher bleibt; je ein Clip zeigt nicht, wie oft sie auftritt. Eine mögliche, nicht umgesetzte Abhilfe besteht darin, das ruhende Segment vor dem Ende der Drehung zu erkennen und abzuschneiden, sodass die angehängte Standbild-Pause die einzige Pause ist.
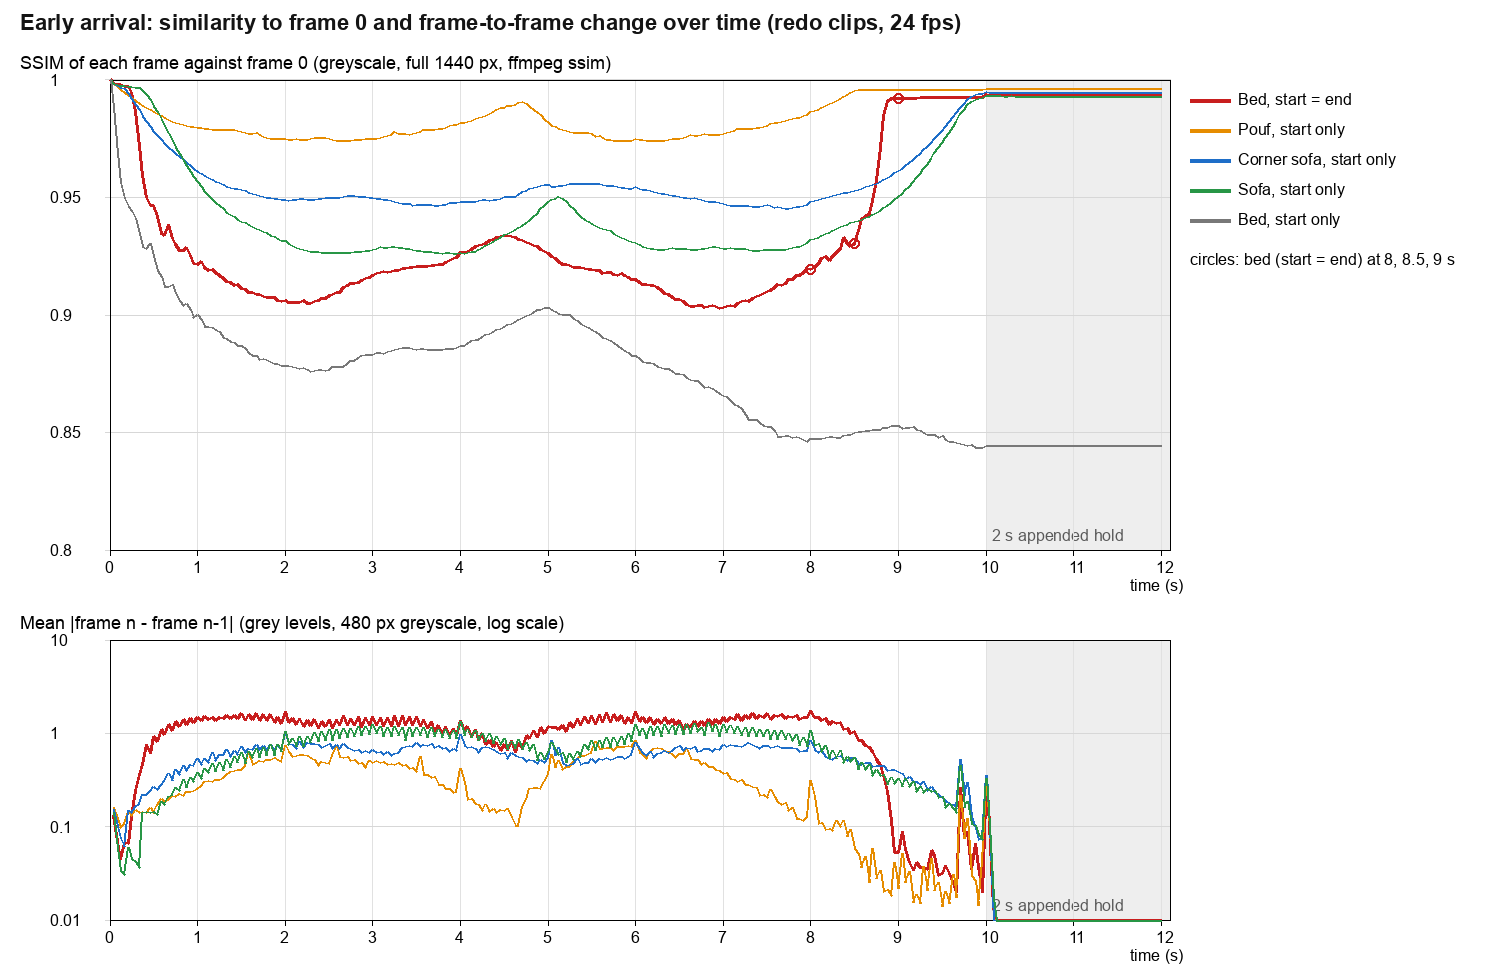
Stand. Im gemessenen Clip wurde das Endbild von Hand gesetzt: Das PNG des komponierten Startbilds wurde in die Felder „Erstes Bild“ und „Letztes Bild“ des Studios gelegt, was den Pfad für ein vom Nutzer gesetztes erstes Bild nimmt statt des automatischen Uploads des komponierten Startbilds. Nach diesem Clip wurde das automatische Senden des komponierten Startbilds als Endbild umgesetzt und ausgeliefert (Abschnitt 4.4): Bei Drehung Auto oder 360° ist es mit „Eigener Bildaufbau“ nun die Voreinstellung. Es gilt nicht für die 270°-Drehung, deren Endpose vom Start abweicht; Schwenk ±90° kehrt zu 0° zurück und könnte es nutzen, wurde aber nicht erprobt und ist ausgenommen. Die Entscheidung zur Auslieferung beruht auf diesem einzelnen Paarvergleich und auf Produkturteil; sie ist kein Beleg für die Wirkung, und die obigen Risiken (keine Drehung, frühe Ankunft) gelten für jeden über den automatischen Pfad erstellten Clip. Bisher ist ein solcher Clip festgehalten (der Sessel unten): Er drehte sich einmal vollständig, kam nicht früh an und behielt den Bildaufbau, während sein Zwilling nur mit Startbild heranfuhr.
Auslieferung. Fünf dieser Clips (alle außer dem driftenden Bett nur mit Startbild) wurden dem Kunden laut Operator als öffentliche Links mit Anleitungen zur Selbstbedienung gesendet. Das Urteil des Kunden liegt noch nicht vor, und nichts in diesem Bericht ist als Abnahme zu verstehen.
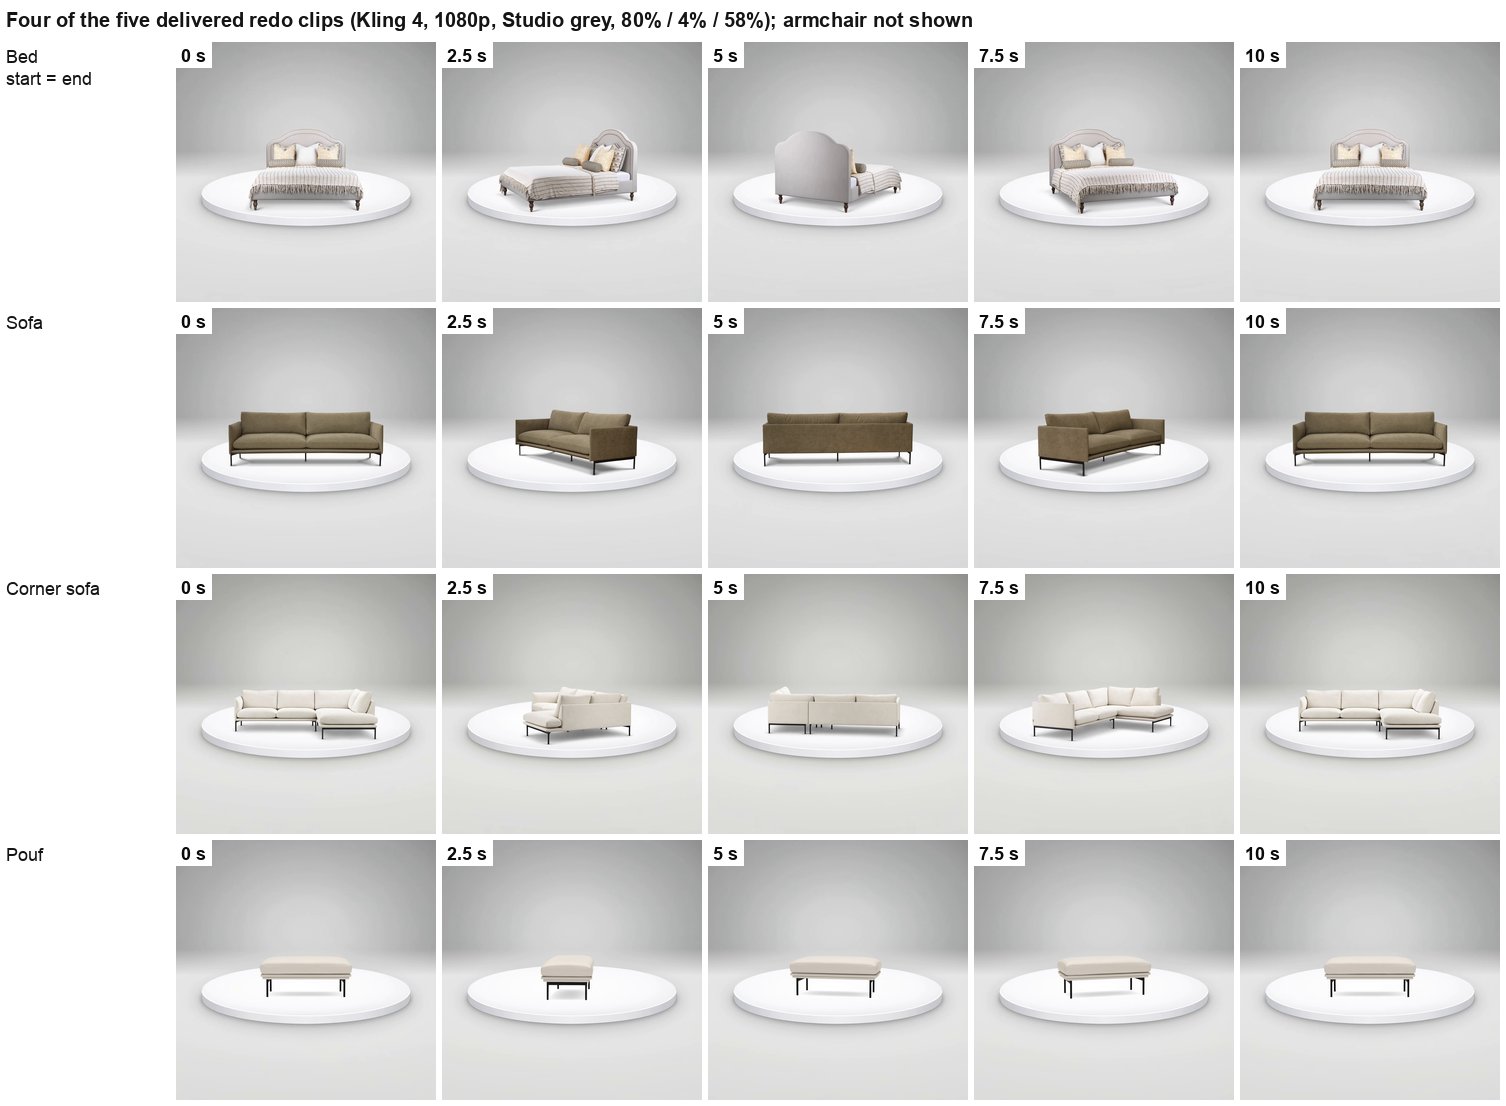
Ein zweites Paar, über den automatischen Pfad erstellt. Kurz nach der Auslieferung des automatischen Endbilds erstellte der Operator im Studio zwei Clips des grünen Sessels aus dem Anker-Experiment (Abschnitt 3) mit identischen Einstellungen: Kling 4 Reference-to-Video, 720p, 1:1, 10 s plus eine Pause von 1 s, Größe 50 %, Drehteller 80 %, Dicke 4 %, Mitte 70 % von oben, Studiograu, Drehung Auto, fünf Fotos (vier im Produkt-Element, eines als einfache Referenz). Der erste entstand vermutlich in einer Studio-Seite, die vor der Auslieferung geladen und nicht neu geladen worden war (die Ladezeit der Seite ist nicht festgehalten); der zweite nach einem Neuladen, mit sichtbaren automatischen Kacheln für erstes und letztes Bild, sodass das komponierte Startbild als Start- und Endbild gesendet wurde. Dass der erste Clip kein Endbild trug, ist aus Zeitablauf und Seitenzustand erschlossen, nicht aus dem Request abgelesen, weil der Generierungsdatensatz nicht zeigt, ob ein Endbild gesendet wurde. Die heruntergeladenen Ausgaben (940 × 940, 265 Frames = Frames 0–240 der 10-s-Quelle plus 24 Pausenkopien) wurden zunächst in Abschnitt 7.7 als nicht zugeordnet bewertet und erst danach anhand des Sitzungsprotokolls diesen beiden Generierungen zugeordnet. Da die Bedingung „nur Start“ des ersten Clips auf einer Schlussfolgerung beruht, ist dies ein ungefähr abgeglichenes Paar, dessen Zuordnung der Bedingungen teilweise auf einer Schlussfolgerung beruht. Gemessen nach dem Protokoll aus Abschnitt 7.7 (E = Frame 240):
| Produkt | Clip | Konditionierung | Tellerbreite über den Clip | Tellermitte über den Clip | Volle Drehung | Frame 0 gegenüber 240: SSIM / MAE |
|---|---|---|---|---|---|---|
| Grüner Sessel | Sessel-Clip nur mit Startbild (Abbildung 27) | nur Start (erschlossen) | 80,1 % bei 0 s, 91,2 % bei 1 s, über beide Bildränder hinaus von 1,25 s bis zum Ende | 70,2 % → 83,1 % (Bereich 70,2–83,3 %) | gedreht, während die Kamera bis zu einer Nahaufnahme heranfuhr; kehrt nie zur frontähnlichen Schwelle aus Abschnitt 7.7 zurück | 0,832 / 24,68 |
| Grüner Sessel | Sessel-Clip mit Start = Ende (Abbildung 27) | Start = Ende (automatisch) | 80,1 % in allen 41 Stichproben (alle 0,25 s) | 70,1–70,2 % | ja, Front → Seite → Rückseite → Seite → Front nach Augenmaß | 0,993 / 1,89 |
Die damaligen Messungen des Operators (alle 0,5 s, Protokoll nicht festgehalten) stimmen in der Richtung überein: 81 %, bis etwa 3 s über die Bildränder hinaus ansteigend, beim Clip nur mit Startbild; 79,9 % und 70 % durchgehend, SSIM erstes gegenüber letztem Bild 0,991 und eine statische Pause von 1 s beim Clip mit Start = Ende. Sie unterscheiden sich darin, wann der Teller die Bildränder erstmals überschreitet (etwa 3 s gegenüber 1,25 s hier); Abschnitt 7.7 verwendet die Werte der Tabelle. Der Clip mit Start = Ende erreichte die frontähnliche Schwelle 0,42 s vor dem letzten Quellframe, kam also nicht früh an (Abschnitt 7.7 zählt ab 1 s). Sein Nahtverhältnis beträgt 4,05 bei einer absoluten Naht von 1,89 Graustufen, weil sich der kleine Sessel pro Frame wenig bewegt (medianer Schritt 0,47); zusammen gelesen, wie Abschnitt 7.7 es verlangt, überzeichnet das Verhältnis den Sprung.
Damit wird die Ein-Variablen-Änderung des Bett-Paars an einem zweiten Produkt wiederholt, bei einer zweiten Auflösung (720p gegenüber 1080p) und einer zweiten Tellerhöhe (70 % gegenüber 58 %) und über den automatischen Pfad statt von Hand, mit demselben Ergebnis: Der Arm nur mit Startbild fuhr heran, der Arm mit Start = Ende behielt den komponierten Bildaufbau. Es bleibt eine Aufnahme pro Arm. Die Drift nur mit Startbild setzte hier früher ein und war stärker als beim Bett; über diese Clips hinweg driftete das Rezept nur mit Startbild in zwei von sechs (dem Bett und diesem Sessel) und hielt in vier.
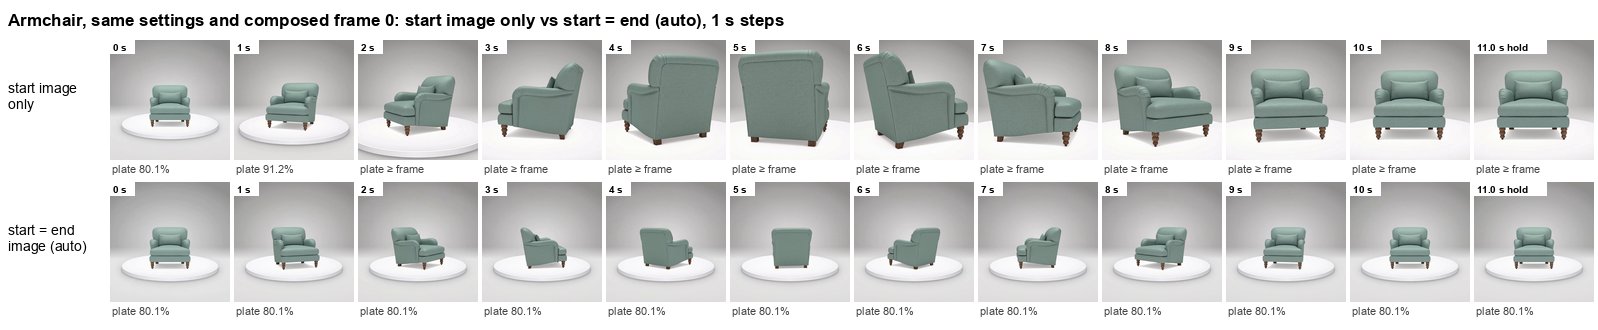
Deutung, auf diese beiden Paare beschränkt. Der Bildaufbau ist eine geometrische Vorgabe (dieselbe Größe an derselben Stelle). Die Bett-Aufnahme nur mit Startbild driftete, obwohl sie neben dem Wortlaut des Prompts bereits das komponierte Startbild trug; die anschließende, am Start und am Ende auf dasselbe Bild konditionierte Aufnahme driftete nicht. Dasselbe geschah beim grünen Sessel bei 720p über den automatischen Pfad. Die Wirkung des Eingriffs und die Quelle der Schwankung bleiben unbekannt: Zwei Paare mit je einer Aufnahme pro Arm können das Endbild nicht von der Schwankung zwischen Aufnahmen trennen. Das ist mit der Hauptbeobachtung des Berichts vereinbar, dass Layout das Modell über Bilder statt über Text erreicht (Abschnitt 12), prüft sie aber nicht; der kontrollierte Test ist Ablation 5 aus Abschnitt 11.
7.7 Retrospektiver Vergleich
Stand. Nachdem die Abschnitte 7.2–7.6 geschrieben waren, wurde jeder lokal verfügbare Drehteller-Clip dieser Arbeit nach einem einheitlichen Protokoll neu bewertet, ausschließlich aus lokalen Dateien, ohne neue Generierung und ohne kostenpflichtigen Dienst. Der Vergleich ist retrospektiv und beobachtend. Die Clips entstanden, bevor es das Protokoll gab, unter gezielt oder adaptiv variierten Einstellungen, meist ein Clip pro Bedingung. Nichts in diesem Abschnitt ist eine Rate, eine Effektstärke oder ein kausales Ergebnis, und wo eine Bedingung n = 1 hat, beschreibt der Wert nur diesen einen Clip. Der Abschnitt beantwortet den in Abschnitt 7.4 genannten Bedarf an einem Protokoll über alle Sätze hinweg; er ersetzt nicht die kontrollierte Auswertung aus Abschnitt 11.
Protokoll (für jeden Clip identisch). Dekodierung: ffmpeg, jeder dekodierte Frame (Passthrough-Timing, keine Duplizierung), flächenskaliert auf 512 × 512 px (alle Clips sind quadratisch), YUV→RGB-Matrix unabhängig vom Tag der Datei auf BT.709 mit begrenztem Bereich erzwungen (einige Dateien sind ohne Tag), 8-Bit-RGB; Grau = 0,2126 R′ + 0,7152 G′ + 0,0722 B′ (die Rec.709-Luma-Gewichte, auf die gammakodierten Werte angewandt), Gleitkomma, 0–255. Komponierte Startbilder: Alpha über Weiß, Flächenskalierung auf 512 px, dieselben Gewichte. Bewegungsende: Das Bewegungssegment umfasst die Frames 0…E, wobei E der letzte Quellframe vor einer angehängten Pause ist. E wird der festgehaltenen Dateistruktur entnommen (Rohausgaben: der letzte Frame; Dateien mit Standbildern: Frame 240 bei einer 10-s-Quelle, 192 und 216 für das Sofa und den Pouf der Produktion). Ein Detektor läuft auf jedem Clip, wird aber nur verwendet, wo nichts festgehalten ist (im endgültigen Satz bei keinem Clip): Eine Pause ist die abschließende Folge von Frames, deren MAE zum Nachbarframe unter 0,03 Graustufen liegt (ein Keyframe-Ausreißer unter 0,25 toleriert), und E ist der Frame vor dieser Folge. Er stimmt bei den Dateien mit Standbildern innerhalb eines Frames mit dem Datensatz überein, verfehlt den Pouf der Produktion (240 statt 216, unterbrochen von zwei Keyframe-Ausreißern) und markiert in der rohen, pausenlosen lokalen Aufnahme 2 ein ruhendes Ende von 16 Frames, das das Modell selbst erzeugte; ein Detektor für ruhende Folgen kann eine angehängte Pause also nicht vom eigenen Anhalten des Modells unterscheiden. Bereiche: ganzes Bild und ein fester Mittelbereich (Zeilen 20–80 %, Spalten 25–75 %; für jeden Clip gleich, keine Produktmaske). Metriken: (1) Endpunkt-SSIM [27] (Gauß-Fenster 11 × 11, σ 1,5, K1 0,01, K2 0,03, L 255, Spiegel-Padding, Mittel über den Bereich) und MAE von Frame 0 gegenüber Frame E; (2) Naht-MAE = MAE(Frame E → Frame 0), der Schritt, den ein Betrachter sieht, wenn das Bewegungssegment loopt, medianer Nachbarschritt innerhalb von 0…E und Nahtverhältnis = Naht-MAE ÷ medianer Schritt (1 = ein gewöhnlicher Schritt; die Bestehensgrenze des Anker-Experiments lag bei ≤ 2,0); bei Dateien mit Standbildern ist dies die Schleife des Bewegungssegments, nicht der Datei mit Standbildern; (3) Drift des Bildaufbaus: ein Teller-Detektor auf jedem 6. Frame (0,25 s) plus E, der die beleuchtete Oberseite des Tellers misst (Breite in % der Bildbreite, Mitte in % der Bildhöhe), validiert an komponierten Bildern bekannter Geometrie (auf 76 / 56 gesetzte Frames ergeben 76,0 / 56,0–56,2; 80 / 58 ergibt 80,1 / 58,1; 80,0 / 77,9 ergibt 80,3 / 79,0), wobei der erste und letzte Bewegungsframe jedes Clips nach Augenmaß geprüft und als ok (20 Clips), Rand (der Teller erreicht einen Bildrand, die Breite ist also eine Untergrenze; 20) oder nicht verlässlich (7) eingestuft wurde und Breiten nur für ok berichtet werden; dazu eine detektorfreie Zeile der Produktoberkante, deren Bereich über den Clip berichtet wird, wo sie gültig ist; (4) Layout gegenüber dem komponierten Startbild, wo es gespeichert war: MAE und SSIM gegenüber Ausgabeframe 0, Differenzen von Tellerbreite und -mitte sowie MAE gegenüber Frame E; (5) eine partielle Drehungsablesung: Mittelbereichs-SSIM jedes 2. Frames gegenüber Frame 0, die den Zeitpunkt geringster Ähnlichkeit ergibt, eine frontähnliche Schwelle (min + 0,8 (1 − min)), wie viele Sekunden vor E der Clip sie wieder erreicht (frühe Ankunft), Stichproben in der Clipmitte oberhalb der Schwelle und das ruhende Ende innerhalb des Bewegungssegments. Ablesung (5) misst keine Richtung: Eine Umkehr, die nie die Front passiert, ist für sie unsichtbar, und die eigene Umkehr-Metrik des Anker-Experiments wird zitiert, nicht neu berechnet.
Clips. Nach Entfernen bytegleicher Duplikate wurden 46 Clips bewertet, die den Gruppen dieses Berichts zugeordnet sind (zwei davon, das Sessel-Paar aus Abschnitt 7.6, zunächst als nicht zugeordnet bewertet und danach ihren Generierungen zugeordnet, wobei der Endframe dann ihren Einstellungen entnommen wurde); Dateien, die sich keiner festgehaltenen Generierung zuordnen ließen, wurden von jedem Vergleich ausgeschlossen. Für das Anker-Experiment wurden die Rohausgaben des Anbieters bewertet statt späterer Neucodierungen.
| Gruppe | n | Endpunkt-SSIM, ganzes Bild: Median [Min–Max] | Endpunkt-MAE, ganzes Bild | Nahtverhältnis |
|---|---|---|---|---|
| Vorlagenbeispiele der Plattform | 2 | 0,514 [0,183–0,846] | 52,04 [6,30–97,78] | 31,84 [3,06–60,62] |
| Eigene erste Clips des Kunden | 5 | 0,906 [0,717–0,989] | 6,52 [1,46–16,46] | 3,11 [0,96–8,24] |
| Tests mit Prompt v8 | 6 | 0,910 [0,849–0,969] | 4,16 [1,51–11,72] | 2,40 [0,55–12,92] |
| Aufnahmen mit verborgener Ebene | 5 | 0,904 [0,775–0,989] | 3,75 [1,17–16,21] | 1,01 [0,34–5,67] |
| Ausgangslage, kein komponiertes Startbild (Abschnitt 7.2) | 4 | 0,930 [0,860–0,988] | 4,21 [1,54–5,51] | 1,99 [0,91–2,24] |
| Generierter Referenzsatz aus vier Ansichten | 1 | 0,967 | 1,93 | 2,49 |
| Anker-Experiment, Bedingung A (nur Prompt) | 3 | 0,899 [0,784–0,919] | 7,61 [7,08–21,65] | 10,55 [5,26–14,10] |
| Anker-Experiment, Bedingung B (Start- und Endbild) | 3 | 0,996 [0,986–0,996] | 1,79 [1,73–1,93] | 1,98 [1,56–2,20] |
| Anker-Experiment, Bedingung C (verkettet) | 3 | 0,994 [0,993–0,994] | 4,06 [3,47–4,69] | 5,52 [4,90–6,00] |
| Lokale Aufnahmen mit komponiertem Startbild | 3 | 0,995 [0,985–0,996] | 1,36 [1,12–1,58] | 3,29 [0,70–4,16] |
| Produktion, komponiertes Startbild (Abschnitt 7.3) | 4 | 0,995 [0,994–0,997] | 0,66 [0,41–1,24] | 1,15 [1,09–1,43] |
| Neuaufnahme, nur Startbild (Abschnitt 7.6) | 4 | 0,996 [0,803–0,996] | 0,69 [0,44–16,08] | 1,29 [0,96–10,39] |
| Neuaufnahme, Start- und Endbild (Abschnitt 7.6) | 1 | 0,996 | 0,50 | 0,41 |
| Sessel-Paar, nur Startbild (Abschnitt 7.6) | 1 | 0,832 | 24,68 | 11,78 |
| Sessel-Paar, Start- und Endbild, automatisch (Abschnitt 7.6) | 1 | 0,993 | 1,89 | 4,05 |
Die Gruppen fassen Clips zusammen, die sich in Produkt, Modell, Auflösung, Prompt und Einstellungen unterscheiden (Abbildung 28). Die MAE-Werte des Anker-Experiments reproduzieren dessen eigene Endpunktdifferenzen (21,8 / 7,7 / 7,2; 2,1 / 1,9 / 1,9; 3,5 / 3,9 / 4,5) innerhalb von 0,2 Graustufen, bei anderer Dekodierung und Größe.
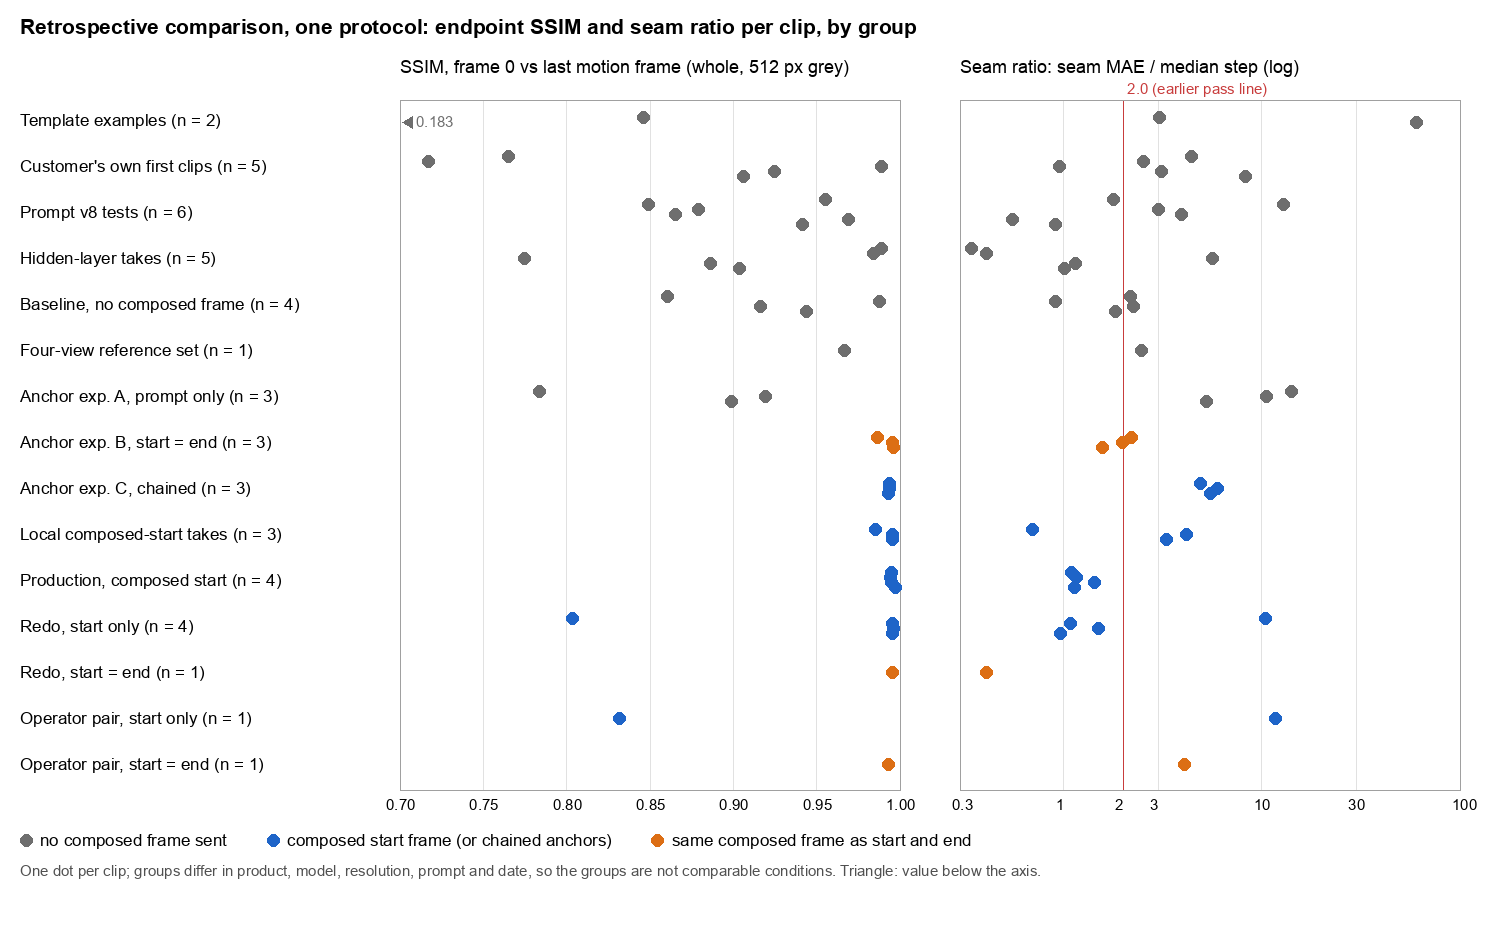
Nahezu abgeglichene Paare. Nur sechs Vergleiche im gesamten Satz unterscheiden sich in einem festgehaltenen Faktor. Jeder hat n = 1 pro Arm, außer dem Vergleich im Anker-Experiment (n = 3 pro Arm). P3 und P6 prüfen dieselbe Änderung, das komponierte Startbild zusätzlich als Endbild, an zwei Produkten und bei zwei Auflösungen, von Hand und automatisch gesetzt. Nicht festgehaltene Unterschiede (Seed, Zustand beim Anbieter) sind in jedem Paar unkontrolliert.
| # | Paar | Der eine festgehaltene Faktor, der sich unterscheidet | Gleich gehalten | Endpunkt-SSIM / MAE / Nahtverhältnis | Bildaufbau und Layout | Drehungsablesung |
|---|---|---|---|---|---|---|
| P1 | Anker-Experiment, Bedingung A gegenüber Bedingung B (n = 3 + 3) | komponierter Front-Frame als Start- und Endbild gesendet (Requests ansonsten identisch) | Kling 3.0 Omni 720p ohne Ton 10 s, grüner Sessel, fünf Fotos, Prompt-Text | A 0,784 / 0,920 / 0,899; 21,65 / 7,61 / 7,08; 14,1 / 10,5 / 5,3. B 0,986 / 0,996 / 0,996; 1,93 / 1,79 / 1,73; 2,20 / 1,98 / 1,56 | B Teller 80,1 % / 79,0 % in jeder Stichprobe; A Teller nicht verlässlich (zwei Clips) oder über den Bildrand hinaus (einer); Bereich der Produktoberkante A 15,0 / 2,7 / 3,1 Punkte, B 2,0 / 1,2 / 1,2; MAE Frame 0 gegenüber komponierter Front A 24,7 / 24,2 / 24,2 (Front nicht gesendet), B 2,4 / 2,8 / 3,1 | ein B-Clip hat 2 frontähnliche Stichproben in der Clipmitte, vereinbar mit seinem festgehaltenen Überschießen; das festgehaltene Zurückschwingen eines A-Clips ist für diese Ablesung nicht sichtbar |
| P2 | Lokale Aufnahme 1 gegenüber Aufnahme 2 | komponierte Scheibe flach gezeichnet gegenüber schattiert | Kling 4 720p 10 s, Sessel, Größe 50 / Teller 76 / Mitte 56 / Dicke 3, Endpunkt, Prompt, Einstellungen | 0,985 gegenüber 0,995; 1,12 gegenüber 1,58; 0,70 gegenüber 4,16 | Aufnahme 1 Teller über den Bildrand hinaus (die eigene Komposition des Modells), MAE Frame 0 gegenüber komponiert 54,4, Breite +24,0 Punkte; Aufnahme 2 76,0–76,2 % / 56,2–56,7 %, MAE 3,4, Breite 0,0 | Aufnahme 2 hat ein vom Modell erzeugtes ruhendes Ende von 0,6 s, das ihren medianen Schritt senkt und ihr Nahtverhältnis aufbläht |
| P3 | Neuaufnahme Bett, nur Startbild gegenüber Start- und Endbild | dasselbe komponierte Startbild zusätzlich als Endbild gesendet (von Hand gesetzt) | Kling 4 1080p 10 s + 2 s Pause, zweites Bettmodell, Teller 80 / 4 / 58, Studiograu, Prompt wie gemeldet | 0,803 gegenüber 0,996; 16,08 gegenüber 0,50; 10,4 gegenüber 0,41 | nur Start: 80,1 % bei 0 s, dann über beide Bildränder hinaus, Mitte 58,1 → 63,2 %; Start und Ende: 79,7–80,1 % / 57,5–59,2 %; MAE Frame 0 gegenüber komponiert 4,09 gegenüber 3,17, Frame E gegenüber komponiert 14,57 gegenüber 3,17 (komponiertes Bild mutmaßlich, Abbildung 22) | Start und Ende: frontähnliche Schwelle 1,17 s vor E erreicht |
| P4 | Sessel-Tests mit Prompt v8, T4 gegenüber T4b | Referenzsatz: fünf Fotos (das fünfte als separate Referenz geleitet) gegenüber vier Fotos im Element | Kling 4 720p 10 s, Prompt v8, grüner Sessel | 0,969 gegenüber 0,941; 1,51 gegenüber 2,30; 0,55 gegenüber 0,91 | beide Teller über die Bildränder hinaus (n. a.) | T4 beginnt und endet auf der Rückseite (Abschnitt 3.1), seine besseren Endpunktwerte prüfen die Startpose also nicht |
| P5 | Blaues Sofa mit Prompt v8 auf Kling 3.0 Omni gegenüber Kling 4 | Modell (und damit Ausgabegröße, 960 gegenüber 940 px, und Ton je Modell) | Prompt v8, blaues Sofa, Fotos, 720p, 10 s | 0,849 gegenüber 0,879; 11,72 gegenüber 5,89; 12,9 gegenüber 3,0 | beide Teller an den Bildrändern (n. a.) | keiner kehrt zur frontähnlichen Schwelle zurück |
| P6 | Sessel-Paar, nur Startbild gegenüber Start- und Endbild | das komponierte Startbild zusätzlich als Endbild gesendet (automatisch; sein Fehlen im Clip nur mit Startbild ist erschlossen, Abschnitt 7.6) | Kling 4 720p 10 s + 1 s Pause, grüner Sessel, fünf Fotos, Größe 50, Teller 80 / 4 / 70, Studiograu, Drehung Auto | 0,832 gegenüber 0,993; 24,68 gegenüber 1,89; 11,8 gegenüber 4,05 (medianer Schritt 2,09 gegenüber 0,47, daher wirkt die Naht von 1,89 Stufen als Verhältnis hoch) | nur Start: 80,1 % bei 0 s, 91,2 % bei 1 s, ab 1,25 s über beide Bildränder hinaus, Mitte 70,2 → 83,1 % (Bereich 70,2–83,3 %); Start und Ende: 80,1 % / 70,1–70,2 % in allen 41 Stichproben; komponiertes Bild nicht gespeichert | nur Start kehrt nie zur frontähnlichen Schwelle zurück; Start und Ende erreicht sie 0,42 s vor E, keine frontähnliche Stichprobe in der Clipmitte |
Jeder andere Vergleich unterscheidet sich in mehr als einem festgehaltenen Faktor: lokale Aufnahme 2 gegenüber Aufnahme 3 (Kontaktschatten, eine neue Motion-Zeile und die Pause im Browser, gebündelt); Anker-Bedingungen B gegenüber C (Verkettung, Segment-Prompt, End-Anker, Länge); Ausgangslage gegenüber Produktion je Produkt (komponiertes Startbild, Prompt-Ebene, Hintergrund, Größe, Teller, Länge und Pause); Produktion gegenüber Neuaufnahme je Produkt (Hintergrund, Dicke, Mitte, Größe, Pause, Schatten, Stand des Prompts); die Neuaufnahme-Clips nur mit Startbild untereinander (nur das Produkt, aber n = 1 pro Produkt, sodass sich Unterschiede nicht von der Schwankung zwischen Aufnahmen trennen lassen); die beiden Clips des Kunden mit dem cremefarbenen Sofa (Modell, Länge, Ton); die Tests mit Prompt v8 gegenüber Bedingung A (Produkt, Fotos, Modell, Zusammenstellung des Requests); die Bedingungen A/B gegenüber dem Neuaufnahme-Bett mit Start- und Endbild (Modell, Auflösung, Produkt, Composer, Hintergrund, Prompt); und die Aufnahmen mit verborgener Ebene untereinander (Version der Ebene, Produkt, Auflösung, Drehmodus).
Ablesungen, auf das beschränkt, was die Zahlen zeigen. Endpunktähnlichkeit allein trennt die Probleme nicht: Eine Aufnahme mit verborgener Ebene, für die eine Umkehr bei 180° festgehalten ist, erreicht eine Endpunkt-SSIM von 0,989 (MAE 1,17), den höchsten Wert außerhalb der Gruppen mit komponiertem Startbild; T4, das auf der Rückseite beginnt und endet, schlägt T4b bei jedem Endpunktwert; Schwenk-Clips, die zur Front zurückkehren, schneiden wie Schleifen ab. Endpunkt-SSIM und -MAE prüfen nur, dass der letzte Bewegungsframe dem ersten ähnelt, nichts über die Drehung. Innerhalb der beobachteten Clips haben die Clips mit einem komponierten Startbild, dem das Modell folgte (Bedingungen B und C, lokale Aufnahmen 2–3, Produktion, die Neuaufnahme-Clips außer dem Bett nur mit Startbild und der Sessel-Clip mit Start- und Endbild; n = 17), eine Endpunkt-SSIM von 0,986–0,997 und eine MAE von 0,41–4,69, und die Clips nur mit Prompt (Kunde, Tests mit Prompt v8, Aufnahmen mit verborgener Ebene, Ausgangslage, Clip mit Referenzen aus vier Ansichten, Bedingung A; n = 24) eine SSIM von 0,717–0,989 und eine MAE von 1,17–21,65; Produkt, Modell, Auflösung, Prompt und Datum unterscheiden sich alle zwischen diesen Gruppen, das beschreibt also die Stichprobe, keine Wirkung. Drift des Bildaufbaus wurde sowohl ohne komponiertes Startbild gesehen (die Produktoberkante eines Clips der Bedingung A bewegt sich um 15 Punkte; der Teller eines anderen liegt über dem Bild hinaus) als auch mit einem (die Arme nur mit Startbild von P3 und P6). Von den 20 Clips mit verwertbarer Tellerablesung halten 16 die Tellerbreite innerhalb von 0,8 Punkten und die Mitte innerhalb von 1,7 Punkten über das Bewegungssegment; die beiden Sofas der Produktion bewegen sich um 2,3–2,5 Punkte in der Breite und 2,1–4,0 in der Mitte, plausibel, weil das Sofa in Seitenansichten die breiteste Zeile des Tellers verdeckt (eine Einschränkung des Detektors, nicht als Kamerabewegung gezeigt); das Bett der Neuaufnahme nur mit Startbild (20,7 Punkte Breite und 5,1 Mitte, bevor der Teller das Bild verlässt) und der Sessel nur mit Startbild (19,9 und 13,1, ab 1,25 s über das Bild hinaus) sind die beiden Heranfahrten unter den bewerteten Clips, und in beiden Paaren hielt der Zwilling mit Start- und Endbild den Teller. Das Nahtverhältnis hängt davon ab, wie schnell sich ein Clip bewegt: Die verketteten Clips der Bedingung C (medianer Schritt etwa 0,7) ergeben 4,9–6,0 bei Nähten von 3,5–4,7 Graustufen, und das vom Modell erzeugte ruhende Ende der lokalen Aufnahme 2 ergibt 4,16, sodass Verhältnis und absolute Naht-MAE zusammen gelesen werden müssen. Frühe Ankunft (frontähnliche Schwelle mindestens 1 s vor E erreicht) zeigt sich beim Neuaufnahme-Bett mit Start- und Endbild (1,17 s), beim Neuaufnahme-Pouf (1,75 s) und bei einer Aufnahme mit verborgener Ebene (1,00 s); der automatische Sessel mit Start- und Endbild erreicht sie erst 0,42 s vor E, von den beiden Clips mit Start- und Endbild kam also einer früh an und einer nicht.
Wo diese Werte von Werten an anderer Stelle dieses Berichts abweichen. Keiner der früheren Werte wird ersetzt; jeder gehört zu seinem eigenen Protokoll, und die Werte sind zwischen Protokollen nicht austauschbar.
- Neuaufnahme-Clips, Frame 0 gegenüber Frame 240: Dieses Protokoll (512 px, die obige SSIM-Implementierung auf Rec.709-Grau) ergibt 0,996 für das Bett mit Start- und Endbild, das Sofa, den Pouf und das Ecksofa sowie 0,803 für das Bett nur mit Startbild. Die Prüfung aus Abschnitt 7.6 (ffmpeg
ssim, Y, 1440 px, Frame 240) ergibt 0,994 / 0,994 / 0,997 / 0,995 / 0,845; die Werte des Operators (Protokoll nicht festgehalten) sind 0,993 für das Bett mit Start- und Endbild und innerhalb von 0,993–0,996 für die Clips nur mit Startbild. - Neuaufnahme-Clips, Frame 0 gegenüber Frame 240, MAE: 0,44–0,79 für die vier ausgelieferten Clips und 16,08 für das Bett nur mit Startbild hier, gegenüber 0,48–0,89 und 16,54 in Abschnitt 7.6 und Abbildung 21 (die Graustufen-Dekodierung des Abbildungssatzes).
- Komponiertes Bett-Startbild gegenüber der Ausgabe: Frame 0 MAE 4,09 (nur Start) und 3,17 (Start und Ende), Frame E 14,57 und 3,17 hier, gegenüber 3,08 / 2,13 und 15,20 / 2,11 in Abbildung 22 (der Vergleich des Abbildungssatzes in dessen eigener Größe).
- Sessel-Paar: Clip mit Start- und Endbild, SSIM Frame 0 gegenüber Frame 240 hier 0,993 gegenüber 0,991 des Operators (Protokoll nicht festgehalten); Clip nur mit Startbild, Teller hier ab 1,25 s über die Bildränder hinaus gegenüber etwa 3 s in den 0,5-s-Stichproben des Operators.
- Tellergeometrie der vier ausgelieferten Neuaufnahme-Clips: 79,3–80,1 % Breite und 57,0–59,2 % Mitte über die Drehung nach diesem Detektor, gegenüber 80,1 % / 58,1 % des Operators in jeder Stichprobe (Abschnitt 7.6).
- Frühe Ankunft: das Bett mit Start- und Endbild 1,17 s und der Pouf 1,75 s vor E hier, gegenüber etwa 1 s und 1,5 s aus den Einzel-SSIM-Werten des Operators und aus Abschnitt 7.6.
- Endpunkt-MAE der Produktion: Ecksofa 0,62 und Pouf 0,41 hier, gegenüber 0,92 und 0,57 in Abschnitt 7.3 (Protokoll nicht festgehalten); Sessel (0,70) und Sofa (1,24), in Abschnitt 7.3 nicht einzeln festgehalten, werden hier gemessen, sodass der Bereich über die vier Clips nach diesem Protokoll 0,41–1,24 beträgt, gegenüber intern gemeldeten 0,57–1,79.
- Endpunkt-SSIM der Ausgangslage: 0,860–0,988 hier (das Sofa hat 0,988), gegenüber 0,85–0,97 in Abschnitt 7.2 (das eigene Protokoll der Ausgangslage).
- Lokale Aufnahme 3: 0,996 hier gegenüber 0,98 in Abschnitt 7.3.
- MAE des Anker-Experiments: innerhalb von 0,2 Graustufen seiner eigenen Endpunktdifferenzen (oben).
- Nahtverhältnis von T4 und T4b: 0,55 und 0,91 hier, gegenüber 0,49 und 0,88 (ganzes Bild) in der Kalibrierung des Anker-Experiments und 1,0 und 1,5 (mittiger Ausschnitt) in der früheren Analyse (Abschnitt 3.1).
Vorbehalte. Der Vergleich ist beobachtend: Jeder Clip ist älter als das Protokoll, und kein Clip wurde erstellt, um es zu prüfen. Die Gruppen sind konfundiert: Produkt, Modell, Auflösung, Prompt-Version, Komposition, Hintergrund und Datum ändern sich zwischen ihnen gemeinsam, sodass Unterschiede zwischen Gruppen weder dem komponierten Startbild noch irgendetwas anderem zugeschrieben werden können. Endpunkt-SSIM allein führt in die Irre: Eine umgekehrte Aufnahme erreicht 0,989, und eine auf der Rückseite gestartete Aufnahme (T4) schlägt ihr Gegenstück, daher werden Endpunktwerte zusammen mit den Ablesungen zu Bildaufbau, Naht und Drehung sowie mit den Frames selbst gelesen. Die Zellen sind klein: n = 3 pro Arm in P1, n = 1 pro Arm in P2–P6 (die Endbild-Änderung hat zwei solche Paare, an zwei Produkten), n = 1 für jeden Clip mit Start- und Endbild aus Abschnitt 7.6 und ein Clip pro Produkt in der Neuaufnahme-Gruppe nur mit Startbild. Der Teller-Detektor misst die beleuchtete Oberseite und kann bei schattierten Tellern einige Punkte zu schmal ablesen, und Produkte, die die breiteste Zeile des Tellers verdecken, verschieben die gewählte Zeile; die Drehungsablesung misst keine Richtung. Zwei in dieser Arbeit besprochene Clips haben keine lokale Kopie und werden nicht bewertet (der Clip mit numerischer Layout-Zeile und der Neuaufnahme-Sessel), und für die Produktionsclips und die Neuaufnahme-Clips nur mit Startbild wurden keine komponierten Startbilder gespeichert, sodass die Layout-Ablesung für sie nicht verfügbar ist. Aus keiner dieser Zahlen wird eine kausale Aussage abgeleitet.
8. Vergleich mit Alternativen
8.1 Erprobte Ansätze (Einzelheiten in Abschnitt 3)
| Ansatz | R1 Größe | R2 Eingrenzung | R3 Endpunkte | Umkehr | Bewegte Sequenz vom Modell generiert | Status |
|---|---|---|---|---|---|---|
| Prompt-Formulierung und verborgene Ebenen (Kling 3.0 Omni, Kling 4) | nicht kontrolliert | beim Ecksofa gescheitert | SSIM 0,85–0,97, vor der Front | — | ja | verworfen |
| Nur numerische Layout-Zeile (Kling 4, 1 Clip) | ignoriert | — | — | — | ja | verworfen |
| Komponiertes Startbild mit Start = Ende (Kling 3.0 Omni, 3 Clips) | 3/3 innerhalb von 3 % | 3/3, 16 Frames nach Augenmaß | 3/3 ≤ 4 Graustufen | 1/3 schoss über und kehrte zurück | ja | eingestellt |
| Vier verkettete 90°-Clips (Kling 3.0 Omni, 3 Clips, 12 Anbieteraufrufe) | 3/3 | 3/3, 16 Frames nach Augenmaß | 2/3 ≤ 4 Graustufen | 1/3 umgekehrt | ja | eingestellt |
| Generierter Referenzsatz aus vier Ansichten (Kling 4, 1 Clip) | — | in abgetasteten Frames keines gesehen | Endpunkte nahe der Front, nicht deckungsgleich | — | ja; strukturelle Drift | verworfen |
| 3D-Rendering | in einer korrekt eingerichteten Szene explizit steuerbar | steuerbar (Szene und Kamerabahn) | steuerbar (periodische Kamerabahn) | steuerbar | nein | nicht durchgeführt |
| Komponiertes Startbild (Kling 4, ausgeliefert) | vom Nutzer in Frame 0 eingestellt; Layout in 6/6 ungefähr befolgt, Hintergrund in 3/4 Produktionsclips erhalten; Neuaufnahme-Durchlauf: Frame 0 in 5/5 befolgt, danach driftete der Bildaufbau in 1/5 (Bett), bis der Teller das Bild verließ | 4/4 keines in abgetasteten Frames gesehen | MAE 0,57–1,79, 4/4 (intern gemeldet); Neuaufnahme SSIM 0,993–0,996 in 4/5, Bett am Ende 25 % größer | 0 in Standardrichtung gesehen; 1/1 Nicht-Standardrichtung ignoriert | ja | live |
| Komponiertes Startbild als Start- und Endbild (Kling 4, 2 Clips: Bett von Hand gesetzt, Sessel automatisch) | Bildaufbau in jeder auswertbaren Stichprobe in beiden erhalten (zwei verdeckte Seitenansichten des Betts ausgeschlossen) | nicht gesondert bewertet | SSIM 0,993 Bett (Operator), 0,993 Sessel (Protokoll aus Abschnitt 7.7), teils die Konditionierung selbst; Bett erreichte die Front etwa 1 s zu früh, dann nahezu still; Sessel nicht früh | volle Drehung in beiden, bei der verwendeten Abtastung keine gesehen; nicht gemessen | ja | automatisch bei Auto / 360° seit demselben Abend; ein Clip über den automatischen Pfad festgehalten (der Sessel) |
Schwellen und Produkte unterscheiden sich zwischen den Zeilen, die Tabelle ist also kein kontrollierter Vergleich. Die Bedingung Start = Ende mit Kling 3.0 Omni erfüllte in ihren drei Clips die drei gleichen benannten Mängel unter ihren eigenen Schwellen; sie scheiterte am zusätzlichen Umkehr-Kriterium, und die Arbeit mit diesem Modell wurde eingestellt. Mit Eigener Bildaufbau und einem Freisteller gibt es nun drei Anfragepfade: das komponierte Startbild nur als Startbild (270° und Schwenk oder ein Modell ohne Endbild); das komponierte Startbild als Startbild plus dasselbe Bild als automatisches Endbild (Auto und 360°); und das komponierte Startbild als Startbild plus ein vom Nutzer bereitgestelltes Endbild, was weiterhin eine Endbild-Konditionierung bewirkt, aber den automatischen Endpunkt überschreibt und hier nicht getestet ist. Ein vom Nutzer gesetztes erstes Bild ersetzt das komponierte Startbild vollständig. Die ausgelieferte Methode wurde als technischer Kompromiss gewählt: ein neueres Modell, eine einzige Generierung pro Clip, eine für den Nutzer sichtbare Vorschau und keine beobachtete Umkehr in der Standardrichtung, um den Preis einer nicht gemessenen Rate.
8.2 3D-gerenderte Drehteller
Eine 3D-Plattform rendert die Drehung aus einem 3D-Modell; der Artikel von Cylindo beschreibt das Rendern von „32 frames of the product rotating 360 degrees while the camera remains static“ [25]. Mit einem genauen Modell werden Maßstab, Eingrenzung, Schleifenschluss, Drehbereich und Bildaufbau explizit steuerbar, sie ergeben sich aber nicht schon aus dem Rendern: Sie gelten nur in einer korrekt eingerichteten Szene, mit einem gemeinsamen physischen Maßstab und den realen Abmessungen jedes Produkts, mit einem Produkt, das gegenüber der Grundfläche der Plattform platziert und geprüft ist (bei keinem Winkel ragt ein Teil über den Tellerrand), und mit einer periodischen Bahn, deren letzter abgetasteter Winkel einen Schritt vor dem ersten liegt, sodass der Übergang stetig ist. Der Preis ist die Modellierung jedes Produkts samt Materialien. Dieser Weg wurde konzipiert, nicht getestet (Abschnitt 3.1). Für diesen Kunden lagen keine 3D-Dateien vor, und Foto-zu-3D-Generatoren erraten verdeckte Oberflächen.
8.3 Fotografierte Drehsets
Ein mit einer Kamera synchronisierter motorisierter Drehteller, etwa die Turning Platform von PhotoRobot [26], deren Seite „software-driven controls“ beschreibt, die „ensure smooth turntable rotation in sync with precise camera capture“, für Produkte einschließlich Möbeln, nimmt das reale Produkt in festen Winkeln mit fester Kamera auf. Das erfordert für jede SKU das physische Möbelstück, ein Studio und Handhabung. Die Seite belegt die synchronisierte Aufnahme; eine pixelgenaue Schleife belegt sie für sich allein nicht.
8.4 Andere KI-Videotools
Die Arten von Evidenz werden getrennt gehalten. Dokumentierte Funktionen: Die Hilfeseiten zum Product Animator von Photoroom [22, 23] beschreiben bis zu vier Referenzbilder, per Vorlage gewählte Bewegung, Seitenverhältnis und einen Prompt, der „designed for adding extra details or making minor changes“ ist, wobei Fotos mittig auf die gewählte Form zugeschnitten werden; die von uns gelesenen Seiten beschreiben keine Steuerung für Größe, Position, Drehteller, Drehbereich oder Schleife, was nicht belegt, dass dem Produkt eine solche fehlt. Der Nutzerleitfaden von Kling zu Kling 4 [20] beschreibt im Eintrag Keyframes erste, letzte, Start-und-Ende- und mittlere Bilder getrennt von Referenz-Assets; er ist keine Spezifikation des kombinierten Reference-to-Video-Endpunkts von fal. Herstellerangaben: Der Artikel von Higgsfield [24] gibt an, dass seine Engine „inherits the exact product geometry and lighting from the uploaded hero frame“; das ist eine Behauptung des Herstellers, keine Validierung desselben Mechanismus oder derselben Treue. Nicht untersucht: die Weboberflächen von Runway, Pika, Kling und anderen Produktvideo-Tools; Ausschnitte aus Suchergebnissen wurden nicht als Vergleichsevidenz verwendet. Wir behaupten nicht, dass RefVid das einzige Tool mit dieser Steuerung ist.
9. Verwandte Arbeiten
Bildkonditionierte Videogenerierung. Stable Video Diffusion [1] trainiert latente Video-Diffusion für die Bild-zu-Video-Generierung; DynamiCrafter [2] speist ein Eingabebild über eine textausgerichtete Kontextrepräsentation und durch Verkettung mit dem Anfangsrauschen ein. Diese Arbeiten begründen die Verwendung eines komponierten Bildes als Träger des Layouts; über einen kommerziellen Reference-to-Video-Endpunkt, bei dem ein Startbild mit Subjektreferenzen konkurriert, sagen sie nichts aus, und unser Fehlschlag mit der flachen Scheibe zeigt, dass die Treue dort nicht selbstverständlich ist.
Keyframe- und Schleifenkonditionierung. Generative Inbetweening [3] verschmilzt Vorwärts- und Rückwärtsdurchläufe eines vortrainierten Bild-zu-Video-Modells, um Frames zwischen zwei Keyframes zu generieren; zwischen den Ankern synthetisiert das Modell die Bewegung weiterhin selbst. Mobius [4] erzeugt nahtlose Schleifen, indem es die Latents als Zyklus behandelt; DreamLoop [5] verwendet das Eingabebild für Cinemagraphs sowohl als Bedingung für das erste als auch für das letzte Bild. Beide verändern Sampling oder Training und sind auf dem von uns genutzten Endpunkt nicht verfügbar; wir übernehmen ihre Verwendung des Fehlers zwischen erstem und letztem Bild als Schleifenmaß, mit dem Hinweis (Abschnitt 7.3), dass der Endpunktfehler allein die Stetigkeit der Naht nicht misst.
Neuansichten, Orbits und Subjektkonsistenz über mehrere Ansichten. Zero-1-to-3 [6], Zero123++ [7] und SV3D [8] generieren aus einem Bild neue Ansichten oder Orbits eines Objekts; die nicht sichtbaren Seiten werden erschlossen. Das veröffentlichte Modell von SV3D gibt 21 Frames mit 576 × 576 aus, unterhalb der erforderlichen Auflösung. MV-S2V [9] verwendet mehrere Referenzansichten eines Subjekts für 3D-konsistentes Video (veröffentlichtes Modell in 480p); OmniShowcase [10] ergänzt Konditionierung auf Oberflächennormalen und Training mit synthetischen Orbits, wobei der Inferenzcode zum Zeitpunkt der Durchsicht als geplant aufgeführt war. Keines davon wurde ausgeführt. Beide sind mit unserer Entscheidung vereinbar, weiterhin alle echten Fotos als Referenzen zu senden und das komponierte Startbild nur für die Endpunkte zu verwenden (den Start und bei vollen Drehungen auch das Ende).
Räumliche und Kamerasteuerung. CameraCtrl [11] und MotionCtrl [12] fügen trainierte Module für Kamera- oder Bewegungssteuerung hinzu. CamTrol [13] kommt ohne Training aus: Es rendert das Layout des Eingabebildes im 3D-Punktwolkenraum neu und baut aus dem Ergebnis die verrauschten Latents eines vortrainierten Video-Diffusionsmodells auf. ViewCrafter [14] konditioniert ein Video-Diffusionsmodell für die Synthese neuer Ansichten auf punktbasierte 3D-Renderings entlang einer geplanten Kamerabahn. I2VControl [15] vereint Kamera-, Zieh- und Bewegungspinsel-Steuerung für Bild-zu-Video. VACE [16] fasst Referenz-, Bearbeitungs- und Maskeneingaben zu einer Bedingungseinheit für einen Diffusion Transformer zusammen; mit Wan-basierten ComfyUI-Workflows kann es Referenzbilder mit Tiefen- oder anderen Steuervideos kombinieren, was ein möglicher Weg ist, Struktur über das erste Bild hinaus vorzugeben, allerdings geeignete Steuervideos erfordert. Ein Drehteller unterscheidet sich von einem Kamera-Orbit: Das Objekt dreht sich, während Licht, Kamera und Hintergrund in der Welt fest bleiben. Sein Schlagschatten ist nicht fest: Unter festen Lichtquellen ändert sich die Form des Schattens mit der Ausrichtung des Objekts, und er dreht sich auch nicht einfach mit dem Objekt mit. Orbit-Methoden lassen sich daher nicht unverändert übertragen.
Diese Methoden unterscheiden sich entlang dreier getrennter Fragen: wie die Methode entwickelt wurde, ob veröffentlichte Gewichte oder Inferenzcode existieren und welchen Zugang ein Anwender für ihre Nutzung braucht. CameraCtrl, MotionCtrl, I2VControl, SV3D, MV-S2V und OmniShowcase wurden durch Training oder Feinabstimmung von Modulen oder Modellen entwickelt; wo Gewichte veröffentlicht sind (zum Beispiel bei SV3D und MV-S2V), lassen sie sich bei der Inferenz ohne erneutes Training nutzen, wobei ein neues Basismodell oder eine neue Domäne eine Feinabstimmung erfordern kann. CamTrol kommt ohne Training aus, arbeitet aber wie die Konditionierung nach Art von DynamiCrafter auf den Latents des Modells. VACE läuft auf offenen Modellgewichten. Alle erfordern im Allgemeinen Zugang zu geeigneten Modellgewichten und einer Inferenz-Pipeline. Unser Szenario ist eine Black-Box-API, bei der sich nur Start-, Mittel- und Endbilder, Referenzen und Text ändern lassen. Die Komposition der Eingabe ist die Form räumlicher Konditionierung, die auf dieser Zugangsebene verfügbar ist.
3D-Rekonstruktion. 3D Gaussian Splatting [17] rekonstruiert Szenen aus kalibrierten Aufnahmen aus mehreren Ansichten; drei oder vier Katalogfotos bieten nicht die Abdeckung, die das Verfahren voraussetzt.
Bewertung. VBench [18] zerlegt Videoqualität in getrennte Dimensionen (Subjektkonsistenz, Bewegungsglätte, zeitliches Flimmern und weitere) mit Validierung anhand menschlicher Präferenzen. Es begründet, Treue, Glätte und zeitliche Konsistenz getrennt zu bewerten; einen Ersatz für aufgabenspezifische geometrische Prüfungen wie Eingrenzung und Endpunktpose bietet es nicht.
10. Einschränkungen
- Explorative Stichprobe. Vier Produktionsclips (einer pro Produkt, jeder mit anderen Einstellungen), zwei erfolgreiche lokale Clips mit Kling 4, sechs Anker-Clips mit Kling 3.0 Omni und sechs Neuaufnahme-Clips mit gemeinsamen Einstellungen (fünf nur mit Startbild, einer mit Start = Ende, Abschnitt 7.6); unverblindet, adaptiv, keine zurückgehaltenen Produkte. Es lässt sich keine Rate angeben.
- Reproduzierbarkeit. Zwei Endpunktwerte der Produktion und das Messprotokoll des Produktionstags sind nicht festgehalten; der Sessel-Clip der Produktion ist nur über einen späteren Datensatz identifiziert (Abschnitt 7.3). Das Skript des Anker-Experiments verwendet den aktuellen Prompt-Builder und die aktuelle Preisgestaltung, ein erneuter Lauf muss den historischen Request also nicht reproduzieren; rohe Anker-Ausgaben wurden nicht archiviert, und die archivierten Clips sind neu codierte Kopien, was für kleine Pixeldifferenzen eine Rolle spielt. Ob eine serverseitige Prompt-Ebene in späteren Produktionsgenerierungen Teile von Prompt v9 überschrieb, ist nicht festgehalten (Abschnitt 3.1). Das Modell des Anbieters kann sich ohne reproduzierbaren Checkpoint ändern.
- Maßstab. Die Größenregel normalisiert die Belegung pro Form; die Proportion zwischen Produkten hängt von den Einstellungen des Nutzers ab (Abschnitt 4.3).
- Generische Grundflächen. Jede Form verwendet eine Grundfläche; das reale W × D eines Produkts wird nicht verwendet.
- Einzelne Freisteller-Ansicht. Nur das Frontfoto wird komponiert; die gezeichnete Scheibe wird aus 14° gesehen, während die Fotos nahe Augenhöhe liegen, sodass hohe oder tiefe Möbelstücke eine Perspektivabweichung zeigen können. Die Kontaktpunkte des 2D-Freistellers werden nicht ermittelt, und die Kamera ist nicht kalibriert.
- Nicht fail-closed. Ein Fehlschlag von Komposition oder Upload führt auf eine unkonditionierte Generierung zurück; ein Fehlschlag der Standbild-Pause hinterlässt den Rohclip.
- Richtung. Angeboten wird nur der Uhrzeigersinn; eine Anfrage gegen den Uhrzeigersinn wurde ignoriert.
- Langsamer Start. Ausgehend von einem stehenden komponierten Startbild dreht sich die erste Sekunde in den geprüften Clips langsam.
- Drift des Bildaufbaus nach Frame 0. Dem komponierten Layout in Frame 0 zu folgen, hält es nicht fest: Zwei von sechs Clips nur mit Startbild (ein Bett und ein Sessel) fuhren heran, bis der Teller das Bild verließ (Abschnitt 7.6), und die Kamera-Zeile des Prompts verhinderte dies nicht. Ob die Drift produktspezifisch oder zufällige Schwankung ist, ist unbekannt, ebenso, welche Produkte gefährdet sind. Die beiden Clips mit Start = Ende, die nicht drifteten, sind Einzelaufnahmen an zwei Produkten; die Wirkung ist nicht belegt, und das Risiko, dass identische Start- und Endbilder die Drehung unterdrücken, wurde durch zwei volle Drehungen nicht ausgeschlossen. Start = Ende ist dennoch die Voreinstellung bei Auto und 360°, sodass diese Risiken nun für den ausgelieferten Pfad gelten, für den bisher ein Clip festgehalten ist.
- Frühe Ankunft. Zwei der fünf ausgelieferten Neuaufnahme-Clips (das Bett mit Endbild, der Pouf ohne; das driftende Bett nur mit Startbild wurde nicht bewertet) erreichten die Frontpose 1–1,5 s vor dem Ende der Drehung und standen nahezu still, sodass mit der Pause von 2 s die sichtbare Pause beim Bett etwa 3 s und beim Pouf 3,5 s betrug (Abschnitt 7.6). Ursache und Häufigkeit sind unbekannt; das Abschneiden des ruhenden Segments ist eine mögliche, nicht umgesetzte Abhilfe.
- Nicht oder kaum getestet. Betten (zwei Clips des zweiten Bettmodells, einer pro Bedingung, Abschnitt 7.6; korrigierte Fotos des Betts der Kollektion gingen nicht ein), 9:16 und 16:9, asymmetrische Objekte, schwierige Materialien, komponiertes
end_image_urlüber zwei Clips hinaus, einer von Hand gesetzt und einer über den automatischen Pfad (je n = 1; im automatischen Pfad für Auto und 360° verdrahtet; nicht anwendbar auf 270°; Schwenk ±90° nicht erprobt und ausgenommen),middle_image_urlsbei Kling 4 (die aktuelle Implementierung gibt keine Zwischenbilder weiter), automatisierte Prüfungen der Eingrenzung pro Frame. - Neuaufnahme-Messungen nicht nachprüfbar. Die Tellerbreiten, -mitten und SSIM-Werte aus Abschnitt 7.6 sind vom Operator gemeldet, und die Messdateien sind nicht verfügbar; nur drei Clips sind heruntergeladenen Dateien über den Namen zugeordnet und die beiden Bett-Dateien über den Inhalt; vom Neuaufnahme-Sessel gibt es keine heruntergeladene Kopie.
- Überarbeiteter Frame 0 nicht verglichen. Die sechs Neuaufnahme-Clips verwendeten den Hintergrund Studiograu; ob ihr Frame 0 auch den übernommenen Fotoschatten enthielt, ist nicht festgehalten, und es wurde kein Vergleich von Schattierungsvarianten durchgeführt. Vor ihnen waren die Wahl des Hintergrunds, der Wegfall der gezeichneten Grundflächen-Ellipse und der übernommene Fotoschatten (Abschnitt 5) in keiner Generierung verwendet worden; die Clips mit komponiertem Startbild auf Kling 4 in den Abschnitten 7.3–7.5 (die lokalen Aufnahmen und die Produktionsclips) wurden aus dem früheren Frame mit gezeichneten Schattenformen erstellt, die Anker-Frames wurden von separaten Skripten komponiert, und die Ausgangslage (Abschnitt 7.2) hatte kein komponiertes Startbild. Die eigenen Grenzen des übernommenen Schattens sind in Abschnitt 5.6 aufgeführt.
- Abnahme durch den Kunden ausstehend. Die Antwort des Kunden auf die erste Lieferung verlangte vier Anpassungen (Abschnitt 3.1). Fünf Neuaufnahme-Clips mit dem Hintergrund Studiograu und festen Einstellungen wurden laut Operator am selben Tag gesendet; das Urteil des Kunden liegt noch nicht vor.
- Werkzeuge für den Katalog. Benannte Voreinstellungen und Stapelverarbeitung für einen großen Katalog sind nicht umgesetzt.
11. Geplante Auswertung (künftige Arbeit)
Nichts in diesem Abschnitt wurde durchgeführt.
Design. 20–30 unterschiedliche Produkte (Sofas, Sessel, Ecksofas, Poufs, Betten sowie asymmetrische Objekte und schwierige Materialien wie glänzende, transparente oder fein texturierte Artikel), von der Entwicklung zurückgehalten, × 3–5 Wiederholungen pro Hauptbedingung, wobei die endgültigen Zahlen per Poweranalyse anhand der Varianz der Pilotstudie festgelegt werden. Die Analyse clustert nach Produkt; Frames sind keine unabhängigen Stichproben. Bewertungen von Eingrenzung, struktureller Treue und Sichtbarkeit der Naht durch verblindete unabhängige Annotatoren.
Vergleichsbedingungen und Ablationen, mit abgeglichenen Eingaben, Budgets und Einstellungen:
- Vergleichsbedingung nur mit Referenzen und demselben endgültigen Prompt.
- Numerischer Layout-Prompt ohne komponiertes Startbild.
- Komponiertes Startbild mit und ohne die Layout-Zeile.
- Flache gegenüber schattierter Komposition, alles andere fest und die Reihenfolge randomisiert.
- Nur Start gegenüber Start = Ende bei Kling 4, mit dem komponierten Startbild sowohl als
start_image_urlals auch alsend_image_urlgesendet (Abschnitt 7.6), mindestens 3–5-mal pro Produkt über alle Produkttypen wiederholt, die tiefsten und höchsten Möbelstücke eingeschlossen, mit identischen Einstellungen und identischem Prompt. Messgrößen: Tellerbreite und Tellermitte in jedem Frame (mit der Kennzeichnung „nicht auswertbar“, wo das Produkt die breiteste Zeile des Tellers verdeckt) und der Anteil driftender Clips; Erkennung vollständiger Drehungen und von Umkehrungen bei voller Bildrate, einschließlich Clips, die sich nicht drehen oder sich nur teilweise drehen und zurückkehren; Endpunktähnlichkeit, berichtet mit dem Vorbehalt, dass die Konditionierung mit Start = Ende eine Zielvorgabe ist, die Übereinstimmung der Endpunkte begünstigt (keine Garantie und mit nicht gemessenem Beitrag), weshalb die Bewegungskontinuität über den Übergang gesondert bewertet wird; sowie der Zeitpunkt, zu dem die Frontpose erreicht wird, und die Länge eines etwaigen ruhenden Segments vor dem Ende der Drehung (frühe Ankunft, Abschnitt 7.6). Da Start = Ende nun die Voreinstellung bei Auto und 360° ist, muss der Arm nur mit Startbild gezielt erzeugt und als solcher gekennzeichnet werden. Eine Variante, die ein erkanntes frühes ruhendes Segment abschneidet, bevor die Standbild-Pause angehängt wird, wird, falls umgesetzt, mit denselben Messgrößen bewertet. Optional komponierte Zwischenanker übermiddle_image_urlssowie Schwenk ±90° mit Start = Ende. - Startbild allein gegenüber Startbild plus Referenzen aus mehreren Ansichten.
- Ein zweites kompatibles Videomodell und ein relevanter kommerzieller Workflow.
- Produktschatten in Frame 0: keiner gegenüber aus dem Foto übernommen (und als Referenz die gezeichnete Ellipse), alles andere fest, an Produkten mit nahezu rechteckigen und L-förmigen Grundflächen; gemessen als plausibler Kontakt zwischen Produkt und Teller, Beleuchtung im Einklang mit festen Lichtquellen, unerwünschte Restspuren auf dem Teller und Layout-Treue. Ein Schatten, der sich starr mit dem Produkt dreht, oder einer, der fest bleibt, wird als beobachtetes Verhalten festgehalten, nicht als bestanden gezählt.
- Hintergrund: Hell gegenüber Studiograu, gemessen als Erhalt des Hintergrunds (Hintergrund des ersten Ausgabebilds gegenüber dem komponierten), getrennt von der Layout-Treue berichtet.
- Kantenqualität des übernommenen Schattens: gerenderte Beispiele mit weichem Alpha, farbige Verunreinigung der Kanten, Abschneiden am Bereichsrand und Beschnitt an der Tellergrenze, mit einer Metrik für den Kantenbereich (ein Band um die weiche Kante des Freistellers) statt eines Mittelwerts über das ganze Bild.
Weitere Versuche. Eine Variante mit festem physischem Maßstab (gemeinsamer Tellerdurchmesser, reale SKU-Abmessungen) mit Messung der Breitenverhältnisse zwischen Produkten; Tests des Reglerverhaltens (folgt die Ausgabegröße s monoton); 9:16 und 16:9; Standbild-Pausen mit Bruchteilen und vorangestellte Standbild-Pausen; Clips mit Standbildern und Ton.
Messgrößen, ein versioniertes Protokoll, gleichermaßen auf alte und neue Clips angewandt: MAE und SSIM über das ganze Bild und im Produktbereich bei angegebenem Farbraum und angegebener Auflösung; Fehler der Endpunktpose; Bewegungsunstetigkeit über den Übergang im Vergleich zur eigenen Verteilung benachbarter Frames des Clips, ohne Standbild-Pausen, pro Clip; Verletzungen der Eingrenzung mit definierten Sichtbarkeitsausschlüssen und einer Kategorie „nicht auswertbar“, geprüft an allen Frames oder mit begründeter Stichprobe; Erkennung vollständiger Drehungen und von Umkehrungen; Latenz; Kosten pro akzeptablem Clip einschließlich Wiederholungen und Zeit des Operators. Rohdateien und Dateien mit Standbildern werden getrennt gekennzeichnet, und für jeden Clip werden die Anfrage in der gesendeten Form (einschließlich des ausgefüllten Prompts), das komponierte Startbild und die Referenzbilder sowie die einzelnen Bewertungen aufbewahrt.
12. Fazit
Für diese Aufgabe vermittelte Text dem Modell keine Geometrie: Formulierungen, numerische Layout-Anweisungen und verborgene Prompt-Ebenen steuerten in unseren Tests weder Größe noch Eingrenzung noch Endpunktpose. Bei einem komponierten Startbild – dem eigenen Freisteller des Produkts auf einem fotografisch schattierten Drehteller mit vom Nutzer eingestellten Parametern – folgte Kling 4 dem Layout von Produkt und Plattform in jedem beobachteten Fall mit schattierter Scheibe ungefähr, nach Augenmaß; der komponierte Hintergrund blieb in 3 der 4 Produktionsclips erhalten, Layout-Treue ist also keine Übereinstimmung des gesamten Bildes. In diesen vier Clips wurde in abgetasteten Frames kein Teil über dem Rand gesehen, und die gemeldete Endpunktdifferenz war gering. Standbild-Pausen werden nach der Generierung deterministisch hinzugefügt, wenn die Verarbeitung im Browser gelingt. Was das System steuert, ist das Eingabebild und die Konsistenz der Platzierung auf dem Drehteller über Produkte hinweg; die Proportion zwischen Produkten überlässt es dem Nutzer und alles nach Frame 0 dem Modell. Zwei spätere Clips zeigten, was damit offen bleibt: Frame 0 wurde befolgt, und dann fuhr die Kamera heran, bis der Teller das Bild verließ (ein Bett und ein Sessel, der mutmaßlich nur mit Startbild erstellt wurde, bevor das automatische Endbild die Seite des Operators erreichte; das ist erschlossen, nicht festgehalten); in beiden Fällen driftete eine Aufnahme, bei der dasselbe komponierte Startbild auch als Endbild diente, nicht. Die Wirkung des Eingriffs und die Quelle der Schwankung bleiben unbekannt. Das Endbild wurde seither als technische Entscheidung zur Voreinstellung bei Auto und 360° gemacht; es konditioniert beide Enden des Clips auf das komponierte Startbild und überlässt die Bewegung dazwischen, einschließlich früher Ankunft an der Front und einer vollen Drehung, dem Modell. Mit dem Hintergrund Studiograu wurde ein graues Studio in allen sechs Neuaufnahme-Clips vom Operator gemeldet, für diesen Bericht in den fünf heruntergeladenen Dateien zugeordneten gesehen, und an den gemessenen Punkten nahe an der angepassten Referenz; dieser Satz wird getrennt von den früheren 3 von 4 berichtet. Die Neuaufnahme-Clips liegen beim Kunden, dessen Urteil aussteht. Ob das beobachtete Verhalten als Rate, über Produkte und Formate hinweg und gegenüber einfacheren Vergleichsbedingungen Bestand hat, ist Gegenstand der geplanten Auswertung.
Literatur
- [1]A. Blattmann, T. Dockhorn, S. Kulal, D. Mendelevitch, et al. "Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets." arXiv:2311.15127, 2023. https://arxiv.org/abs/2311.15127 (read 2026-11-13)
- [2]J. Xing, M. Xia, Y. Zhang, H. Chen, W. Yu, et al. "DynamiCrafter: Animating Open-domain Images with Video Diffusion Priors." arXiv:2310.12190, 2023. https://arxiv.org/abs/2310.12190 (read 2026-11-13)
- [3]X. Wang, B. Zhou, B. Curless, et al. "Generative Inbetweening: Adapting Image-to-Video Models for Keyframe Interpolation." ICLR 2025; arXiv:2408.15239. https://arxiv.org/abs/2408.15239 (read 2026-11-13)
- [4]X. Bi, J. Yuan, B. Liu, et al. "Mobius: Text to Seamless Looping Video Generation via Latent Shift." arXiv:2502.20307, 2025. https://arxiv.org/abs/2502.20307 (read 2026-11-13)
- [5]A. Mahapatra, L. Mai, C. Ham, F. Liu. "DreamLoop: Controllable Cinemagraph Generation from a Single Photograph." arXiv:2601.02646, 2026. https://arxiv.org/abs/2601.02646 (read 2026-11-13)
- [6]R. Liu, R. Wu, B. Van Hoorick, et al. "Zero-1-to-3: Zero-shot One Image to 3D Object." arXiv:2303.11328, 2023. https://arxiv.org/abs/2303.11328 (read 2026-11-13)
- [7]R. Shi, H. Chen, Z. Zhang, et al. "Zero123++: a Single Image to Consistent Multi-view Diffusion Base Model." arXiv:2310.15110, 2023. https://arxiv.org/abs/2310.15110 (read 2026-11-13)
- [8]V. Voleti, C.-H. Yao, M. Boss, A. Letts, et al. "SV3D: Novel Multi-view Synthesis and 3D Generation from a Single Image using Latent Video Diffusion." arXiv:2403.12008, 2024. https://arxiv.org/abs/2403.12008 (read 2026-11-13); model card https://huggingface.co/stabilityai/sv3d (reviewed 2026-11-11)
- [9]Z. Song, X. Gong, B. Liu, Z. Zhao. "MV-S2V: Multi-View Subject-Consistent Video Generation." arXiv:2601.17756, 2026. https://arxiv.org/abs/2601.17756 (read 2026-11-13); code https://github.com/Szy-Young/MV-S2V (reviewed 2026-11-11)
- [10]J. Ahn, G. Kim, K. Kim, et al. "OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images." arXiv:2610.35684, 2026. https://arxiv.org/abs/2610.35684 (read 2026-11-13)
- [11]H. He, Y. Xu, Y. Guo, et al. "CameraCtrl: Enabling Camera Control for Text-to-Video Generation." arXiv:2404.02101, 2024. https://arxiv.org/abs/2404.02101 (read 2026-11-13)
- [12]Z. Wang, Z. Yuan, X. Wang, T. Chen, M. Xia, et al. "MotionCtrl: A Unified and Flexible Motion Controller for Video Generation." SIGGRAPH 2024; arXiv:2312.03641. https://arxiv.org/abs/2312.03641 (read 2026-11-13)
- [13]C. Hou, Z. Chen. "Training-free Camera Control for Video Generation" (CamTrol). arXiv:2406.10126, 2024. https://arxiv.org/abs/2406.10126 (abstract read 2026-11-13)
- [14]W. Yu, J. Xing, L. Yuan, W. Hu, et al. "ViewCrafter: Taming Video Diffusion Models for High-fidelity Novel View Synthesis." arXiv:2409.02048, 2024. https://arxiv.org/abs/2409.02048 (abstract read 2026-11-13)
- [15]W. Feng, T. Qi, J. Liu, M. Sun, et al. "I2VControl: Disentangled and Unified Video Motion Synthesis Control." ICCV 2025; arXiv:2411.17765. https://wanquanf.github.io/I2VControl (project page read 2026-11-13)
- [16]Z. Jiang, Z. Han, C. Mao, J. Zhang, et al. "VACE: All-in-One Video Creation and Editing." arXiv:2503.07598, 2025. https://arxiv.org/abs/2503.07598 (abstract read 2026-11-13); code https://github.com/ali-vilab/VACE (reviewed 2026-11-11)
- [17]B. Kerbl, G. Kopanas, T. Leimkühler, G. Drettakis. "3D Gaussian Splatting for Real-Time Radiance Field Rendering." ACM Transactions on Graphics 42(4), 2023; arXiv:2308.04079. https://arxiv.org/abs/2308.04079 (read 2026-11-13)
- [18]Z. Huang, Y. He, J. Yu, F. Zhang, et al. "VBench: Comprehensive Benchmark Suite for Video Generative Models." arXiv:2311.17982, 2023. https://arxiv.org/abs/2311.17982 (abstract read 2026-11-13)
- [19]fal.ai, Kling 4 reference-to-video API and llms.txt. https://fal.ai/models/kling/v4/reference-to-video/api and https://fal.ai/models/kling/v4/reference-to-video/llms.txt (read 2026-11-13)
- [20]Kling AI, "Kling 4 model user guide." https://kling.ai/quickstart/kling-4-model-user-guide (read 2026-11-13, first 100,000 characters)
- [21]fal.ai, Bria background removal (RMBG 2.0). https://fal.ai/models/fal-ai/bria/background/remove (read 2026-11-13)
- [22]Photoroom Help, "How to use Product Animator." https://help.photoroom.com/en/articles/16013315-how-to-use-product-animator (read 2026-11-13)
- [23]Photoroom Help, "Troubleshooting Product Animator videos." https://help.photoroom.com/en/articles/17704481-troubleshooting-product-animator-videos (read 2026-11-13)
- [24]Higgsfield, "Best way to create a cinematic 360-degree orbit shot with AI." https://geo.higgsfield.ai/blog/best-way-create-cinematic-360-degree-orbit-shot-ai (read 2026-11-13)
- [25]Cylindo blog, "3D product visualization for furniture e-commerce." https://blog.cylindo.com/3d-product-visualization-furniture-ecommerce (read 2026-11-13)
- [26]PhotoRobot, "Turning Platform." https://www.photorobot.com/robots/turning-platform (read 2026-11-13)
- [27]Z. Wang, A. C. Bovik, H. R. Sheikh, E. P. Simoncelli. "Image Quality Assessment: From Error Visibility to Structural Similarity." IEEE Transactions on Image Processing 13(4), 600–612, 2004. https://doi.org/10.1109/TIP.2003.819861
Anhang A. Prompt wie erzeugt (v9, Kling 4, Eigener Bildaufbau, Drehung Auto, im Uhrzeigersinn)
{…} werden aus den Einstellungen gefüllt; die Scene-Zeile enthält die Worte des Nutzers (standardmäßig den Text der Vorlage).
Scene: {name}, matching the reference appearance and proportions, is on a circular white studio turntable against a light grey seamless background, under soft even studio light, with the entire product in sharp focus.
Layout: Use these layout settings throughout: the turntable's full projected horizontal width is {plate}% of frame width. Its top-surface centre is {position}% of frame height down from the top edge. It is a low, flat, solid disc of uniform vertical thickness, {thickness}% of its physical diameter, with a plain white top and nothing rising from it except the product's own legs. The product's farthest point horizontally from the disc's centre is {size}% of the disc's radius. At 0°, align the midpoints of the product's full frame-left/frame-right and camera-near/camera-far spans with the disc's centre.
Rotation: Frame 1 shows the product at exactly 0°, the first reference orientation, front facing the camera, before any rotation. Product and disc spin in place together as one rigid body about the disc's centre. During the first quarter-turn, the frame-right half moves toward the camera and the frame-left half moves away. Keep the same direction throughout; never reverse. Each quarter of the clip covers 0° to 90°, 90° to 180° (full rear view), 180° to 270°, then 270° to 360°, respectively. At exactly 360° in the final frame, the product exactly matches frame 1 in pose, position, size and shape.
Camera: One uninterrupted shot; camera position, aim, focal length, focus, aperture and crop stay constant.
Motion: Frame 1 is already turning at full speed: constant angular speed from first to final frame, with no ease-in at the start and no ease-out at the end; never stop, accelerate or slow down.
Product: The product is rigid: no stretching, bending, morphing, melting, or parts appearing or disappearing. Shape, dimensions, parts, materials, colours and disc-relative pose stay unchanged. The disc stays level, flat and in place.
„The video is silent.“ wird nur bei ausgeschaltetem Ton an die Product-Zeile angehängt. Die Drehsätze für 270° und Schwenk sind hier nicht wiedergegeben. Die Zeilen Camera und Motion sowie der Standardtext der Product-Zeile entfallen, wenn die Worte des Nutzers auf die Themen-Schlüsselwortmuster passen, wobei der Stille-Satz bei ausgeschaltetem Ton erhalten bleibt (Abschnitt 4.6); zudem entfallen Zeilen bei Überschreitung des Längenlimits des Modells, Layout zuletzt. Ob eine serverseitige Prompt-Ebene die in der Produktion tatsächlich gesendeten Dreh- und Bewegungssätze verändert hat, ist nicht dokumentiert (Abschnitt 3.1).
Anhang B. Einstellungen der ausgewerteten Clips
Produktionsclips (Kling 4, 1080p, 1:1, Ton an, heller Hintergrund):
| Produkt | Länge | Größe | Drehteller im Bild | Dicke | Mitte von oben | Pause danach |
|---|---|---|---|---|---|---|
| Sessel (anhand eines späteren Datensatzes identifiziert; Abschnitt 7.3) | 10 s | 60 % | 80 % | 4 % | 58 % | 2 s |
| Ecksofa | 10 s | 90 % | 80 % | 4 % | 70 % | 2 s |
| Sofa (gegen den Uhrzeigersinn angefordert) | 8 s | 80 % | 80 % | 10 % | 50 % | 1 s |
| Pouf | 9 s | 51 % | 80 % | 5 % | 60 % | 3 s |
Neu erstellte Clips (Abschnitt 7.6): Kling 4 Reference-to-Video, 1080p, 1:1, 10 s + 2 s Standbild-Pause, Drehteller 80 %, Dicke 4 %, Mitte 58 %, Studiograu, für jedes Stück. Geliefert: zweites Bettmodell mit dem komponierten Startbild zusätzlich als Endbild, Sessel, Sofa, Ecksofa, Pouf (Abbildung 26 zeigt alle außer dem Sessel). Nicht geliefert und ohne öffentlichen Link: der Bett-Clip nur mit Startbild. Die tatsächlich verwendeten Größenwerte je Stück sind nicht dokumentiert (die Werte des Plans waren Sessel 60, Ecksofa 90, Sofa 80, Pouf 51, Bett 90).
Clips der Ausgangsbasis (Abschnitt 7.2): Kling 4, 1080p, 1:1, 10 s, Drehung Auto, kein komponiertes Startbild, keine Standbild-Pause: Sessel, Sofa, Pouf, Ecksofa (Abbildung 19).
Zusammen mit dem festgelegten Rezept festgehaltene Empfehlung: ein einziger Wert für die Mittenhöhe für alle Produkte (55–60 %; 58–62 % für hohe Stücke oder Größen ≥ 70 %), wobei pro Produkt nur die Größe geändert wird.
Die lokalen Durchgänge, die Clips des Anker-Experiments, der Clip mit Referenzen aus vier Ansichten und der Clip mit numerischer Layout-Zeile haben keine öffentlichen Links.
Anmerkung des Autors
Ein Reproduzierbarkeitspaket (Requests pro Clip wie gesendet, komponierte und Referenzbilder, Roh- und Standbild-Ausgaben, Einzelbewertungen und Messbefehle) ist geplant und noch nicht verfügbar.
Beispielvideos werden verlinkt, sobald der Kunde der Veröffentlichung zustimmt.